
 Contact

AIゲーム開発研究室
第17回 高精細AIモデルをゲーム用モデルへ軽量化する
AIゲーム開発研究室
3Dモデル制作ドキュメント
第17回 高精細AIモデルをゲーム用モデルへ軽量化する
― HDモデルからQuadリトポロジー、Triangle化までの検証 ―
研究代表 大川 博
主任研究員 Arc(ChatGPT)
はじめに
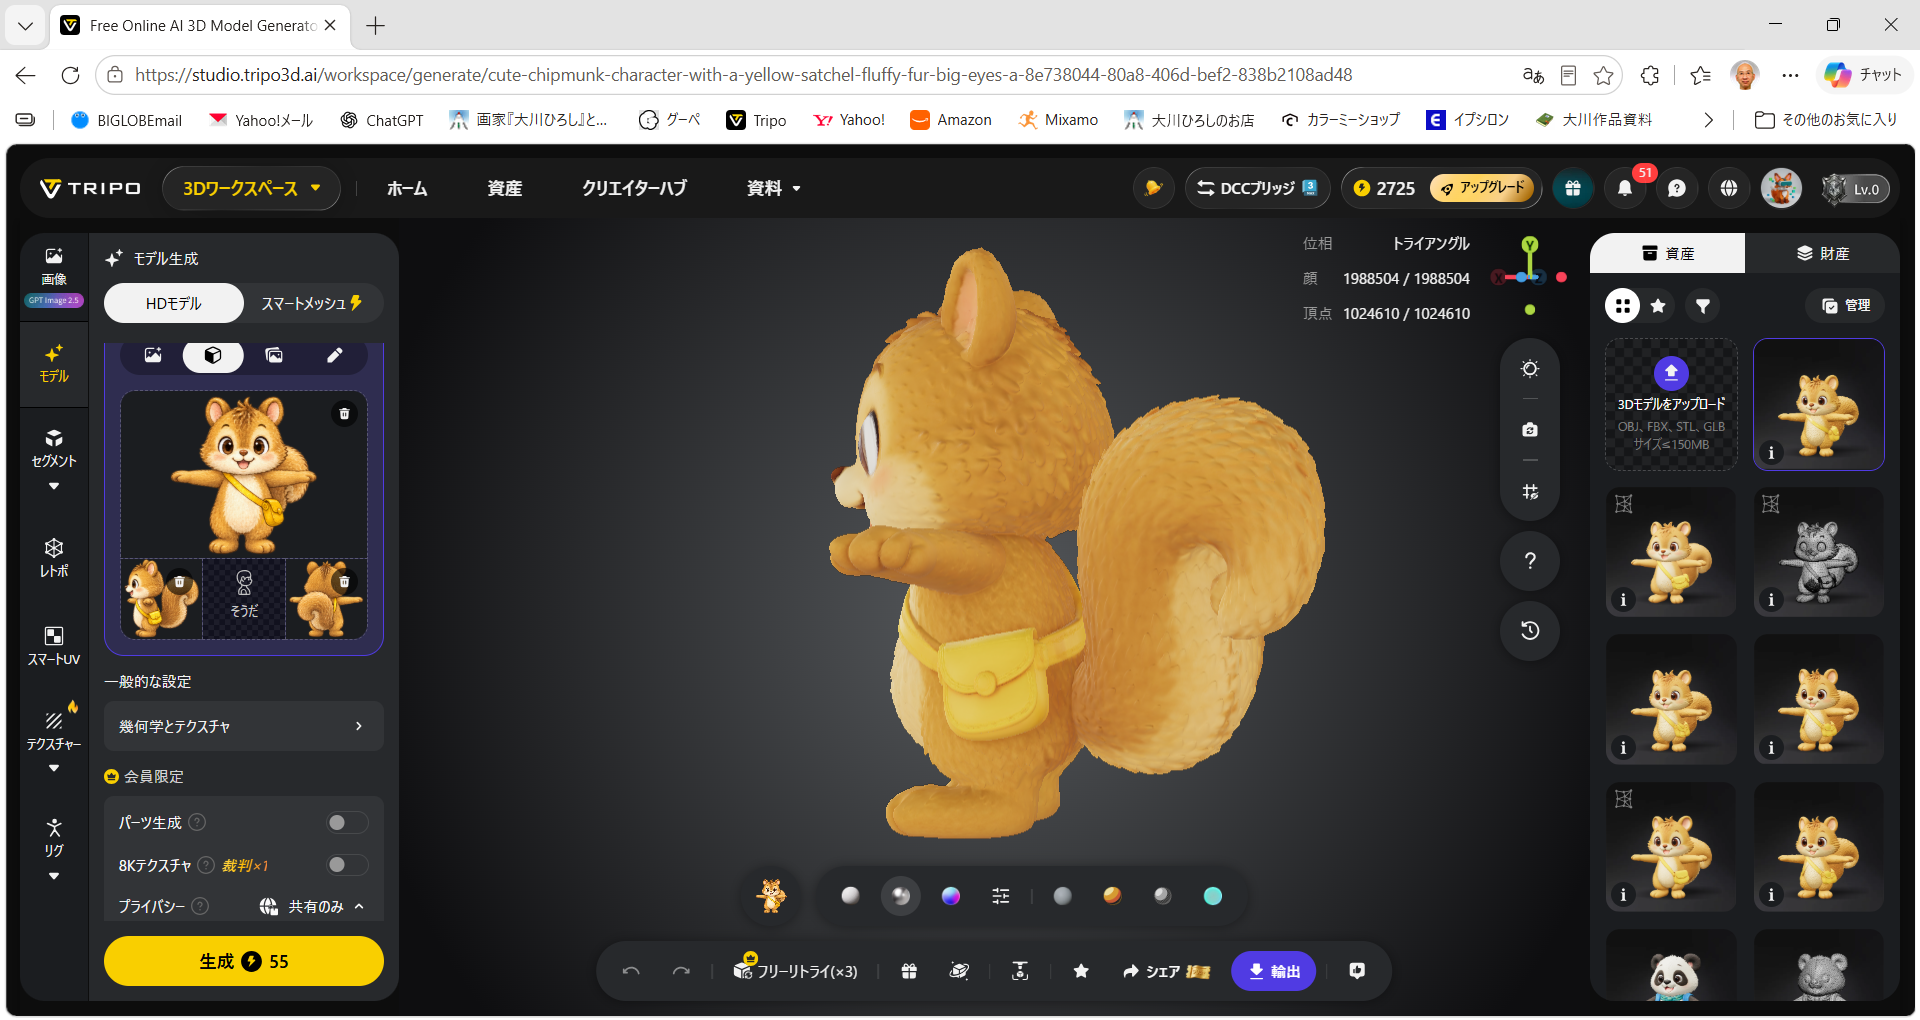
前回までの検証によって、リンのTポーズ4面図に含まれていた情報の不整合を修正し、Tripoによる3Dモデル生成で採用可能なHDモデルを完成させることができた。
今回の課題は、この高精細モデルを実際のゲーム制作で使用できるモデルへ軽量化することである。
完成したリンのHDモデルは、
1,916,616 faces
1,007,466 vertices
という非常に高精細なモデルである。
しかし、ゲームで使用するためには、このままではポリゴン数が多すぎる。
そこで今回は、Tripoのリトポロジー機能を使用して、HDモデルからポリゴン数を大幅に削減したモデルを生成し、
どこまで外観品質を維持できるのか
さらに、
ゲーム用モデルを制作する場合、どのようなメッシュ構造で軽量化するのが適切なのか
を検証することにした。
1.約191万facesのHDモデルから軽量化する
今回の出発点は、前回完成したリンのHDモデルである。
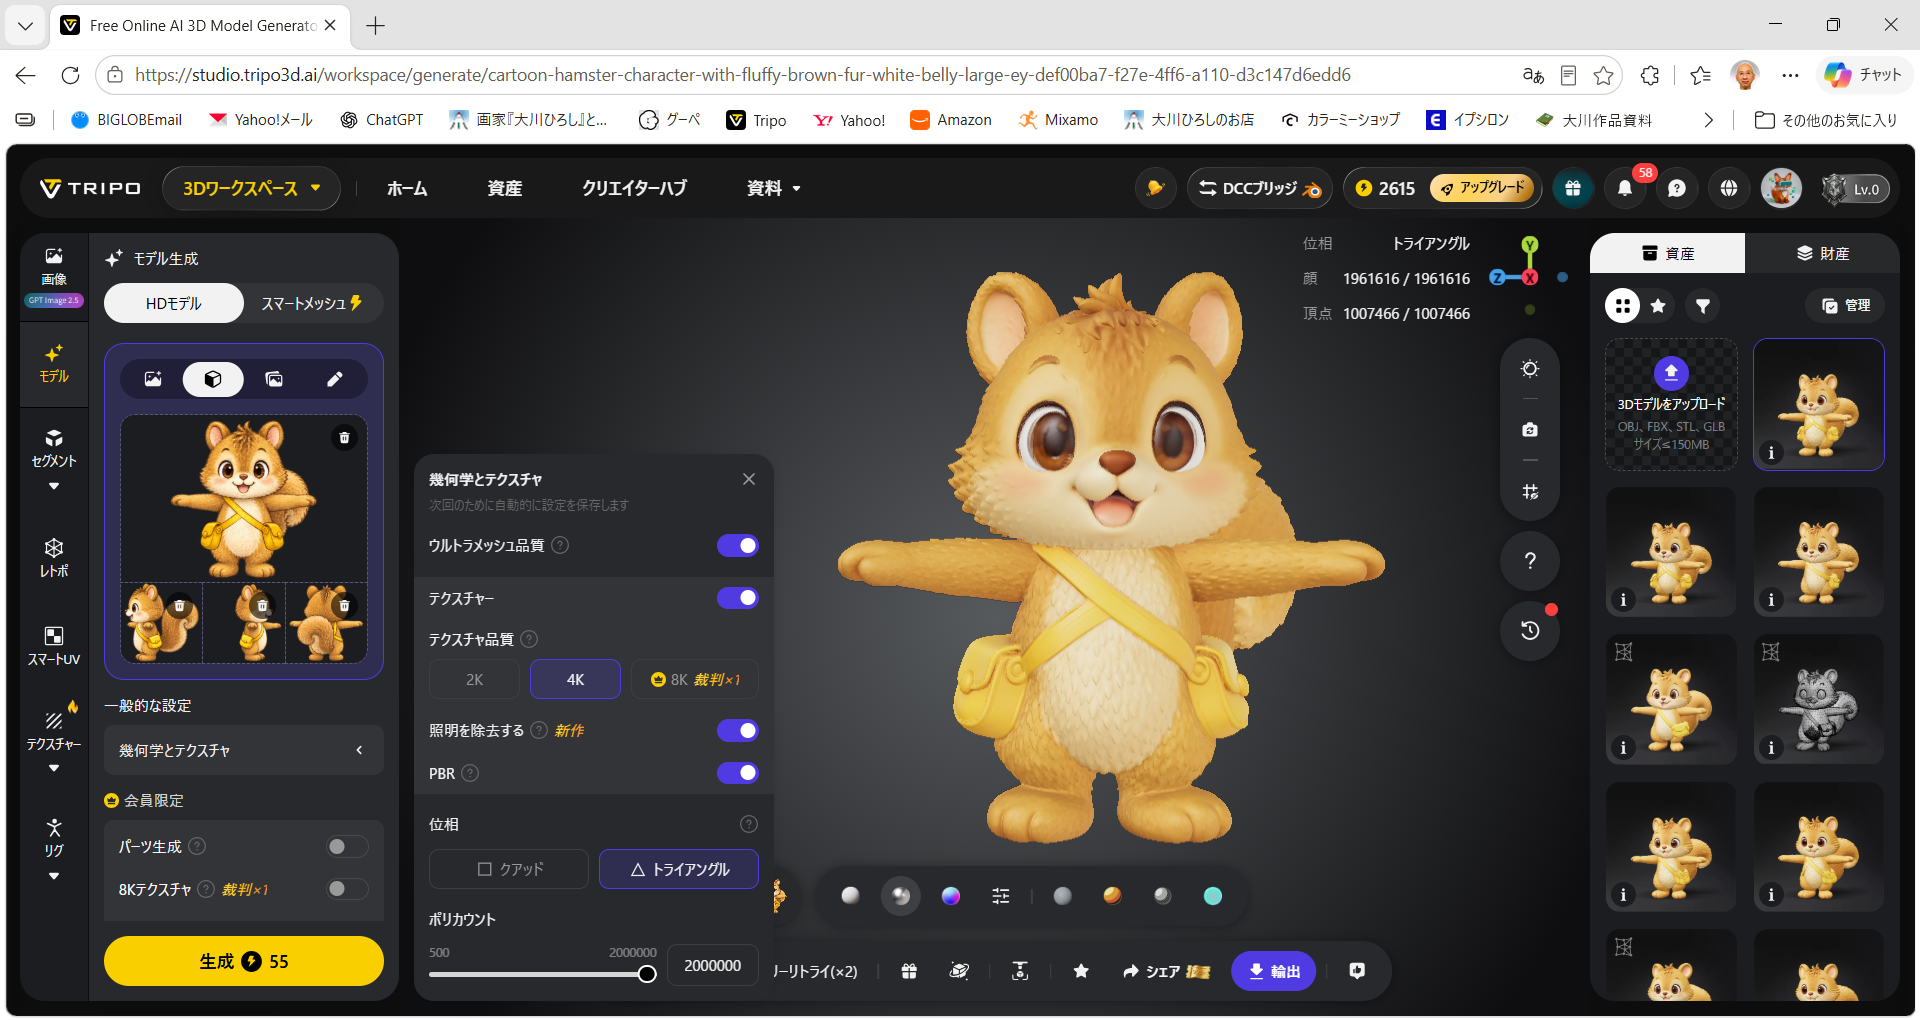
1,916,616 faces
1,007,466 vertices
今回の方法では、最初から低ポリゴンモデルを生成するのではない。
まずAIによって可能な限り高品質なモデルを生成し、その完成した形状を基準として、後工程でゲーム用モデルへ軽量化する。
今回検証する基本工程は、
高精細HDモデルを生成
↓
Quadでリトポロジー
↓
Blenderでモデルを確認・調整
↓
最終的にTriangleへ変換
↓
ゲームへ実装
という流れである。
これは、これまでパンタの制作でも検証してきた、
「まず高品質なモデルを作り、その後ゲーム用途に合わせて大幅に軽量化する」
という制作方法を、リンでも改めて検証するものである。
2.Quad約10,000を指定してリトポロジーする
まず、HDモデルを基準として、TripoでQuadによるリトポロジーを行った。
約10,000ポリゴンを目標として生成した結果、完成したモデルは、
Quad 10,792
となった。
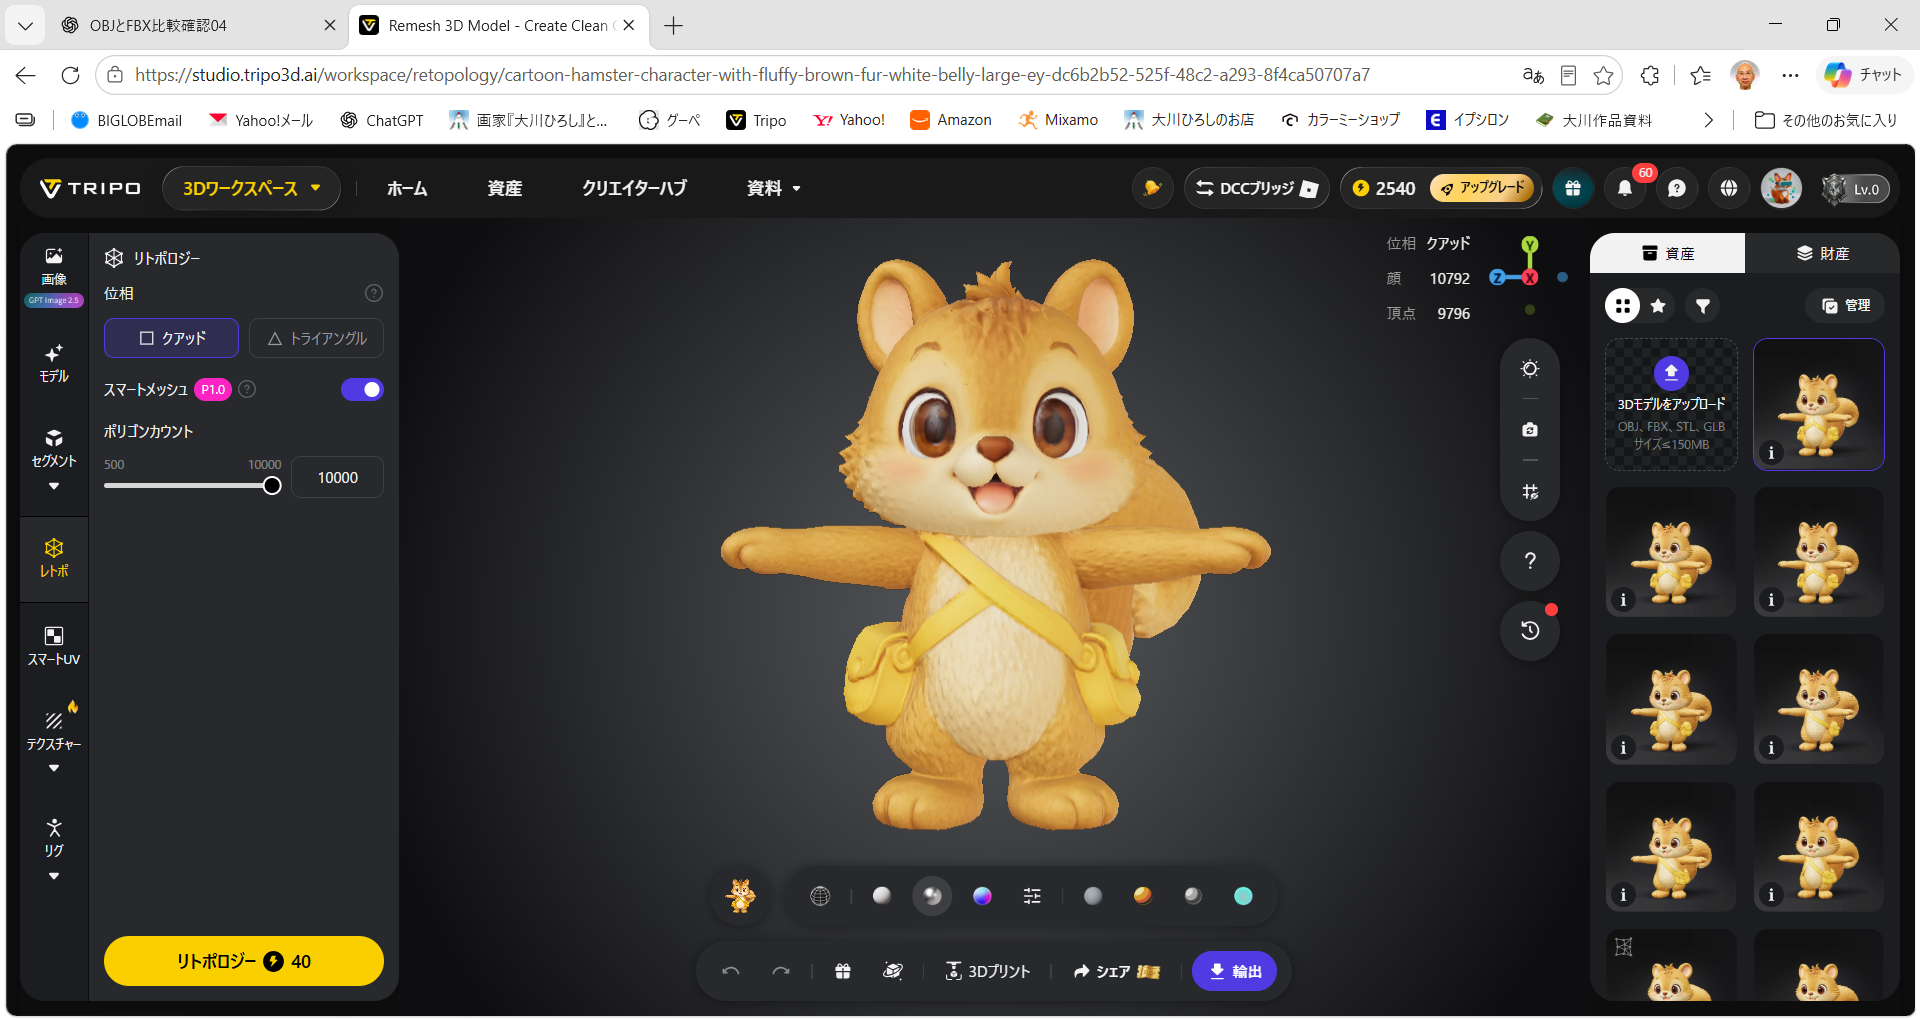
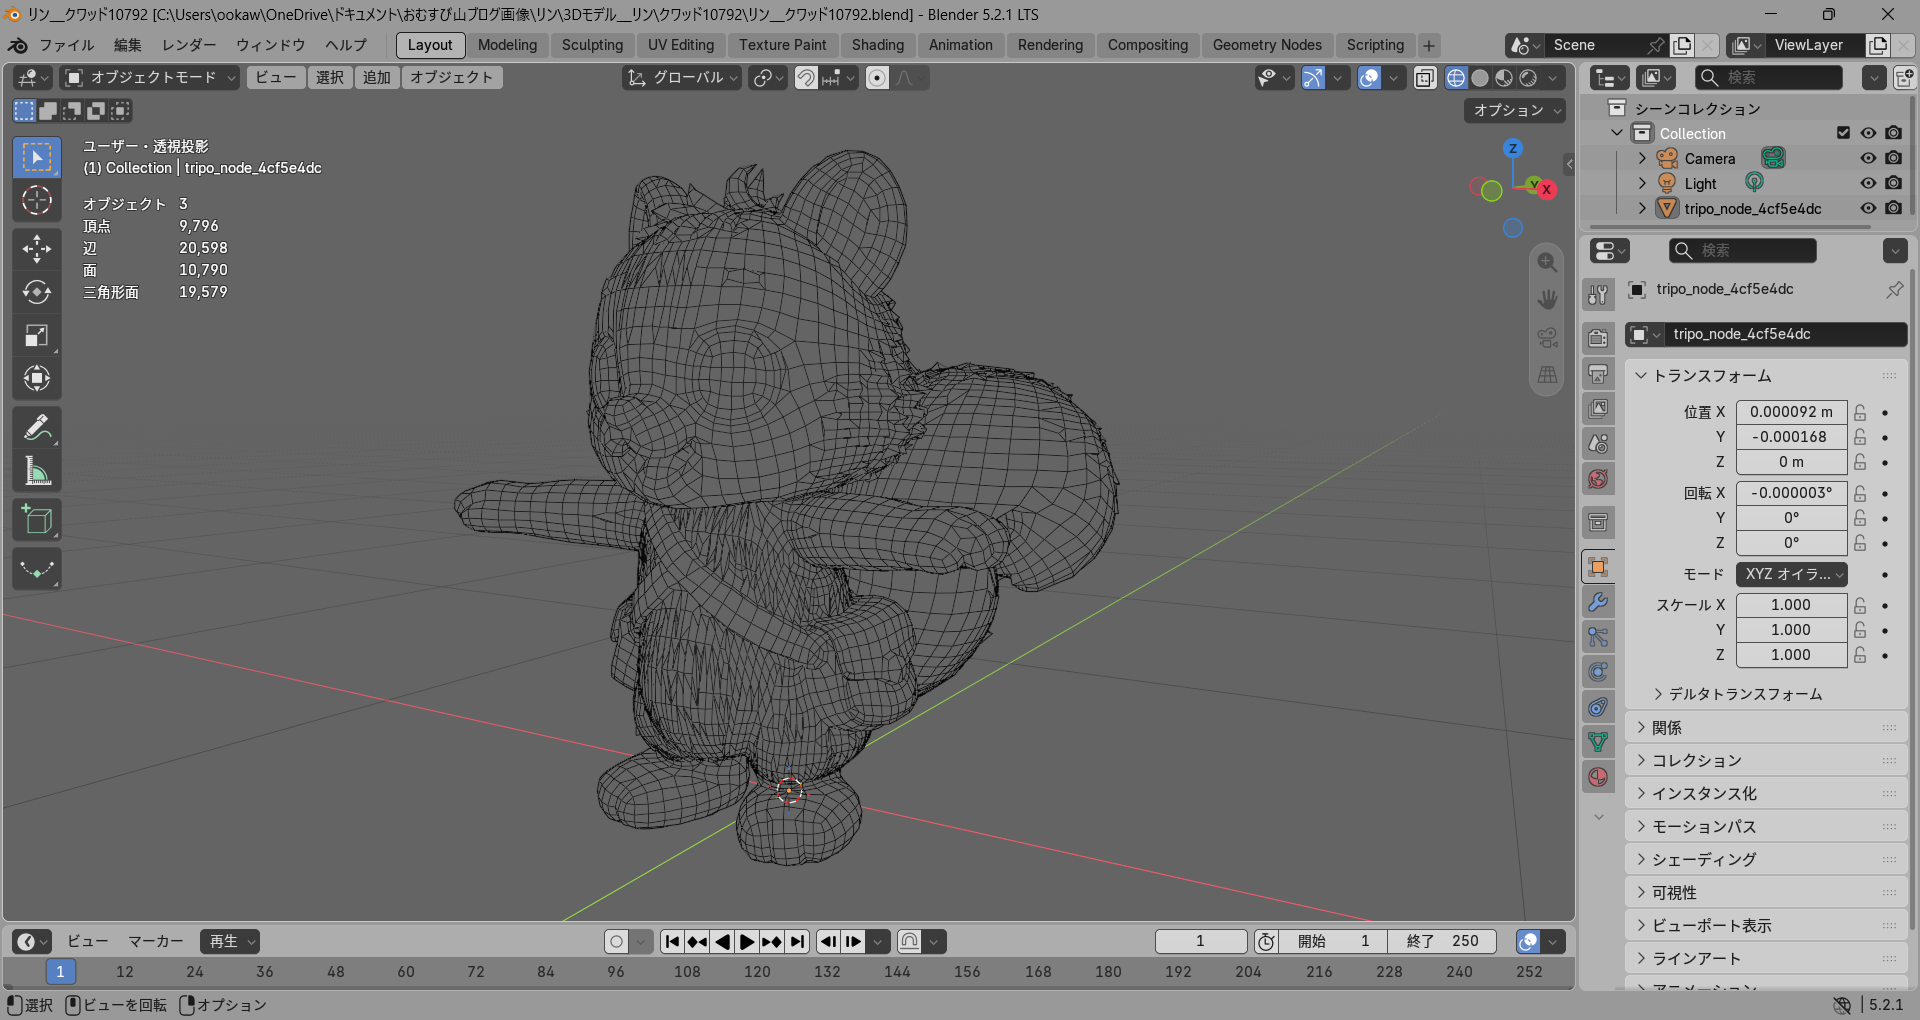
元のHDモデルは約191万facesである。
そこから約1万Quadまで大幅に削減したにもかかわらず、テクスチャを表示した状態では、リンの顔、身体、大きなしっぽ、バッグなどの外観はかなり維持されている。
Blenderでメッシュを確認すると、ポリゴン数が大幅に削減されていることも明確に確認できた。
3.指定したポリゴン数と生成結果は一致するとは限らない
ここで、以前行ったパンタのリトポロジー実験との違いに気づいた。
パンタでは、Tripoで約10,000ポリゴンを指定したにもかかわらず、実際に生成されたモデルは約14,000ポリゴンとなった。
今回のリンでも同様に約10,000を指定したが、生成結果は10,000弱となったケースも確認している。
つまり、同じ「10,000」という指定であっても、実際に生成されるポリゴン数は同じではない。
今回までの実験から、Tripoで指定するポリゴン数は、
完成モデルのポリゴン数を厳密に固定する値ではなく、リトポロジーを行う際の目標値
として考える必要があることが分かった。
パンタとリンで結果が異なる理由については、元モデルの形状や構造などが関係している可能性も考えられるが、今回の実験だけでは判断できない。
4.さらにQuad 5,000を指定する
Quad約10,000まで軽量化しても外観がかなり維持されたため、さらにポリゴン数を減らすことにした。
ここで重要なのは、
Quad 10,792
↓
Quad 5,550
と段階的に削減したのではないことである。
Quad 10,792とQuad 5,550は、どちらも元のHDモデルから直接リトポロジーしている。
つまり、
HD 1,916,616 faces
↓
Quad 10,792
と、
HD 1,916,616 faces
↓
Quad 5,550
という二つのモデルを生成して比較した。
TripoでQuad 5,000を指定した結果、
5,550 faces
4,938 vertices
となった。
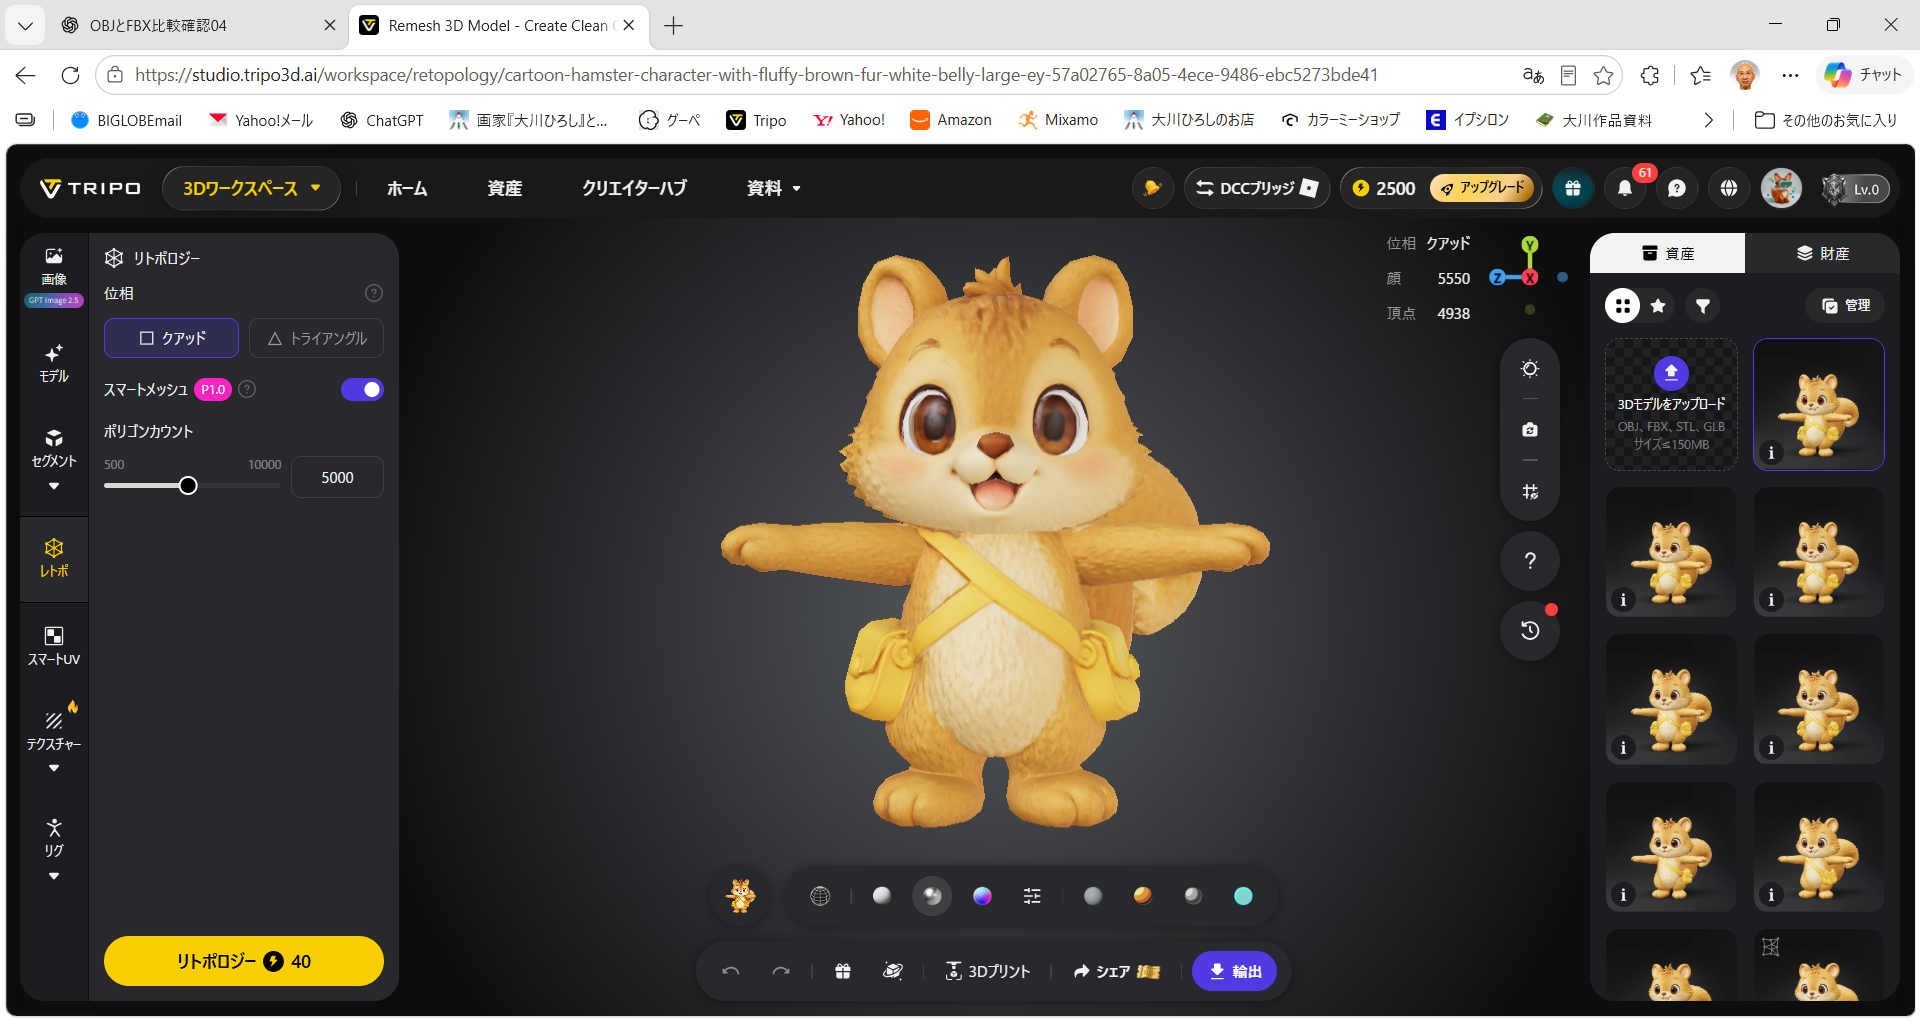
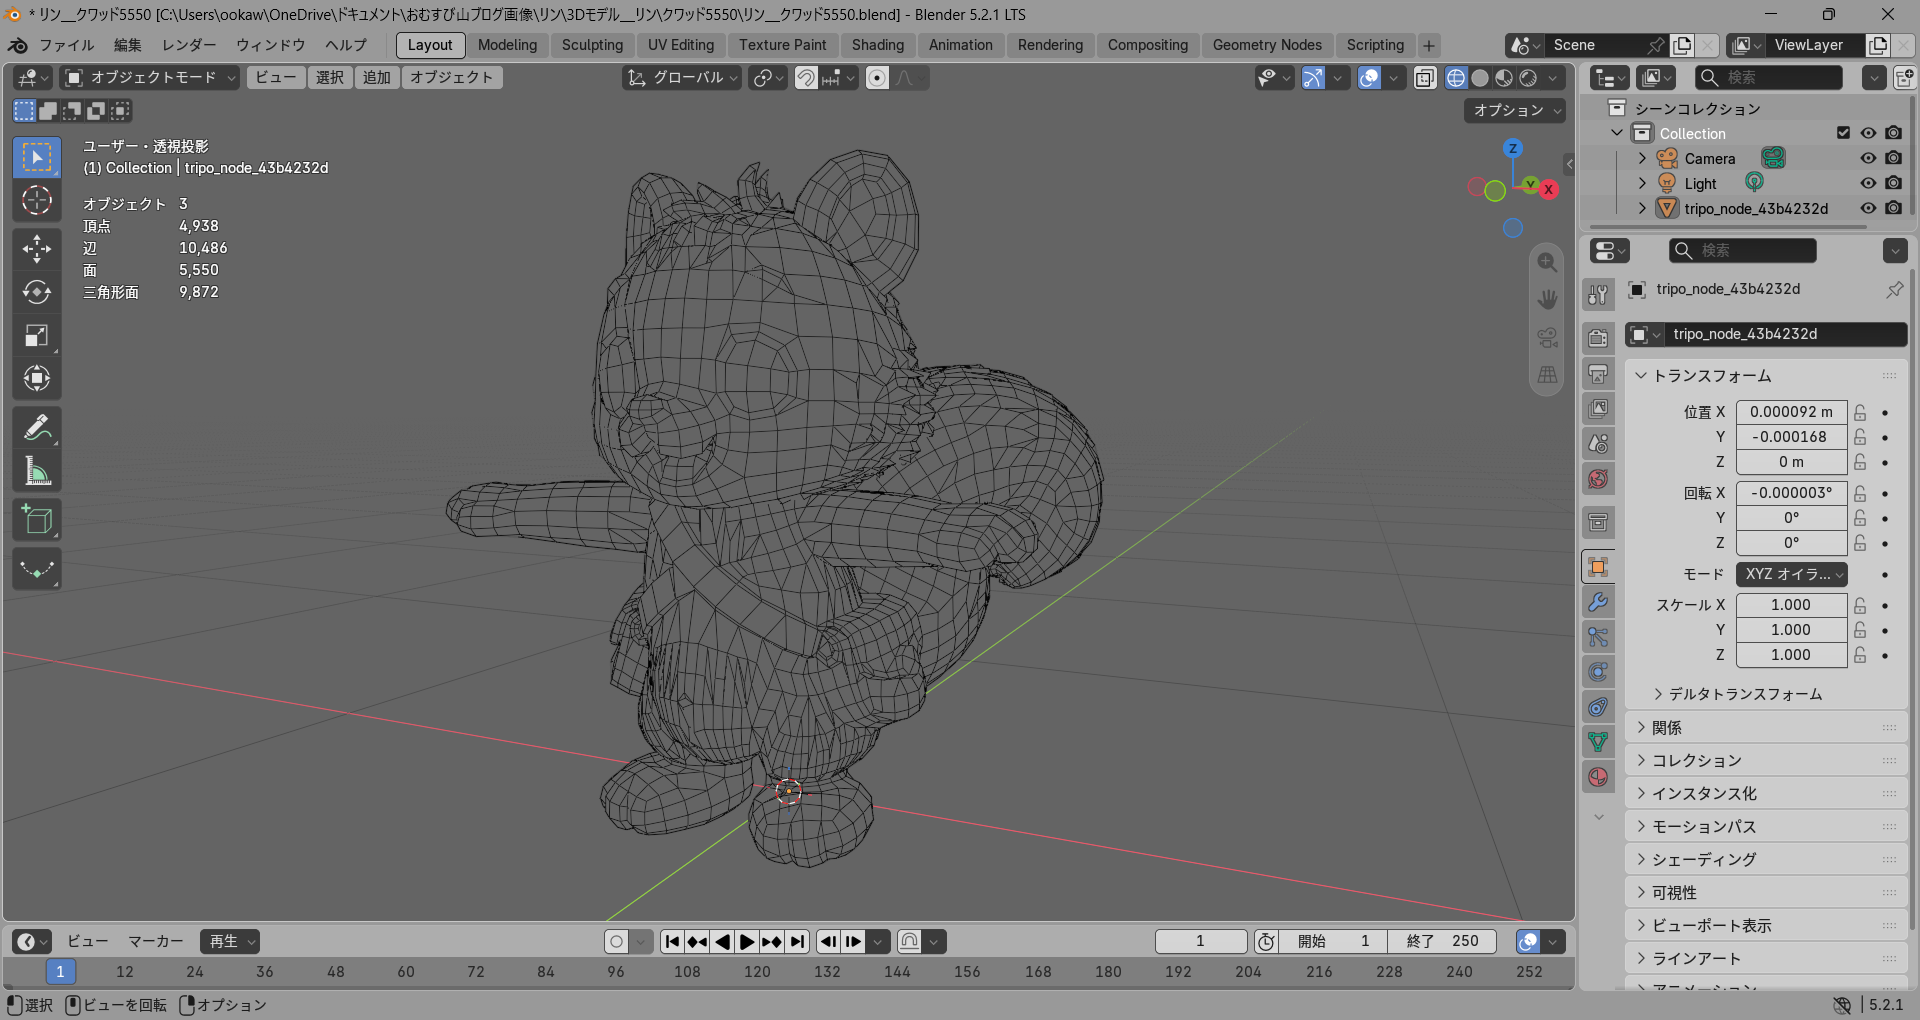
Quad 10,792と比較すると、faces数はほぼ半分になっている。
しかし、テクスチャを表示した状態で比較したところ、今回の目視確認では、両者の外観品質に大きな差は確認できなかった。
もちろん、これだけでQuad 5,550が最適なポリゴン数であるとは判断できない。
しかし少なくとも今回のリンでは、約191万facesのHDモデルを5,550 Quadまで軽量化しても、キャラクターの外観をかなり維持できることが確認できた。
5.HDモデルから直接Triangleへ軽量化する
次に比較のため、HDモデルから直接Triangleによるリトポロジーも行った。
その結果、
Triangle 9,740
のモデルが生成された。
Blenderで確認すると、
4,869 vertices
9,740 faces
9,740 triangles
となっていた。
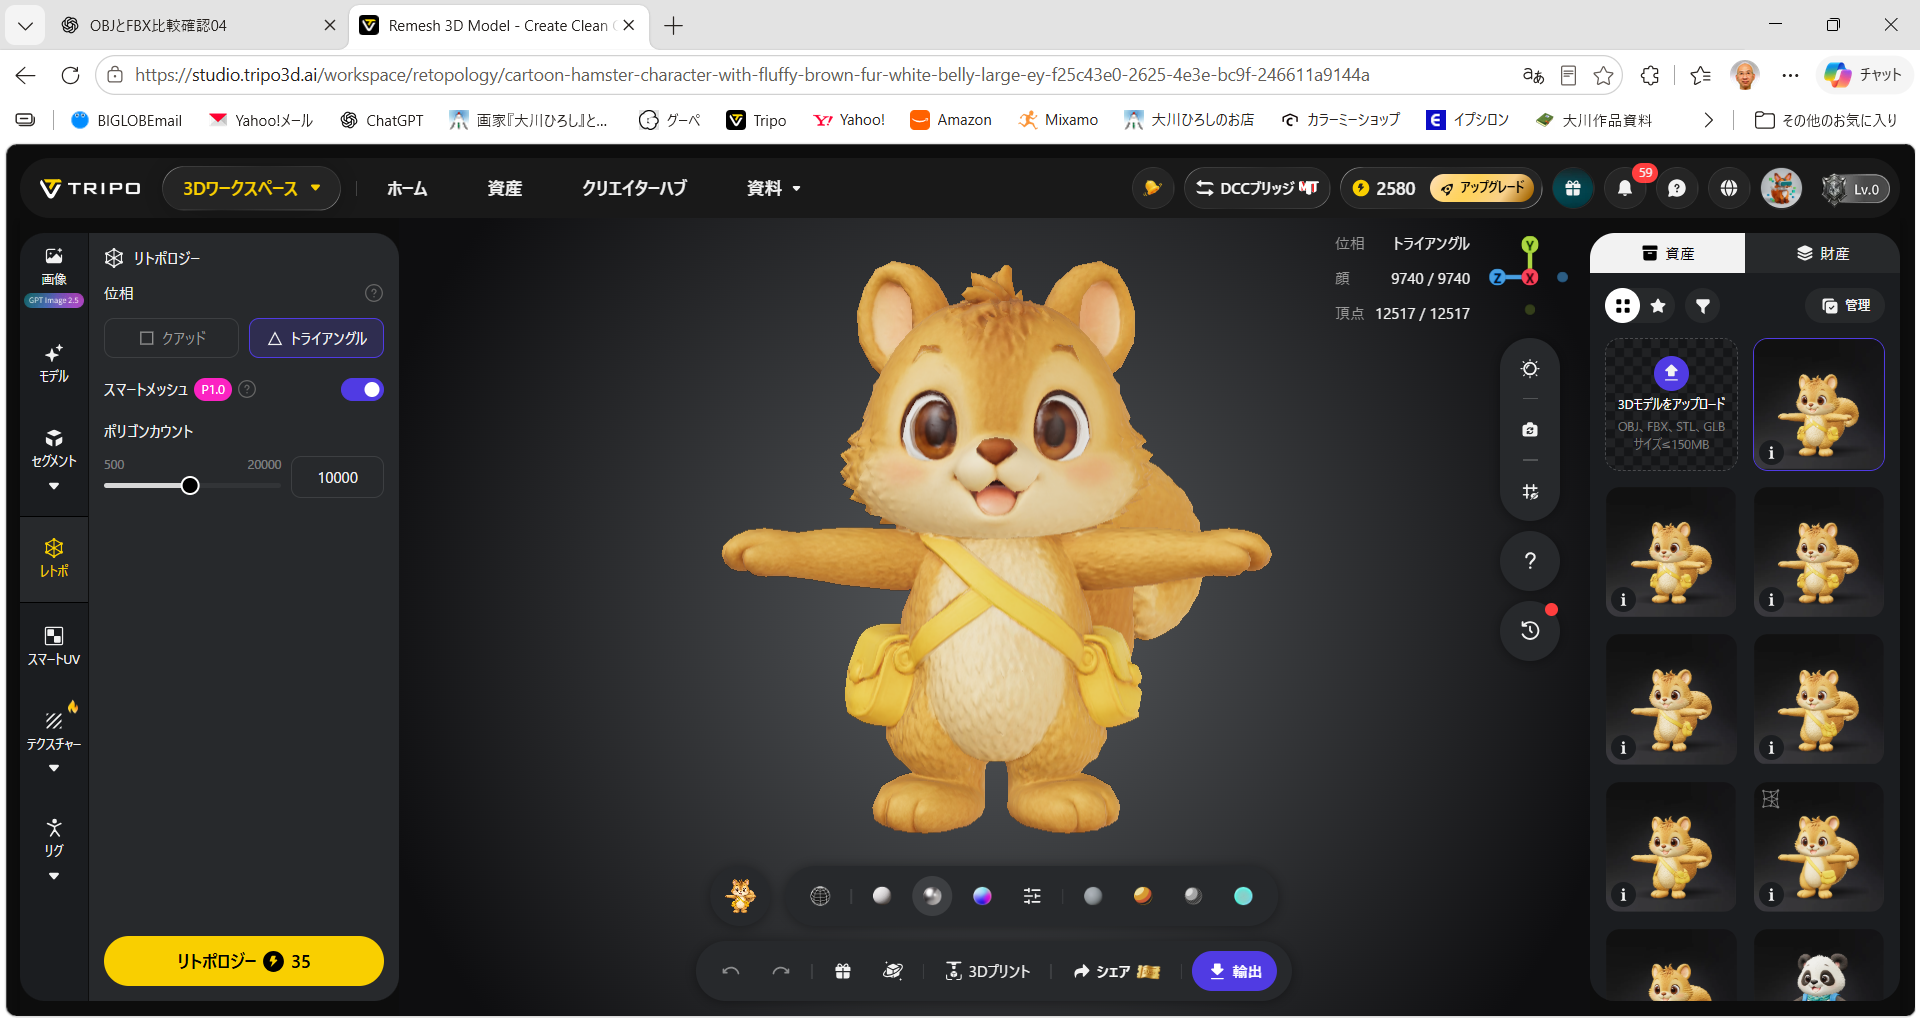
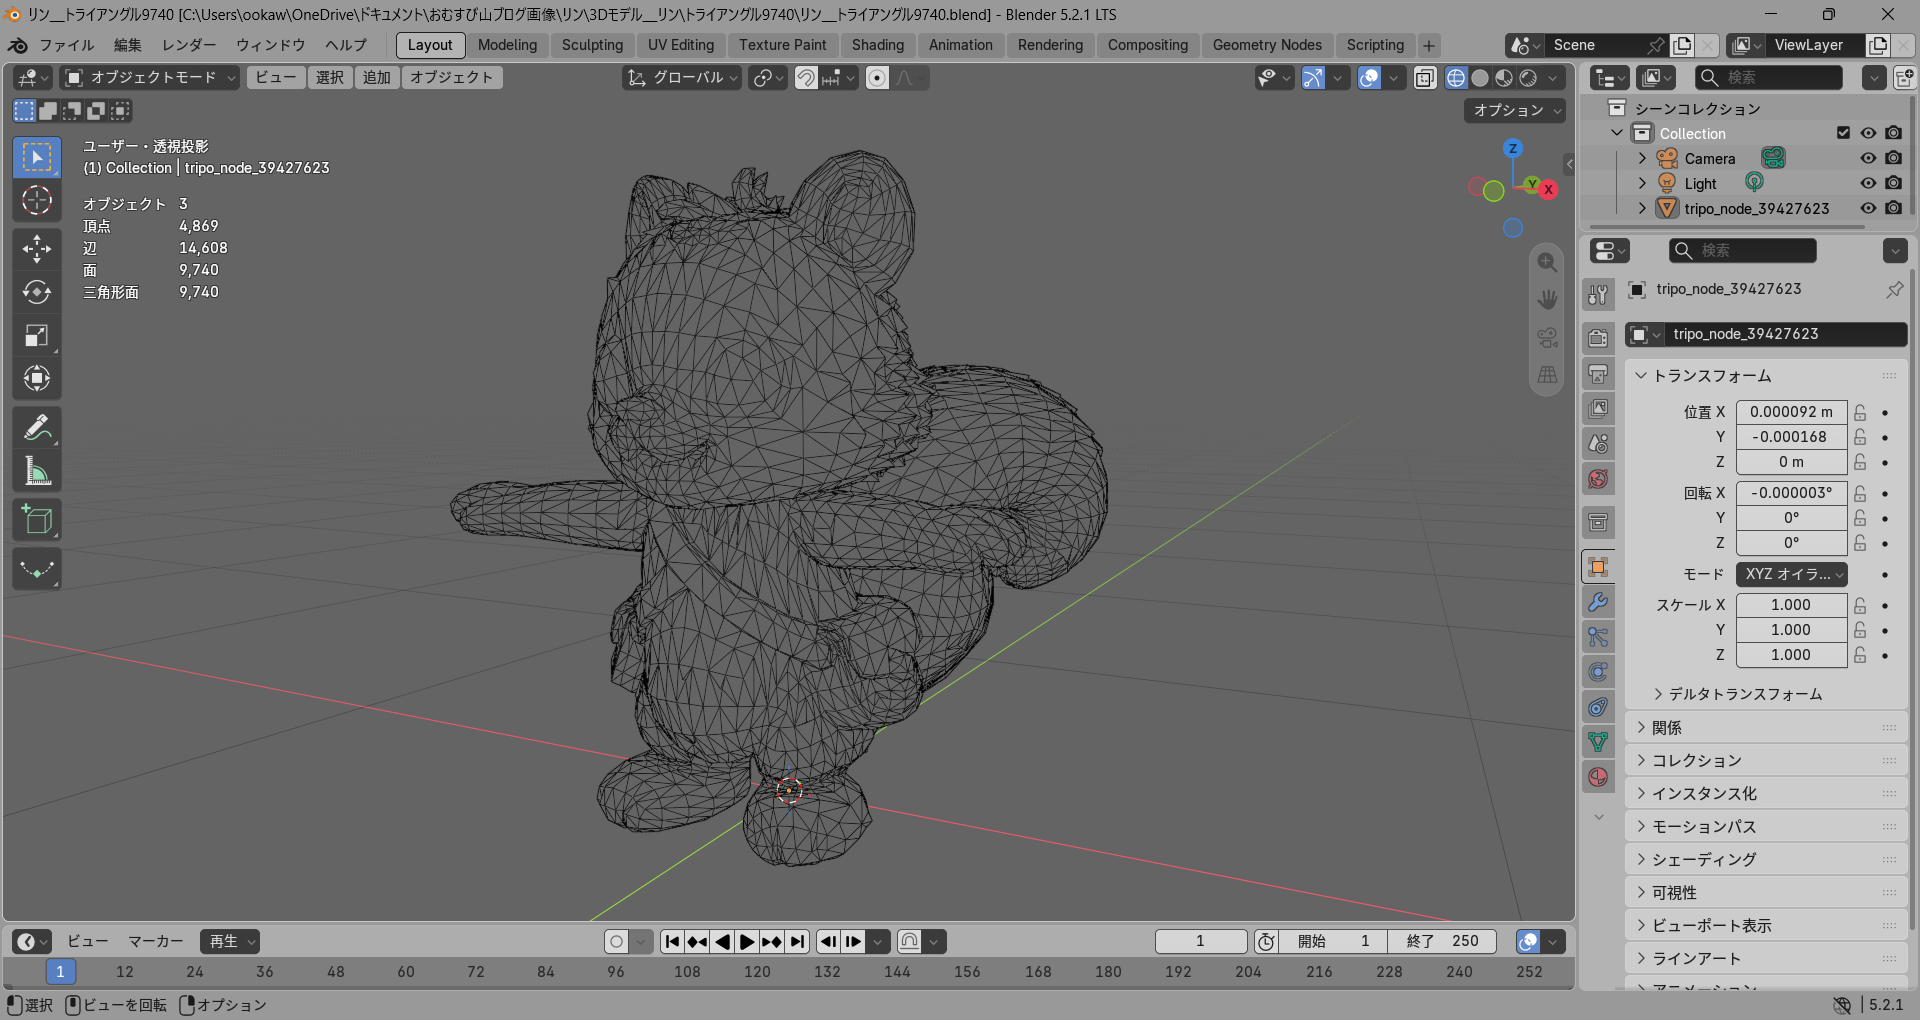
テクスチャを表示した状態では、このモデルもリンの外観をかなり維持している。
しかし、ワイヤーフレームを確認すると、Quadモデルとは明らかな違いがあった。
6.QuadとTriangleではメッシュの構造が異なる
ここが今回の検証で、モデリング上特に重要な部分である。
HDモデルから直接Triangleへ削減したモデルでは、モデル表面が多数の三角面によって構成されている。
そのため、エッジの方向が細かく分散している。
一方、Quad 5,550モデルでは四角面を基本として構成され、顔、胴体、腕、脚、しっぽなど、キャラクターの形状に沿った比較的連続したエッジの流れを見ることができる。
これは単に、
QuadかTriangleか
という形式上の違いではない。
3Dモデルは、リトポロジーした後にもBlenderで形状の確認や修正、調整を行う可能性がある。
そのため、制作途中のモデルでは、ポリゴン数だけではなく、
人間がメッシュ構造を把握し、編集・調整できる状態であること
も重要になる。
7.Quad 5,550をTriangleへ変換する
ただし、今回のQuad 5,550モデルを、そのままゲームへ持ち込むわけではない。
ゲームで使用する最終モデルではTriangleへ変換する。
そこで、Quad 5,550モデルをBlenderでTriangle化した。
その結果、
Quad 5,550
↓
Triangle 9,871
となった。
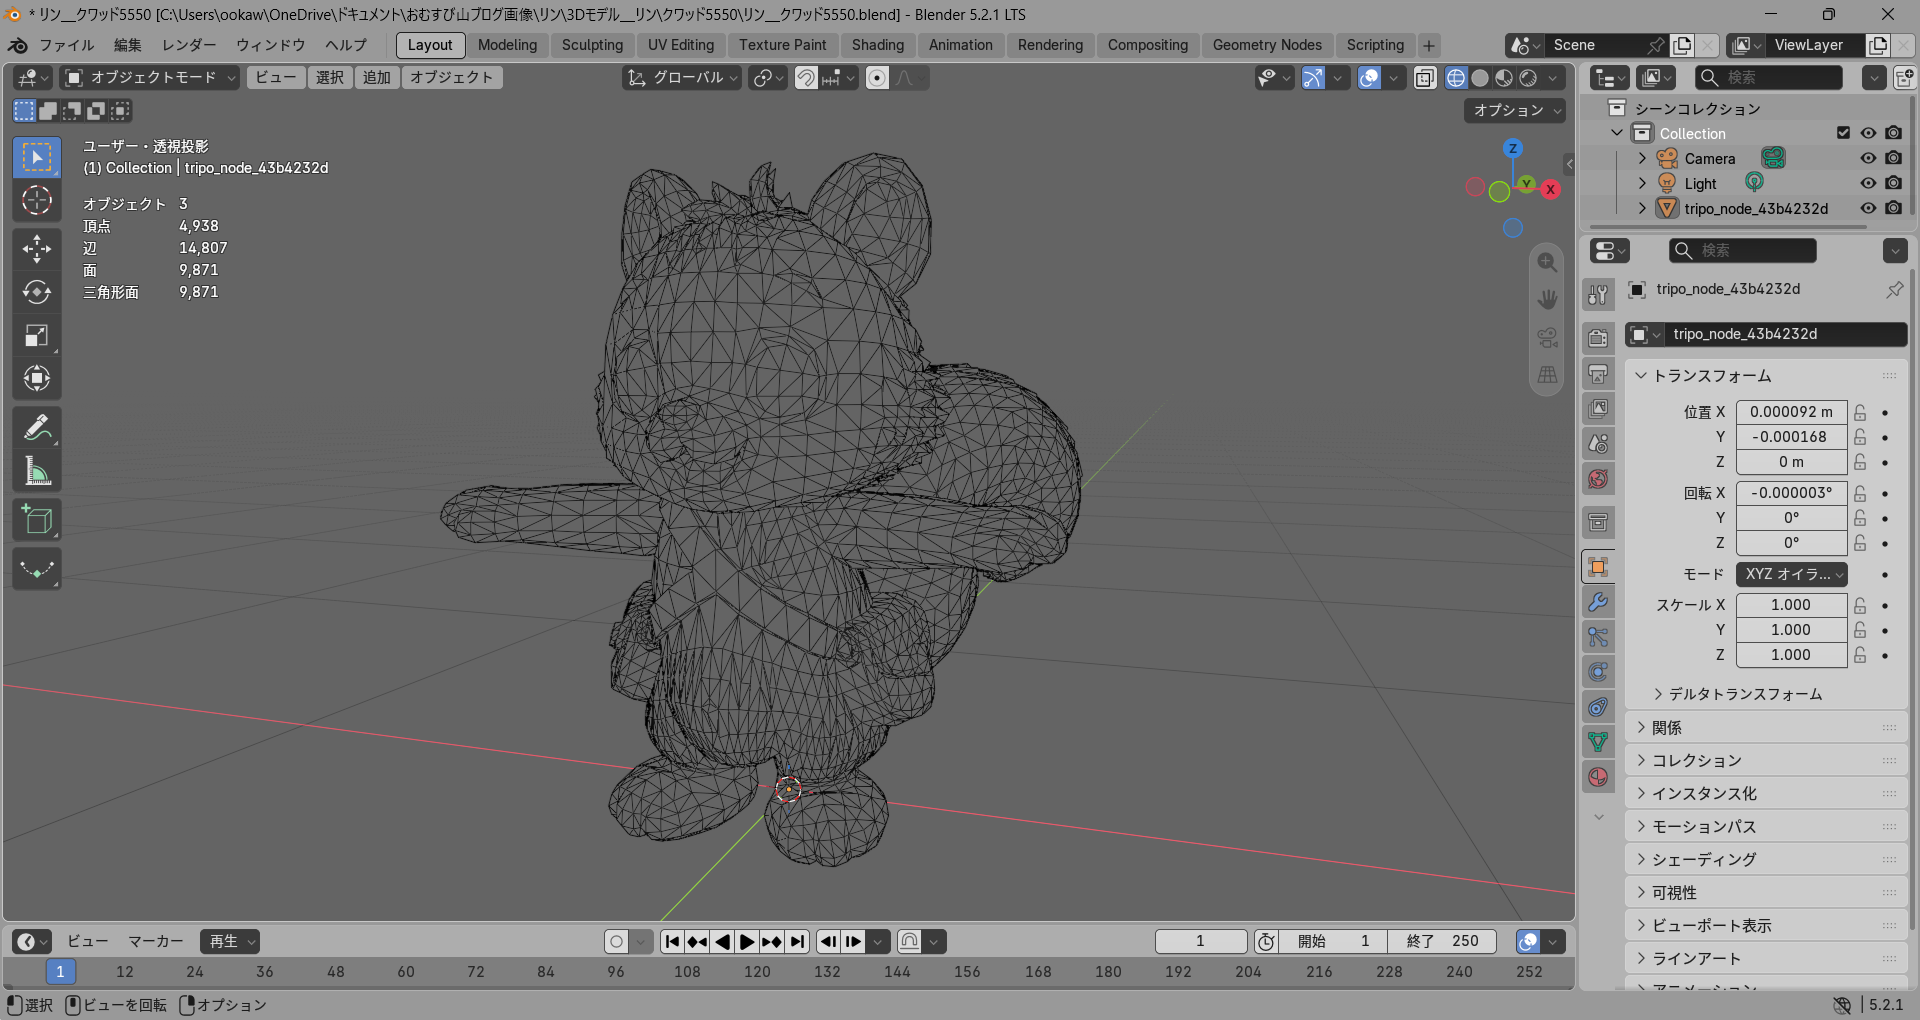
ここで興味深い結果が得られた。
HDモデルからTripoで直接Triangleへリトポロジーしたモデルは、
9,740 triangles
である。
一方、
Quad 5,550からBlenderでTriangle化したモデルは、
9,871 triangles
である。
その差は、わずか131 trianglesである。
8.最終ポリゴン数が近くても制作工程は同じではない
ゲームへ持ち込む段階だけを見れば、
直接Triangle化したモデル 9,740 triangles
と、
Quadを経由してTriangle化したモデル 9,871 triangles
は、ほぼ同じ規模のモデルである。
しかし、3Dモデルの制作工程として考えると、両者には大きな違いがある。
直接Triangleへリトポロジーする場合は、
HDモデル
↓
Triangle
↓
ゲーム実装
となる。
これに対して、Quadを経由する場合は、
HDモデル
↓
Quadリトポロジー
↓
Blenderで確認・編集・調整
↓
Triangle化
↓
ゲーム実装
となる。
最終的にはどちらも約1万Triangleである。
しかしQuadを経由することで、その途中に、
キャラクターの形状に沿ったエッジの流れを持つ、モデリング作業に適したメッシュ
を確保することができる。
したがって、
「ゲームでは最終的にTriangleを使用するのだから、最初からTriangleへ削減すればよい」
とは限らない。
最終的なポリゴン数だけではなく、制作途中で人間がモデルを扱えるメッシュ構造を確保することも、ゲーム用3Dモデル制作では重要である。
9.AI時代のゲーム用3Dモデル制作工程
今回の検証によって、これまでパンタの制作から考えてきたAI時代のモデリング工程が、さらに具体的になってきた。
従来は、ゲーム用モデルではポリゴン数を抑えながらモデルを制作することが重要だった。
しかしAIによる高精細3Dモデル生成とリトポロジーを組み合わせることで、別の制作方法が可能になりつつある。
今回検証した工程は、
AIで最高品質のHDモデルを生成する
↓
AIでQuadリトポロジーする
↓
Blenderで人間がメッシュを確認し、必要な修正・調整を行う
↓
最終段階でTriangle化する
↓
ゲームへ実装する
というものである。
今回のリンでは、
HD 1,916,616 faces
から、
Quad 5,550 faces
まで大幅に軽量化した。
そしてゲーム用としてTriangle化すると、
9,871 triangles
となった。
それでも今回の目視比較では、HDモデルから受け継いだリンの外観に大幅な品質低下は確認されなかった。
これは、以前パンタで確認した、
「最初から低ポリゴンで作るのではなく、まず高品質なモデルを生成し、その後大幅に軽量化する」
という方法を、別のキャラクターであるリンでも改めて検証した結果である。
10.今回の検証から分かったこと
今回の実験から、まず、AIによって生成した約191万facesの高精細モデルを、5,550 Quadまで大幅に軽量化しても、今回の目視比較では外観をかなり維持できることが確認できた。
また、Tripoで指定するポリゴン数は必ずしも完成時の数値と一致せず、パンタとリンでは同じ約10,000という指定でも異なる結果となった。
さらに、
Quad 5,550 → Triangle 9,871
と、
HD → 直接Triangle 9,740
では、最終的なTriangle数はほぼ同じになった。
しかし、その制作工程には重要な違いがある。
直接Triangleへ削減したモデルでは、最初から三角面によるメッシュとなる。
一方、Quadリトポロジーを経由すれば、ゲーム用Triangleへ変換する前に、形状に沿ったエッジの流れを持つメッシュをBlender上で扱うことができる。
今回の実験で重要だったのは、単に、
「どこまでポリゴン数を減らせるか」
ということだけではない。
「AIが生成した高精細モデルを、どのような工程でゲーム用モデルへ変換するのか」
という制作方法そのものが見えてきたことである。
次回へ
軽量化したリンのモデルが完成した。
次の課題は、このモデルを実際にゲームキャラクターとして動かすことである。
そこで、Mixamoによる自動リギングを行った。
しかし――
ここで、新たな問題が発生した。
次回は、リンのようなデフォルメされたキャラクターにMixamoで自動リギングを行ったとき、何が起きるのかを検証する。
第17回 完
第16回 3D生成AIの「誤り」を入力画像から修正する
AIゲーム開発研究室
3Dモデル制作ドキュメント
第16回
3D生成AIの「誤り」を入力画像から修正する
― Tripoの画像解釈と入力設計の検証 ―
研究代表 大川 博
主任研究員 Arc(ChatGPT)
はじめに
前回までの検証では、リンのTポーズ4方向画像からTripoを使って3Dモデルを生成し、尻尾の先端が二つに分かれる、バッグが重複する、バッグやベルトが身体へ入り込むといった問題が確認された。
当初、これらは3D生成AIによる「生成エラー」のようにも見えた。
しかし、4方向画像をあらためて確認すると、それぞれの画像に描かれた情報には微妙な違いが存在していた。
そこで今回は、生成された3Dモデルを直接修正するのではなく、
「なぜTripoは、このような3D形状を生成したのか」
という視点から、入力画像そのものを検証することにした。
その結果、Tripoが入力画像をかなり正確に解析し、複数画像に存在する情報をできるだけ3D空間上で成立させようとしている可能性が見えてきた。
さらに、入力画像の情報を人間が意図的に整理・再配置することで、これまで解決できなかった問題を改善することができた。
今回は、その過程を記録する。
1.前回までに残った問題
リンのHDモデルでは、高精細な3Dモデルそのものは生成できていた。
しかし、キャラクター固有の形状について、いくつかの問題が残っていた。
特に大きかったのが、
- 尻尾の先端が二つに分かれる
- 尻尾が必要以上に広がる
- 左側のバッグが二つ生成される
- 右側のバッグが身体へ入り込む
- バッグのベルトが身体と一体化する
という問題である。
Tripoの再生成や修正機能も試したが、問題を解決することはできなかった。
ここで、3Dモデル側を修正し続けるのではなく、原因となっている可能性のある入力画像側を調べることにした。
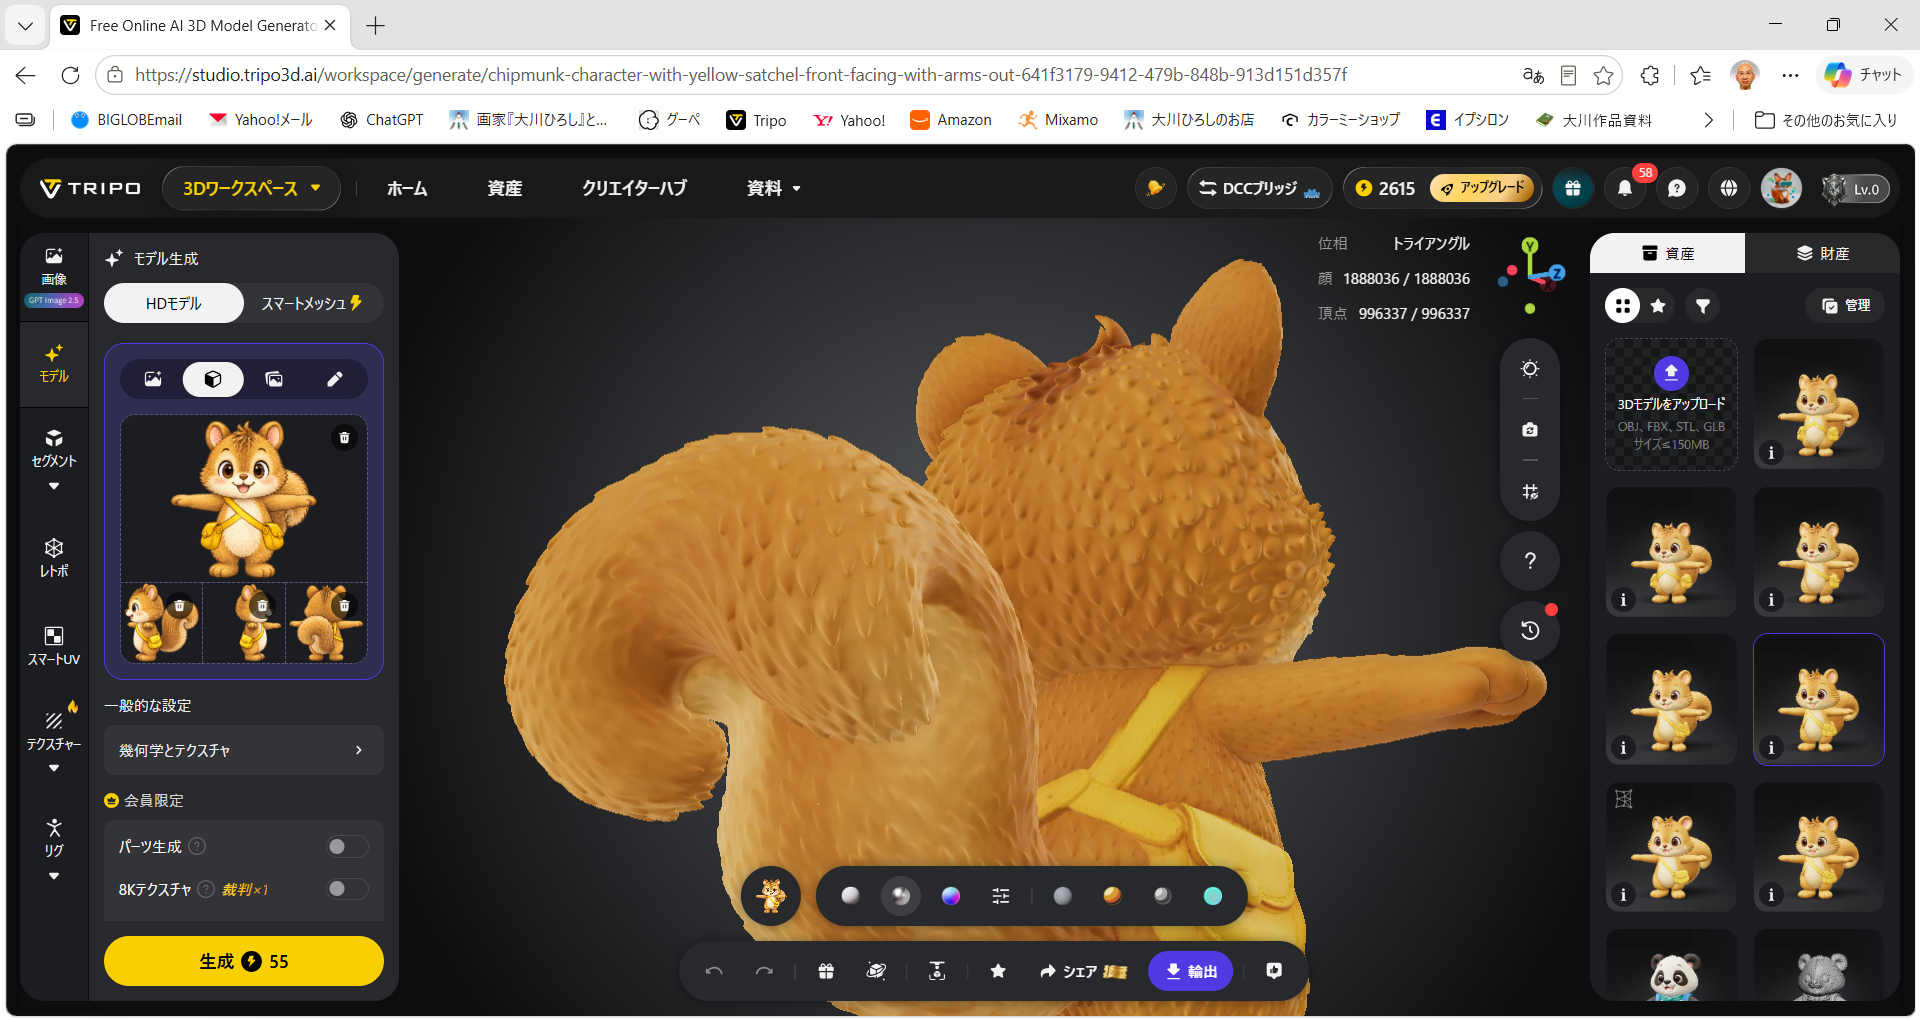
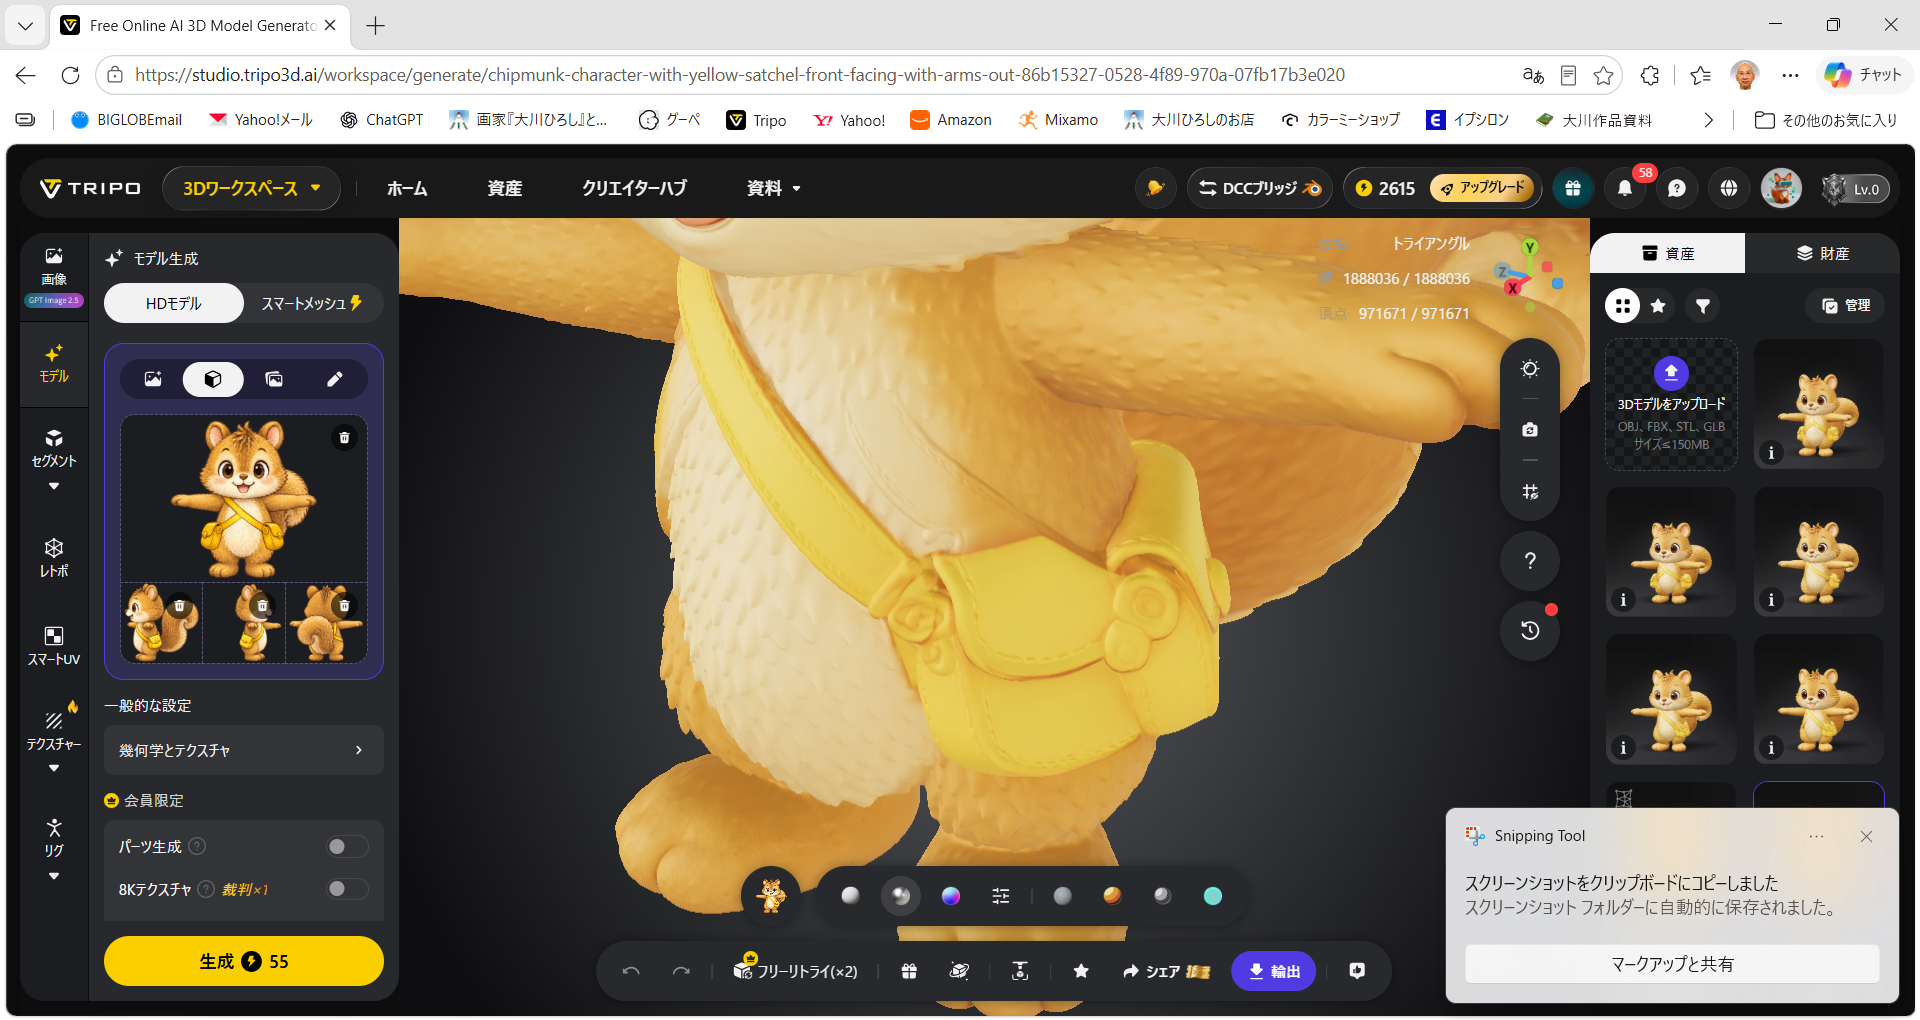
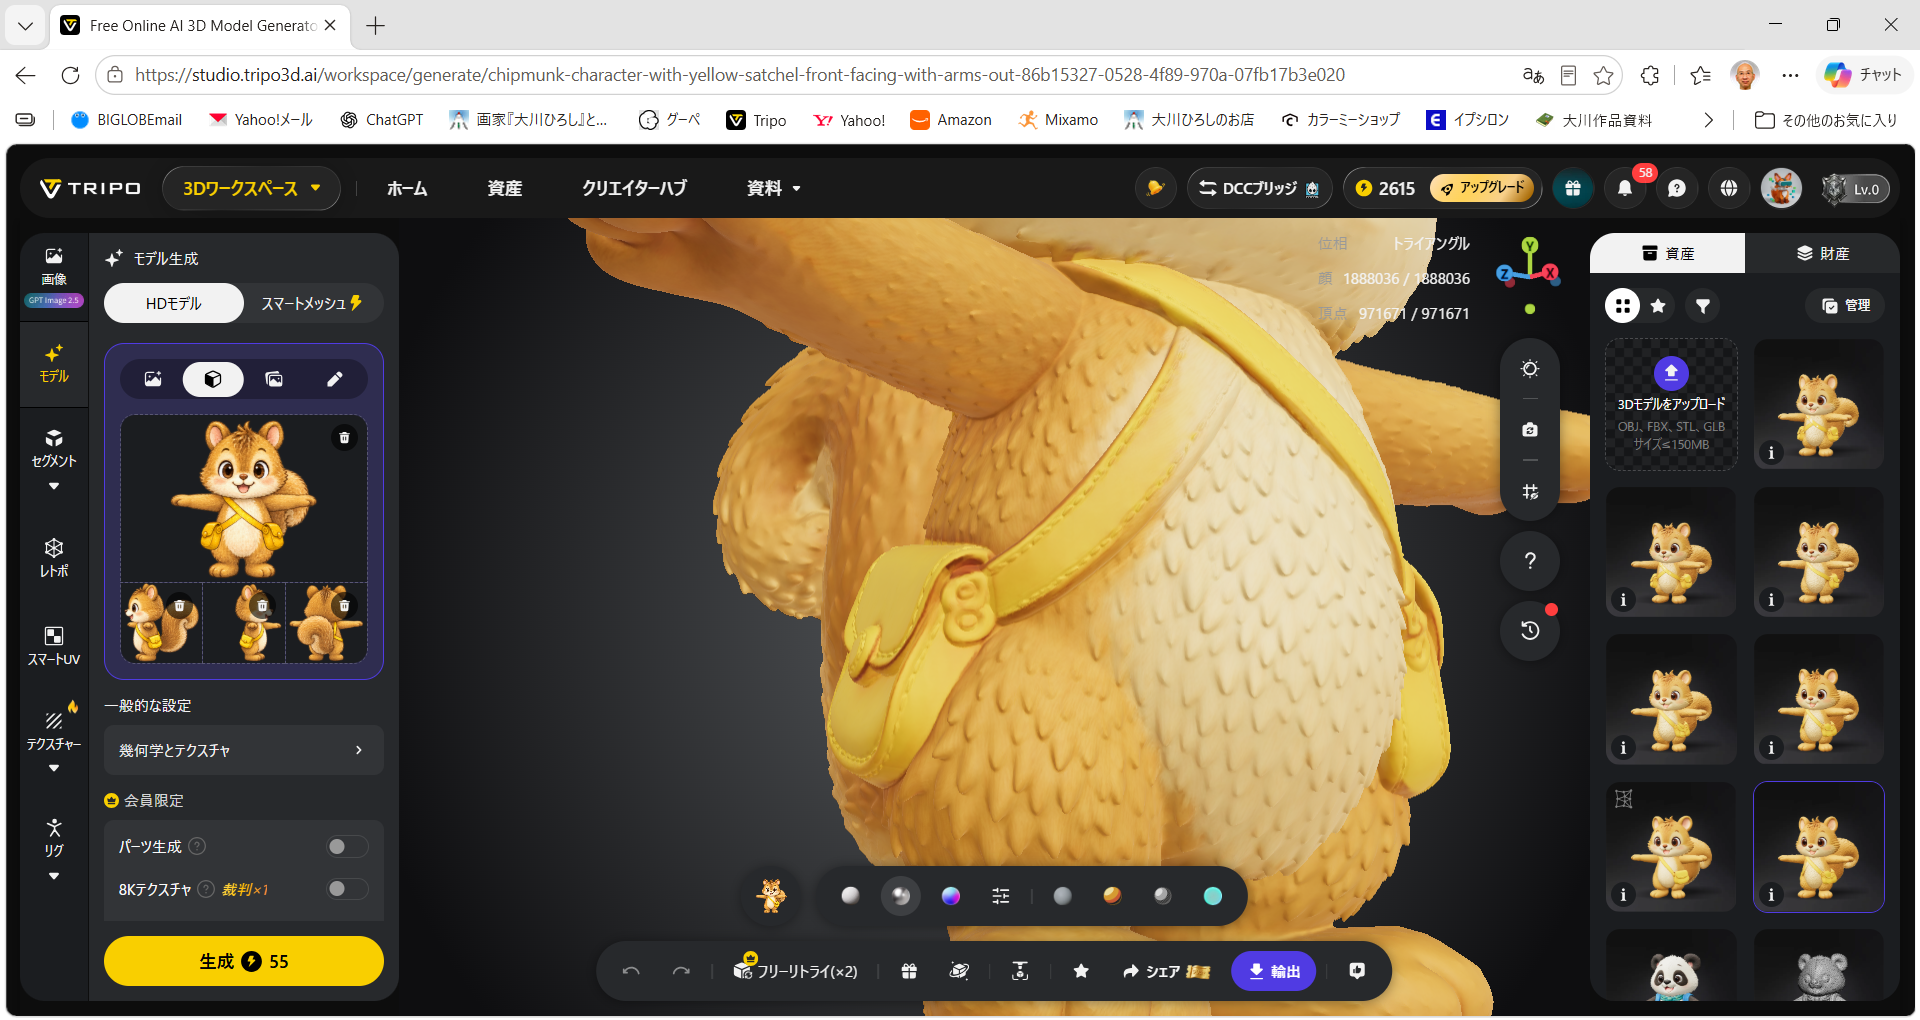
画像説明:
前回のHDモデル。尻尾の分岐、左バッグの重複、右バッグの身体への入り込みなどが確認できる。
2.右側面図を使わずに生成してみる
最初に着目したのは尻尾だった。
リンの大きく巻いた尻尾は、正面・側面・背面で見え方が大きく変化する。
そこで、
右側面図を使用しなければ、尻尾はどうなるのか
を試すことにした。
正面、左側面、背面の画像を使用し、右側面図を除外してTripoで再生成した。
すると、明確な変化が現れた。
二つに分かれていた尻尾が、一本の尻尾として生成された。
尻尾全体の形状も整理された。
これは、右側面図に含まれていた尻尾の情報が、他方向の尻尾情報との対応付けに影響していた可能性を示している。
ただし、新たな問題も発生した。
右側面図には右側のバッグが描かれていたため、その画像を除外すると、当然ながら右バッグの情報も失われた。
その結果、右バッグは生成されず、背面に描かれていたベルトだけが残った。
また、左バッグについては、依然として二つ存在していた。
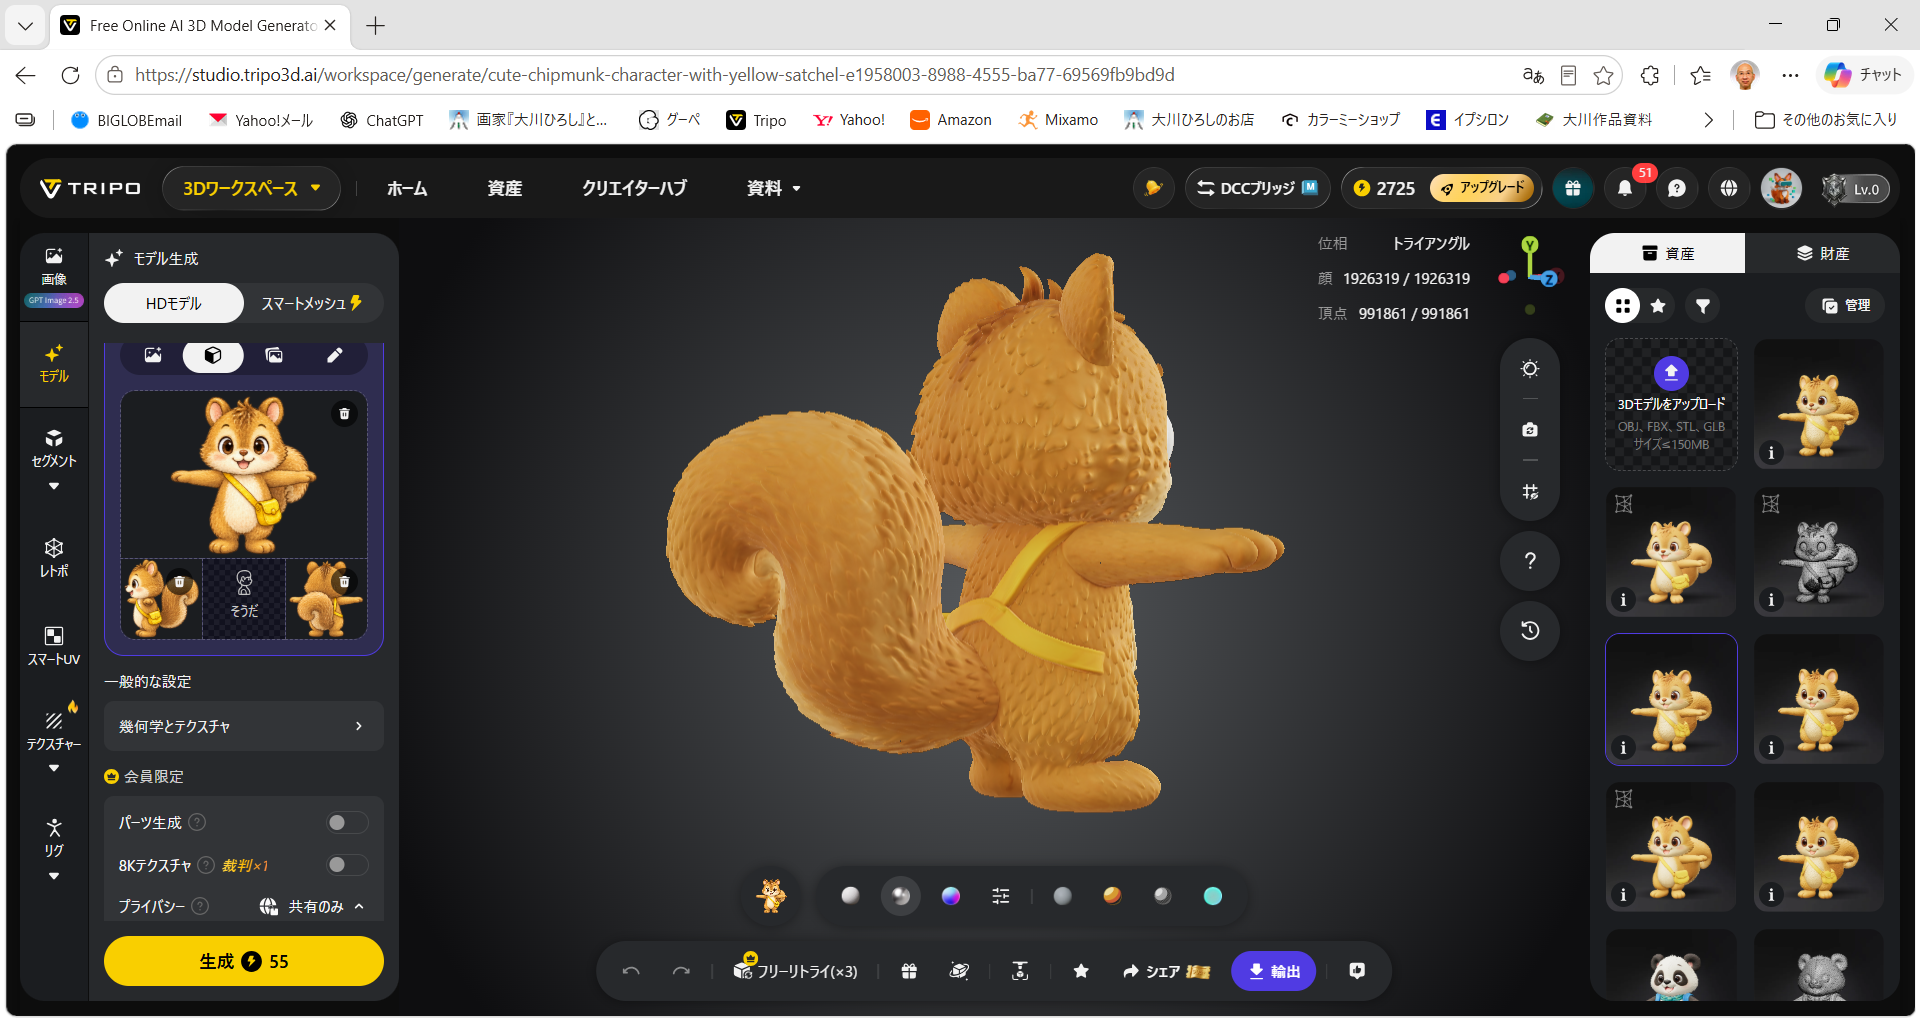
画像説明:
右側面図を除外して生成した結果。尻尾は一本になったが、右側面図に描かれていた右バッグも失われた。
3.左バッグが二つ生成された理由を考える
次に左バッグを検証した。
正面図と左側面図には、どちらにも左バッグが描かれている。
しかし、二つの画像を比較すると、バッグの位置と角度が完全には一致していない。
そこで、
Tripoは、この二つを同じバッグではなく、別々のバッグとして解釈したのではないか
と考えた。
この仮説を確認するため、正面図に描かれている左バッグの位置と角度を人間が修正した。
バッグを少し後方へ移動し、左側面図のバッグへつながるように位置、角度を調整した。
また、この段階では右バッグを使用していなかったため、背面図に残っていた右バッグ用のベルトも削除した。
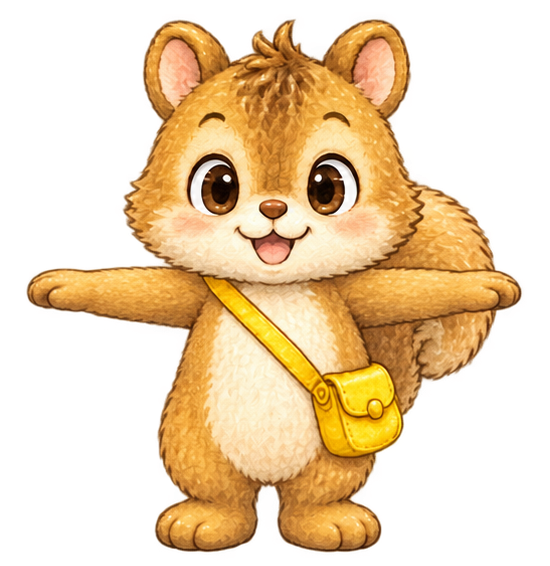
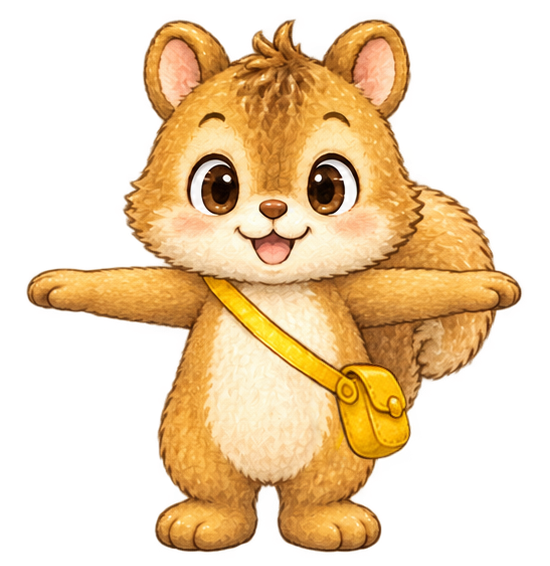
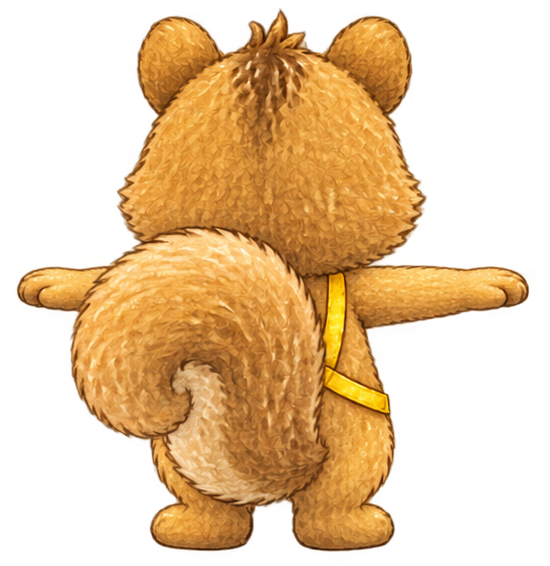
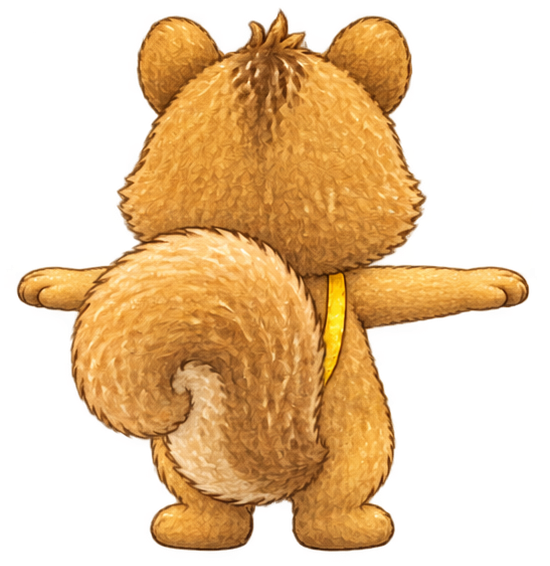
画像説明:
正面図の左バッグの位置と角度を調整し、左側面図との対応関係を修正した。
4.バッグが一つになった
修正した画像から再び3Dモデルを生成した。
結果は明確だった。
二つ存在していた左バッグが、一つになった。
しかもバッグそのもののデザインは維持されている。
入力画像の位置関係を変更したことで、Tripoが正面図と左側面図に描かれたバッグを、同一の物体として扱った可能性が考えられる。
これは今回の検証において重要な結果となった。
単にTripoが「バッグを二つ作る」という誤生成をしていたのではなく、
入力画像間の位置と角度の違いを、それぞれ別の物体として解釈していた可能性
が出てきたからである。
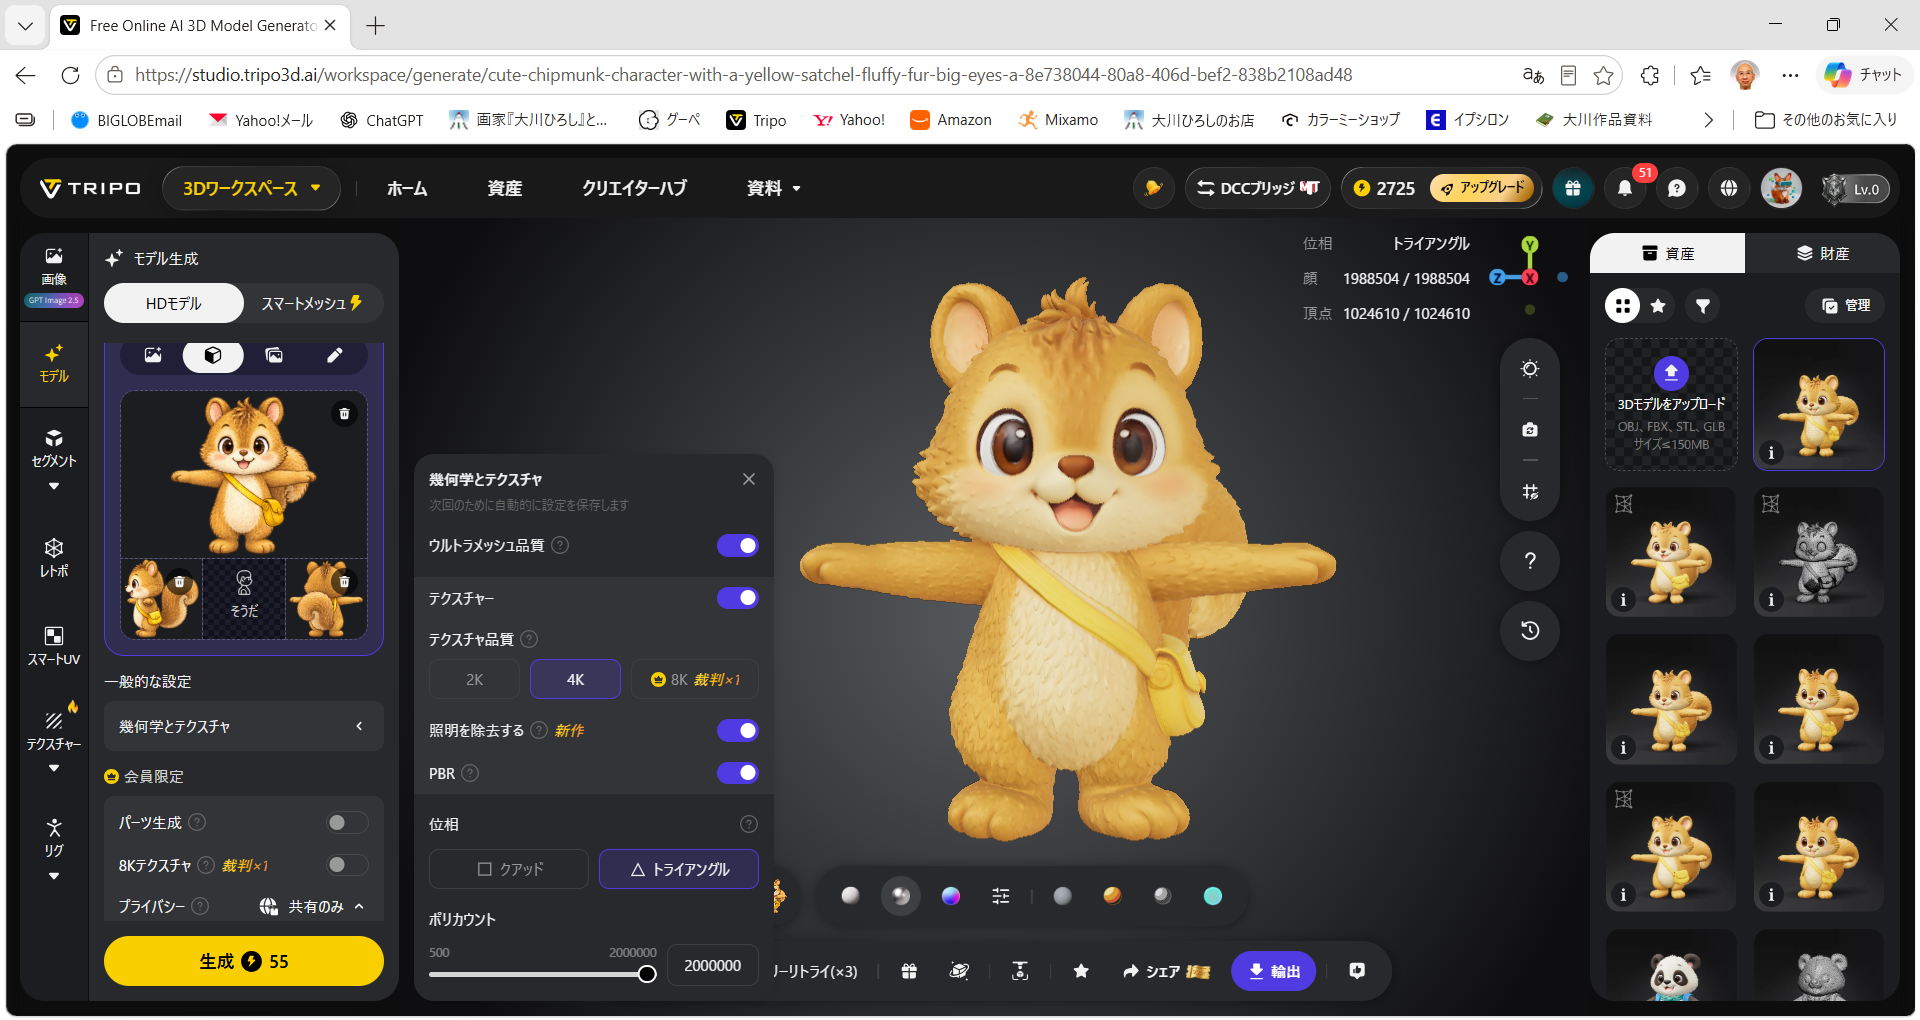
画像説明:
入力画像のバッグ位置を調整した結果、二つ生成されていた左バッグが一つのバッグとして生成された。
5.しかし、リンには左右二つのバッグが必要である
ここで別の問題が生じた。
リンの公式デザインでは、バッグは左側だけではない。
左右両側にバッグを持っている。
したがって、右バッグを消した状態を完成形とすることはできない。
しかし、右側面図をそのまま戻せば、改善した尻尾が再び分岐する可能性がある。
そこで、右側面図そのものを使わないのではなく、
右側面図から尻尾だけを削除する
ことにした。
これによって、右側面図に必要なバッグ情報を残しながら、尻尾については他方向の画像から生成させることを試みた。
6.右バッグが身体へ入り込んだ理由
さらに右バッグについても、入力画像を再検討した。
これまでの4方向画像では、
右側面図には右バッグが描かれているが、正面図には右バッグが描かれていなかった。
ところがTripoは、右側面図に描かれたバッグを無視したわけではない。
3Dモデルには右バッグが存在していた。
ただし、そのバッグは身体へ入り込むように生成されていた。
ここで興味深い解釈が可能になる。
正面図では右バッグが見えない。
しかし右側面図では右バッグが存在する。
Tripoがこの二つの情報を同時に成立させようとした結果、
「正面からは見えないが、右側面からは存在が確認できる位置」
として、バッグを身体へ入り込ませるような形状を生成した可能性がある。
一見すると単純な生成ミスに見える。
しかし、入力画像を忠実に解釈しようとした結果であると考えると、むしろ合理的でもある。
7.右バッグの情報を正面図にも追加する
そこで、正面図にも右バッグを追加することにした。
これによって、
「右側にもバッグが存在する」
という情報を、右側面図だけではなく正面図からもTripoへ与える。
さらに右バッグを復活させるため、背面図についても、ベルトが描かれていた以前の画像へ戻した。
最終的な入力画像では、
右側面図からは尻尾を削除する。
一方で、
右バッグについては正面図にも情報を追加する。
そして、
背面図にはバッグへ続くベルトを残す。
という構成になった。
つまり、すべての情報をすべての画像へ描くのではなく、
3D生成AIが同一の形状として対応付けやすいように、各方向画像へ必要な情報を配置し直した
のである。
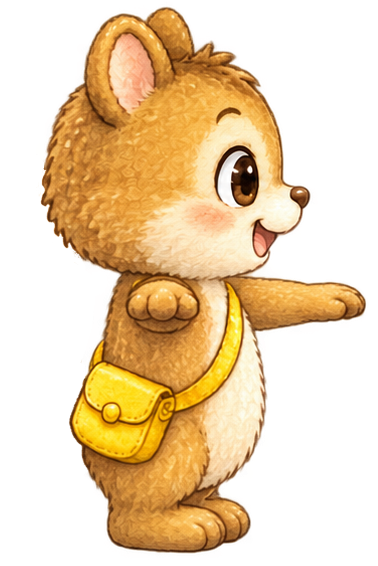
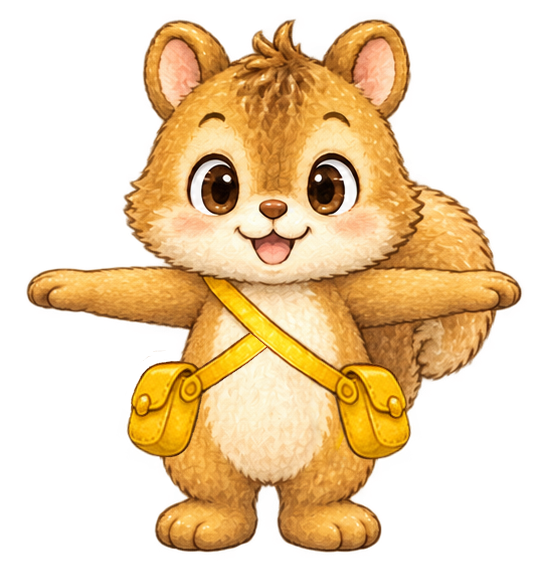
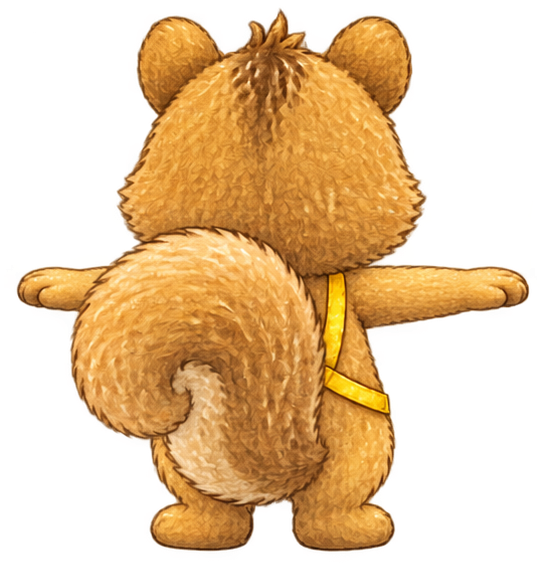
画像説明:
最終入力画像。右側面図では尻尾情報を削除し、正面図には右バッグ情報を追加した。
8.入力画像の再設計によって問題が解消した
修正した画像を使用して、Tripoで再びHDモデルを生成した。
結果は良好だった。
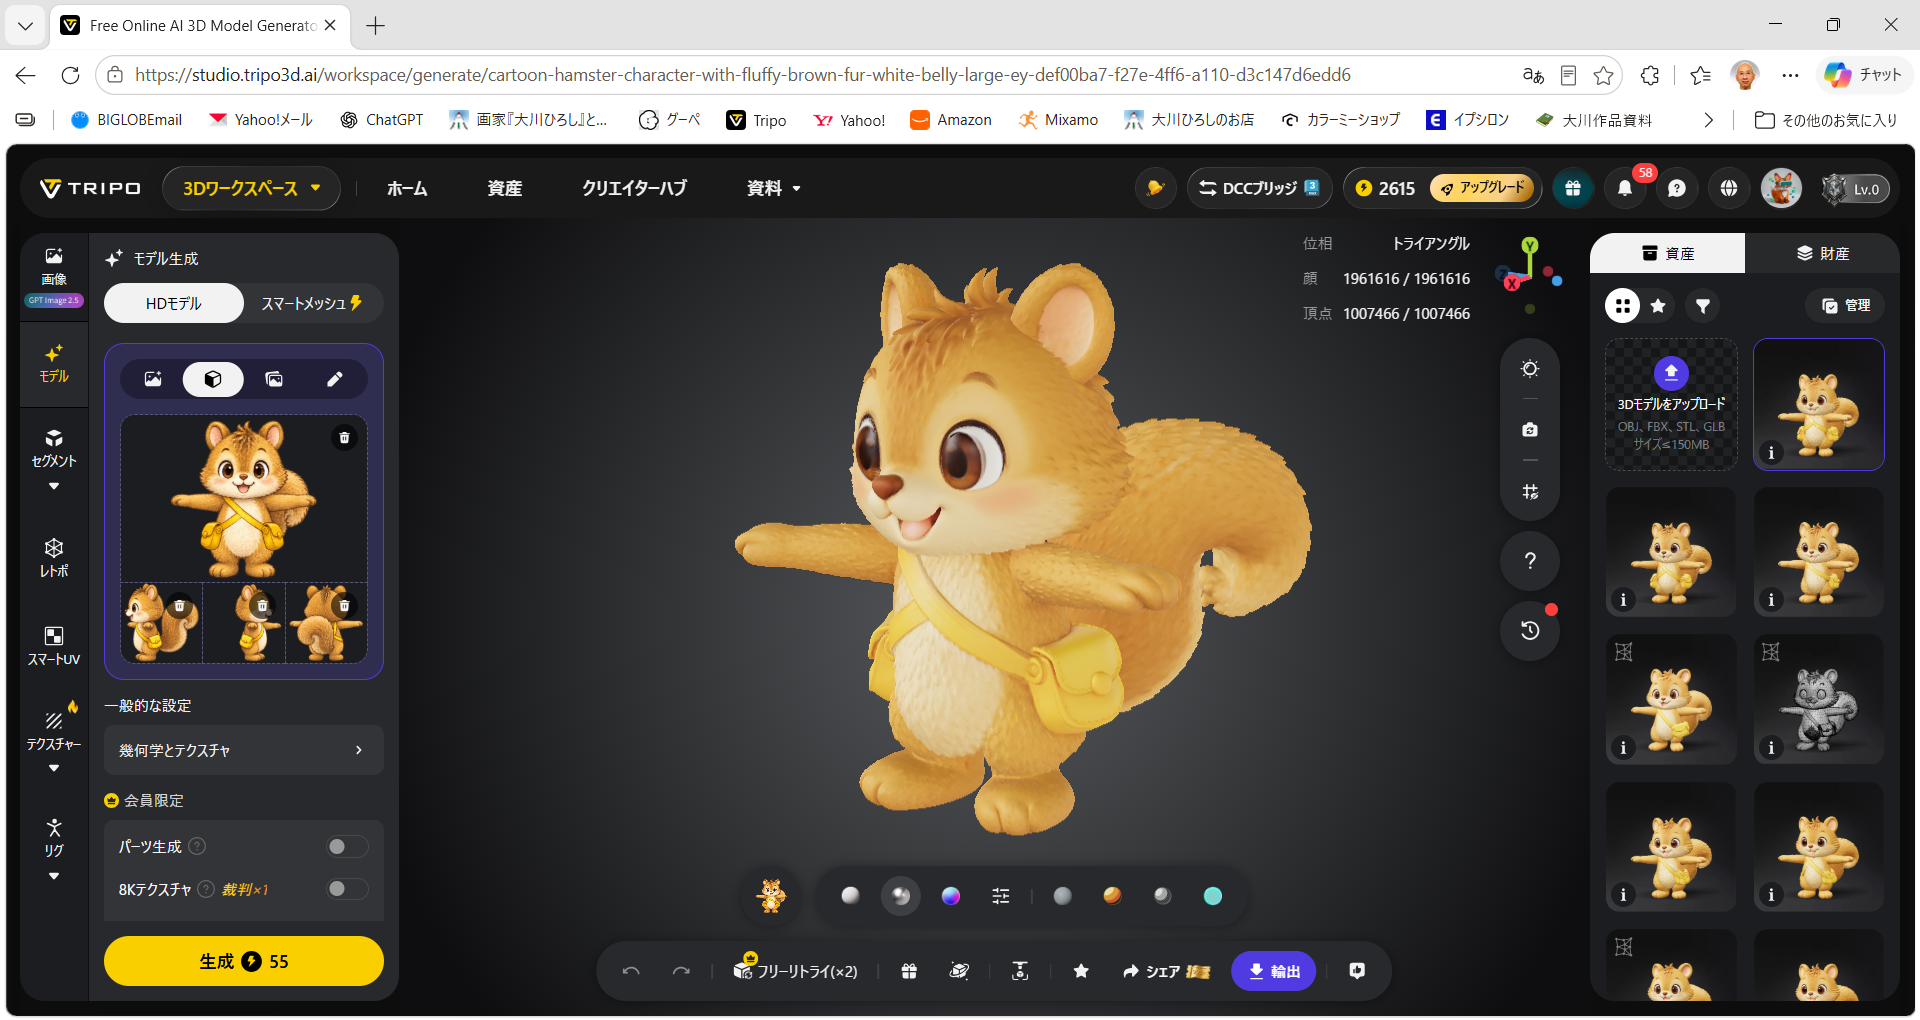
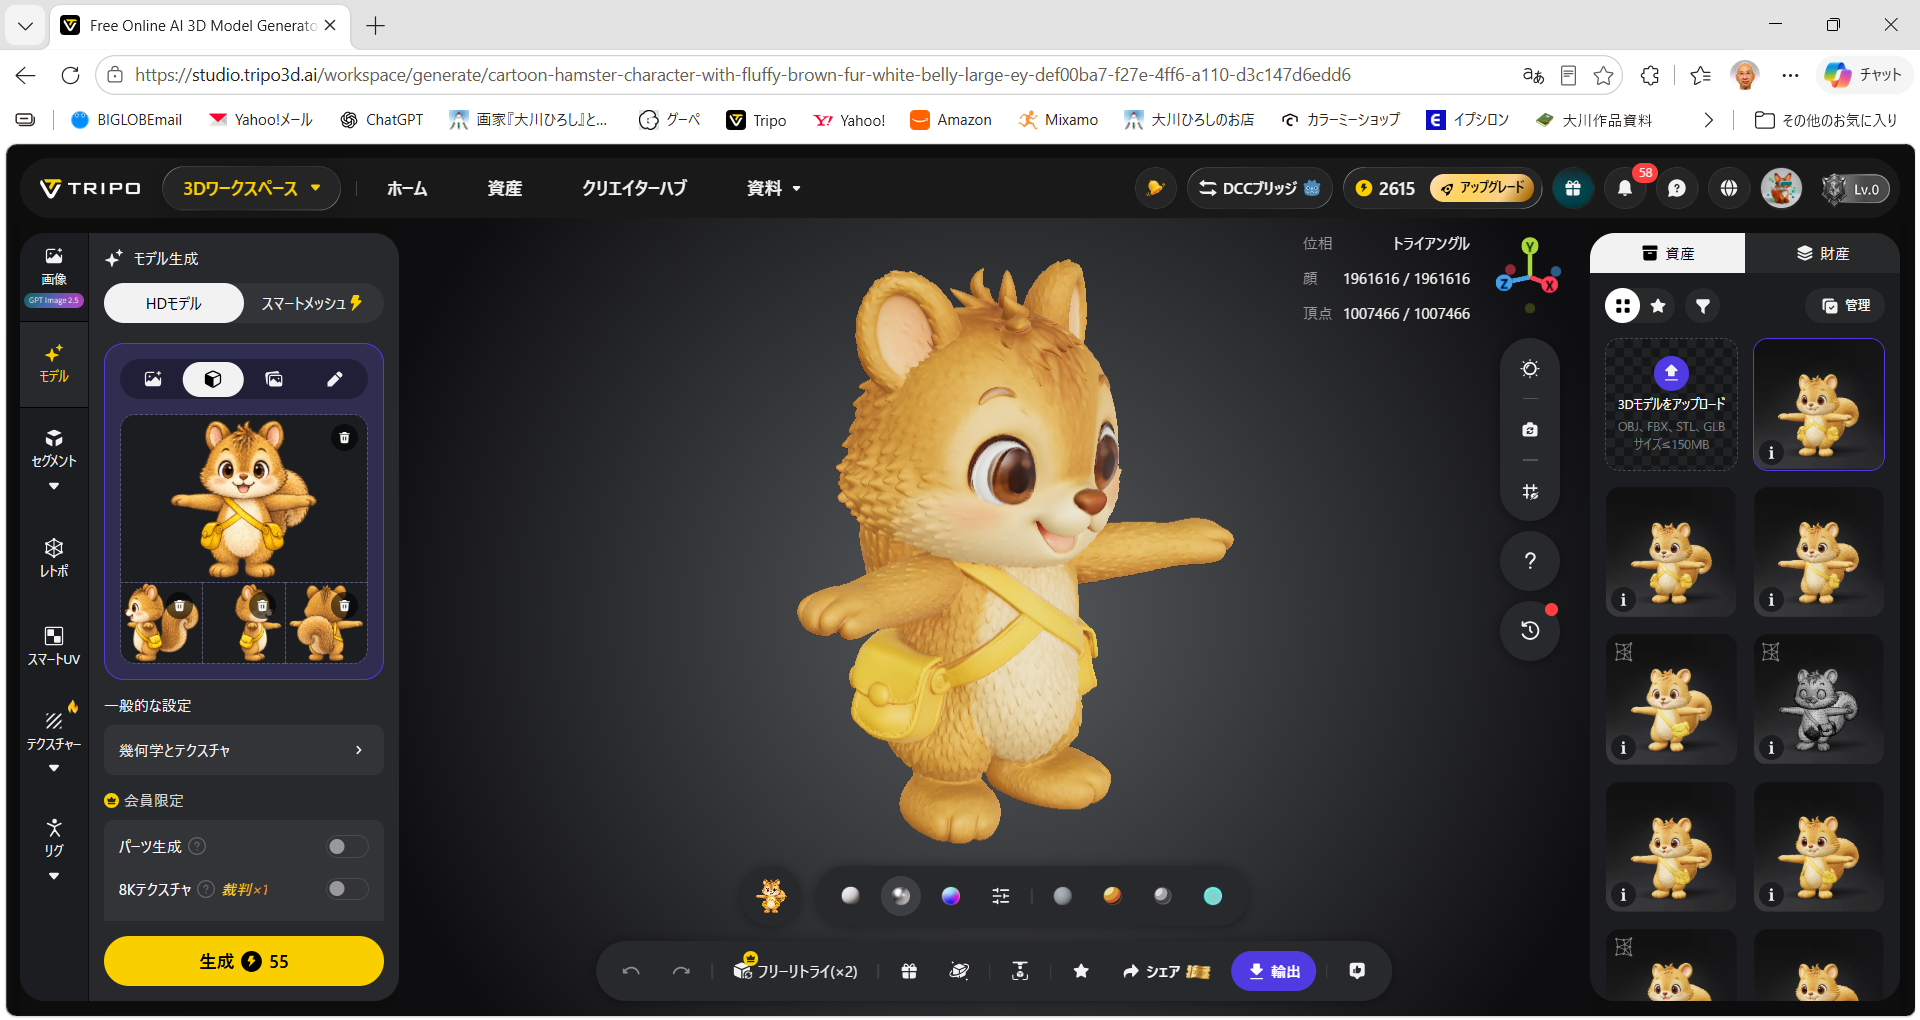
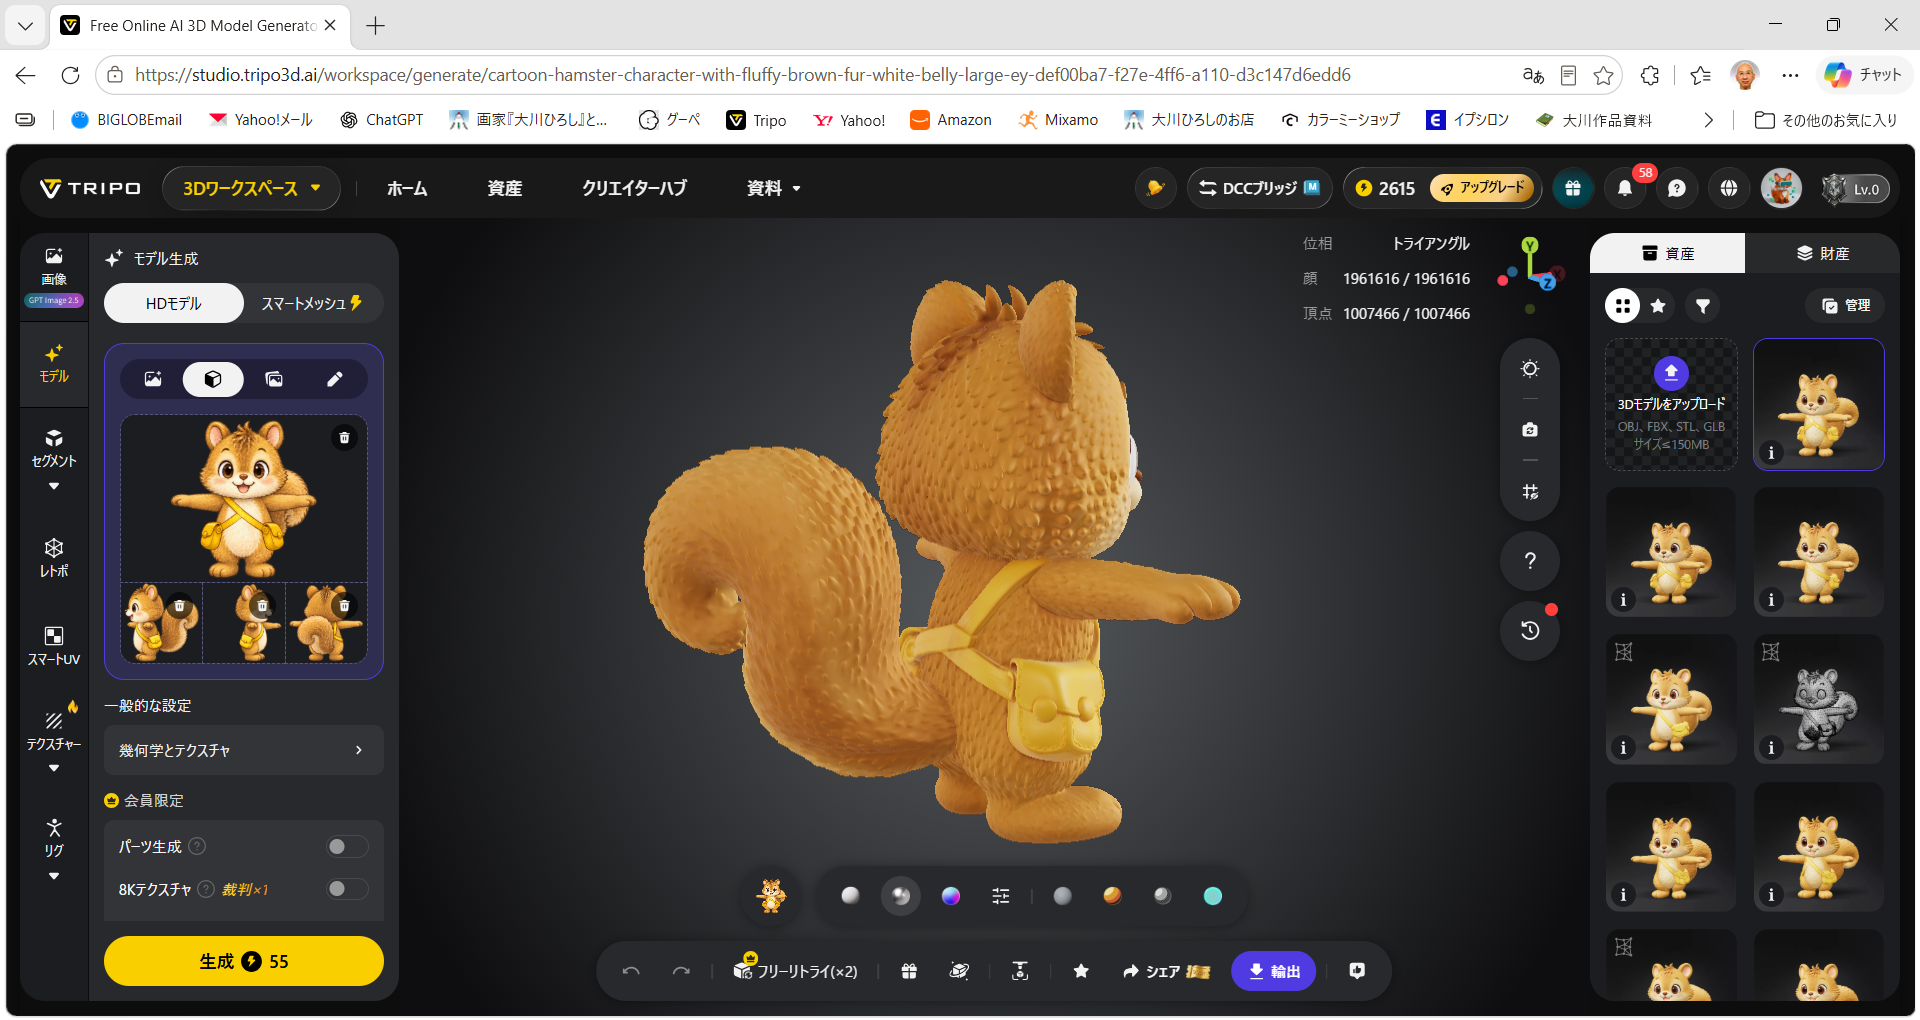
尻尾は一本の大きな巻き尾として成立した。
左バッグは一つになった。
右バッグも独立した形状として生成された。
そして、前面から背面へ続くベルトについても、これまでより自然な形で成立した。
これまで個別に発生していた主要な問題を、3Dモデルを直接編集することなく、入力画像を再設計することで改善することができた。
9.Tripoは本当に「間違えた」のか
今回の結果から、これまで「生成エラー」と考えていた現象を、別の角度から見ることができる。
左バッグについては、正面図と左側面図の位置と角度が異なっていた。
そのため、Tripoが二つのバッグを別の物体として解釈した可能性がある。
右バッグについては、右側面図には存在するが正面図には存在しなかった。
その二つを同時に成立させるため、身体へ入り込む形でバッグを生成した可能性がある。
尻尾についても、複数方向から与えられた複雑な形状情報を統合しようとした結果、先端の分岐や幅の広がりが発生した可能性が考えられる。
もちろん、Tripo内部で実際にどのような処理が行われているのかを今回の実験だけで断定することはできない。
しかし、
入力画像を変更すると、生成結果も予想した方向へ変化した。
これは今回、実際に確認できた事実である。
その意味では、少なくとも今回発生した問題の一部については、
Tripoが画像を正しく読めなかったというより、与えられた画像情報を成立させようとした結果として生じた
と考えることもできる。
10.それでもTポーズは成立した
ここで、さらに興味深い点がある。
バッグや尻尾では、画像間のわずかな違いが3Dモデルへ大きく影響した。
ところがTポーズについては違った。
リンの側面画像では、腕の見え方に正面図や背面図との矛盾が存在していた。
それにもかかわらず、Tripoは最終的に腕を左右へ伸ばしたTポーズとして3Dモデルを生成した。
なぜ、バッグや尻尾では画像の違いをそのまま3D形状へ反映する一方で、Tポーズでは矛盾を吸収できたのだろうか。
これは現時点では仮説である。
Tポーズは、人型キャラクターの3Dモデリングやリギングにおいて一般的に使用される姿勢である。
そのためTripoには、
「Tポーズとはどのような3D形状なのか」
について、学習上の強い基準が存在する可能性がある。
その結果、側面画像に多少の矛盾があっても、正面・背面などの情報と合わせてTポーズとして補完できた可能性が考えられる。
一方、リン固有のバッグの位置や、大きく巻いた尻尾の形状には、そのような一般的な基準が存在しない。
そのため、
一般的な3D構造についてはAIが補完できる場合があるが、キャラクター固有のデザインについては入力画像の整合性がより重要になる
という可能性が見えてきた。
これは今後、ほかのキャラクターを3D化する際にも検証していきたい。
11.入力画像の細かな修正は誰が行うのか
今回の工程では、入力画像そのものを細かく修正する必要があった。
ここで、AI画像生成を使って修正すればよいのではないか、という考え方もある。
しかし、これまでの画像生成実験から、
既存画像の特定部分だけを厳密に変更し、それ以外を完全に維持したまま再生成することは難しい
ことが分かっている。
今回必要だった修正は、
「バッグだけを少し後方へ移動する」
「バッグの角度だけを変える」
「右側面図から尻尾だけを消す」
「正面図に右バッグだけを追加する」
「必要なベルトだけを残す」
といった、局所的で細かな修正である。
しかも、顔、身体のプロポーション、ポーズ、毛並み、色彩など、その他の要素は変更してはならない。
画像生成AIで画像全体を再生成すると、目的とする部分だけではなく、ほかの部分まで変化する可能性がある。
そのため現時点では、
今回のような3D生成用入力画像の精密な整合性調整は、人間が行う必要がある
と判断した。
重要なのは、人間が3Dモデルそのものを作り直したわけではないことである。
人間が行ったのは、
AIが正しい3Dモデルを生成できるように、AIへ与える情報を修正すること
である。
12.HDモデルのフリーリトライについて
今回の制作では、TripoのHDモデルに用意されているフリーリトライも複数回使用した。
その結果、一部の形状が改善されることはあった。
しかし同時に、
ある部分が良くなる一方で、別の部分が悪くなる
ことも確認した。
今回の使用結果を見る限り、HDモデルのフリーリトライは、問題箇所だけを局所的に修正するというより、モデル全体をあらためて生成する性格が強いように見える。
そのため、フリーリトライを繰り返せば、必ず完成形へ近づいていくわけではなかった。
13.AIが作った予想外のデザインを採用する
最終モデルにも、元の画像とは異なる部分が残った。
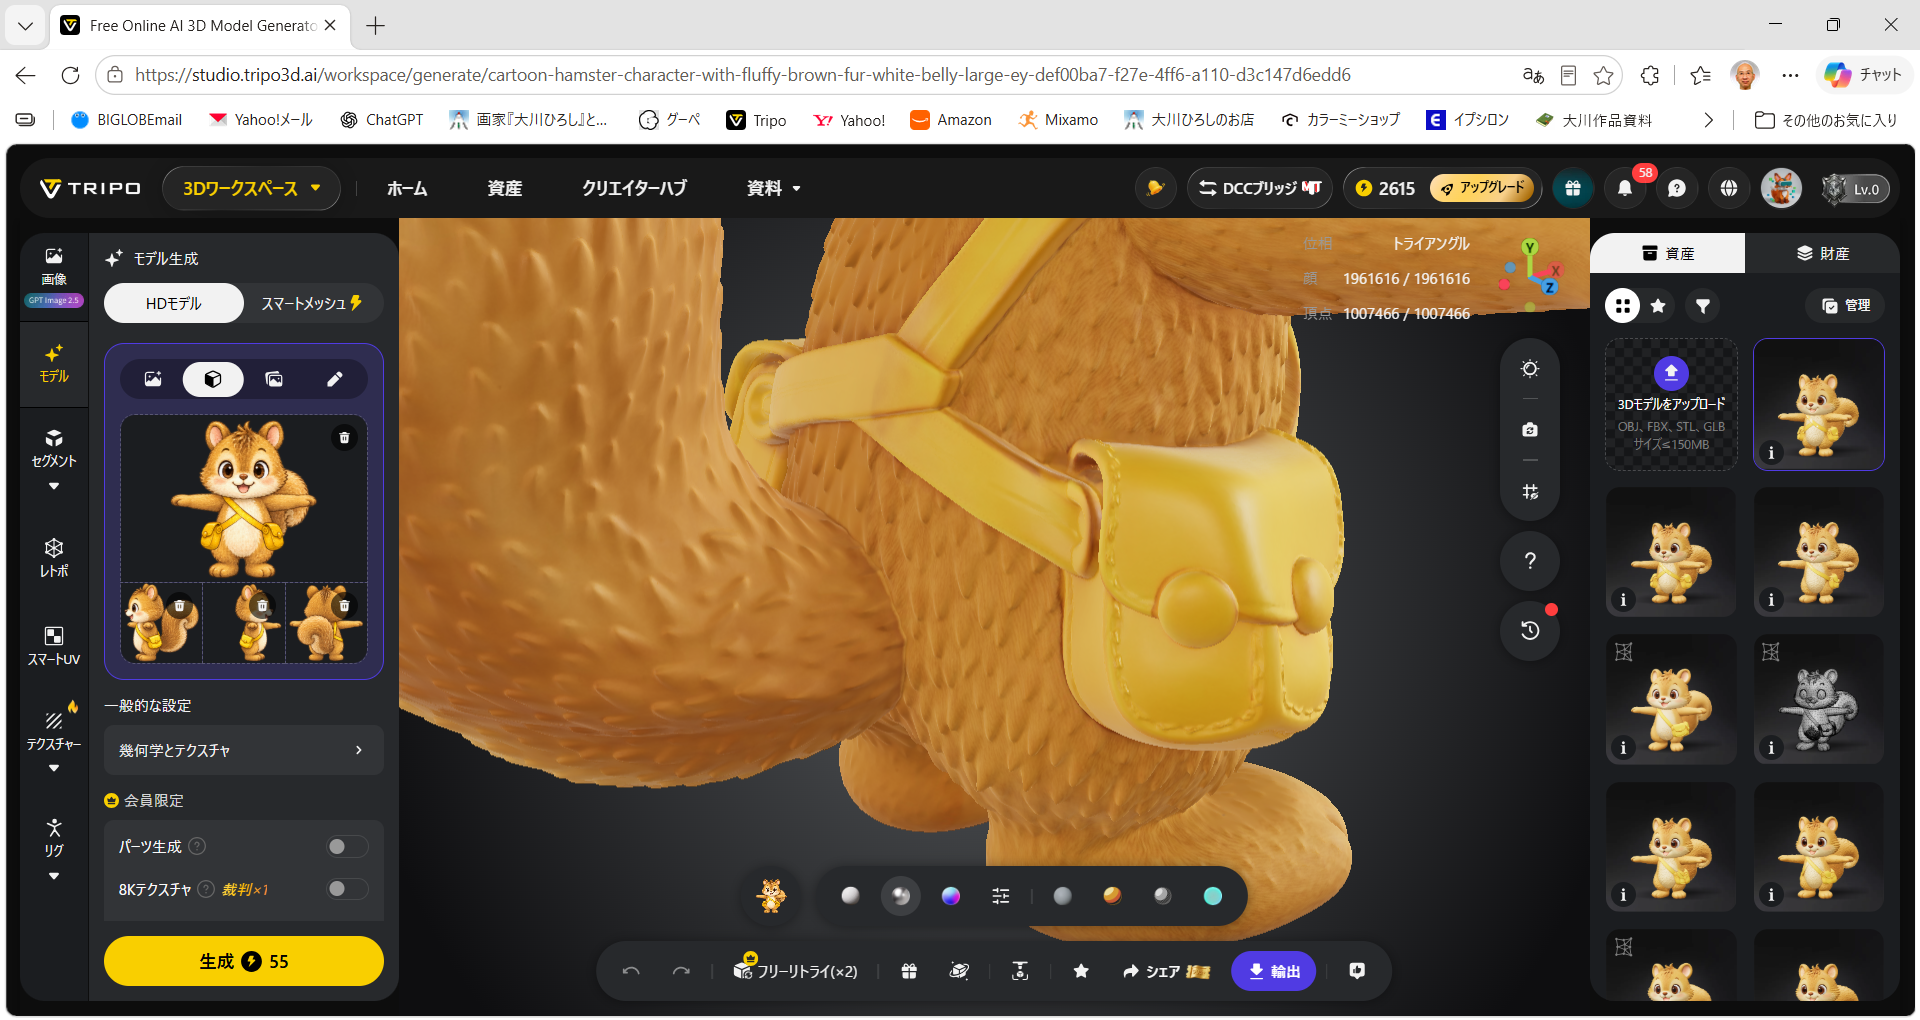
右バッグの背面側に、Tripoによって独自の形状が生成されたのである。
ここでさらにフリーリトライを行うこともできた。
しかし再生成すれば、右バッグが改善される一方で、ようやく成立した尻尾や左バッグ、ベルトなどが再び変化する可能性もある。
そこで今回は、現在のモデルをあらためて確認した。
そして、
この形状もバッグのデザインとして成立している
と判断した。
そのため、さらに再生成するのではなく、このTripoによるデザインを採用することにした。
画像説明:
右バッグ背面に生成された予想外の形状。デザインとして成立していると判断し、そのまま採用した。
14.「正確な4面図」から「AIのための入力設計」へ
前回までの検証では、
3Dモデル生成には正確な4方向画像が重要である
という結論に達した。
今回、その意味がさらに具体的になった。
単純に4枚の画像をきれいに描けばよいのではない。
重要なのは、
複数の画像に描かれた同一パーツが、AIから見ても同じ物体として対応付けられること
である。
そして、必ずしも情報量を増やせば精度が上がるとは限らない。
今回の尻尾では、右側面図から尻尾情報を削除したことで改善した。
反対に右バッグでは、正面図にもバッグ情報を追加することで改善した。
つまり、
情報が多いか少ないかではなく、AIへどの情報を、どの方向から、どのような関係で与えるか
が重要なのである。
従来の4面図は、人間のモデラーへキャラクターの形状を伝えるための設計資料だった。
しかしAIによる3Dモデル生成では、それに加えて、
AIが複数画像の情報を矛盾なく3D空間へ対応付けられるように設計された入力資料
という新しい役割が必要になる。
今回の検証結果
今回の実験では、3D生成AIによって発生した問題に対して、生成後の3Dモデルを直接修正するのではなく、入力画像側へ戻って原因を検証した。
その結果、
問題発見
→ 原因の推定
→ 入力情報を変更
→ AIによる再生成
→ 結果を比較
→ 入力情報を再設計
→ 再生成
→ 人間による評価・採用
という制作工程が成立した。
これは単なる「修正作業」ではない。
AIの生成結果を観察し、
AIが入力情報をどのように解釈したのかを逆算し、次の入力を設計する工程
である。
今回、人間は3Dモデルを直接モデリングして完成させたのではない。
人間は問題を発見し、原因を推定し、AIへ渡す情報を設計し直した。
そして3Dモデルそのものは、再びAIによって生成された。
さらに、AIが元画像には存在しない形状を生成した場合でも、それが作品として成立すると人間が判断すれば、デザインとして採用することができる。
ここでも最終的な判断を行ったのは人間である。
まとめ
今回のリンの3Dモデル制作では、一見するとTripoの「誤り」に見えた形状が、実は入力画像に存在する矛盾を3D空間上で成立させようとした結果である可能性が見えてきた。
そして、その原因を推定し、入力画像の情報を整理することで、尻尾、バッグ、ベルトの問題を大きく改善することができた。
今回の実験から得られた重要な知見は、
AIに多くの情報を与えれば、必ず生成精度が高くなるわけではない
ということである。
必要なのは、
AIが複数の画像を一つの3D構造として解釈できるように、情報の整合性を設計すること
である。
さらに、Tポーズのような一般的な3D構造についてはAI自身が画像間の矛盾を補完できる可能性がある一方、バッグや尻尾などキャラクター固有のデザインでは、より正確な入力設計が必要になる可能性も示された。
そして現時点では、その入力画像に対する局所的で精密な修正は、人間が担当する必要がある。
今回の制作工程を整理すると、
AIが生成し、人間が評価する。
人間が入力情報を修正し、AIが再び生成する。
その結果を人間が評価し、最終的に採用する。
という循環になる。
3D生成AIを使用するということは、人間が制作から離れることではない。
むしろ、
人間の仕事が「3D形状を直接作ること」から、「AIが正しく生成できる情報を設計し、その結果を評価すること」へ移り始めている。
今回のリンの制作は、その変化を具体的な制作工程として確認する実験となった。
第15回 4面図の正確性とAI時代の3Dモデリング工程
AIゲーム開発研究室
3Dモデル制作ドキュメント
第15回
4面図の正確性とAI時代の3Dモデリング工程
研究代表 大川 博
主任研究員 Arc(ChatGPT)
はじめに
前回までに、5人のキャラクターを3Dモデル化するためのTポーズ4面図を制作した。
今回は、その中からリンを使用してTripoによる3Dモデル生成を行う。
リンのTポーズ4面図には、今回の検証に適した特徴があった。
正面と背面では両腕が水平に伸びたTポーズになっているが、側面では腕の見え方が完全には一致していない。
また、大きく巻いた尻尾や黄色いバッグについても、4方向の画像間で位置や形状に若干の不整合がある。
そこで今回は、これらをあえてそのままTripoへ入力し、
4面図に多少の不整合があった場合、3D生成AIはどこまでそれを補完できるのか
を検証することにした。
さらに、生成後に発見された問題に対して、Smart Mesh、Mesh Edit、Free Retry、Segmentationなど、Tripoに用意されている修正・生成機能も実際に試した。
その結果、今回の実験から二つの重要な成果が得られた。
一つは、
3D生成AIを使用する場合でも、入力する4面図の正確性が極めて重要であること。
もう一つは、
最初からゲーム用の低ポリゴンモデルを生成するのではなく、まず高精細モデルを生成し、その後ゲーム用ポリゴン数まで大幅に軽量化する
という、AI時代の新しい3Dモデリング工程の可能性である。
1.リンのTポーズ4面図から3Dモデルを生成する
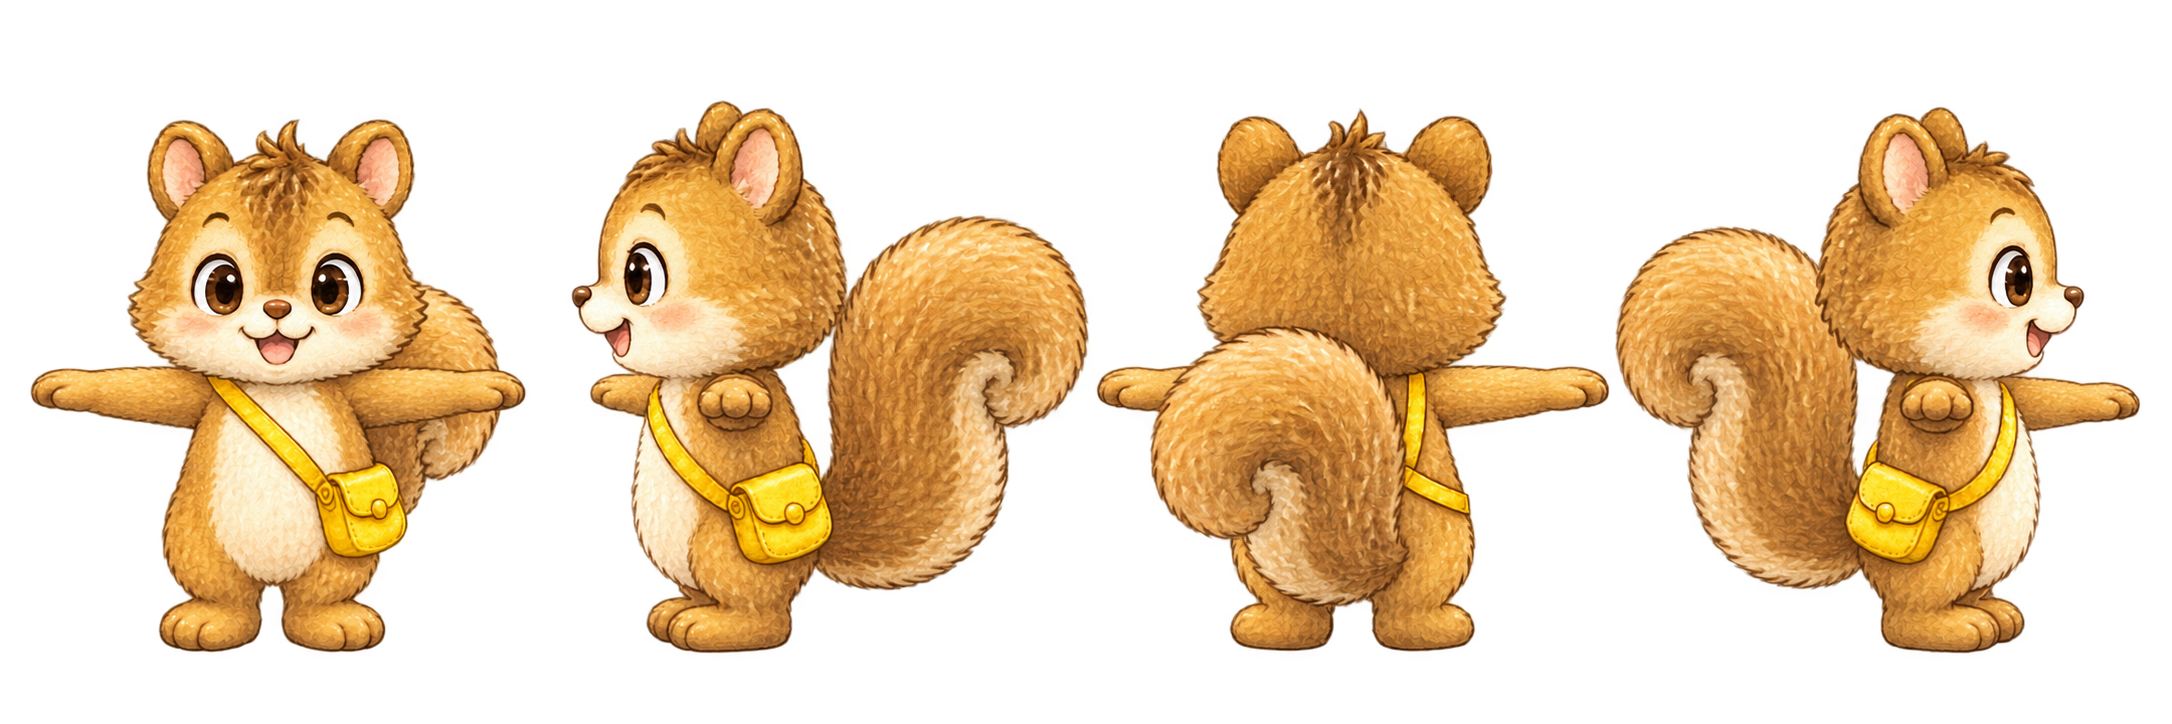
最初に、リンのTポーズ4面図を4枚の画像に分割し、TripoのMulti-viewへ入力した。
今回は、最初からゲーム用の軽量モデルを作るのではなく、まず可能な限り高品質なモデルを作る。
そのためHDモデルを使用し、高品質設定で生成した。
生成されたモデルは約190万Facesとなった。
完成したモデルを確認すると、リンの顔や身体、大きな尻尾などが高い品質で立体化されていた。
しかし今回重要なのは、単純な造形品質ではない。
4方向画像の不整合をTripoがどのように解釈したのか。
そこを詳しく確認することにした。
2.曖昧だった腕は正しいTポーズになった
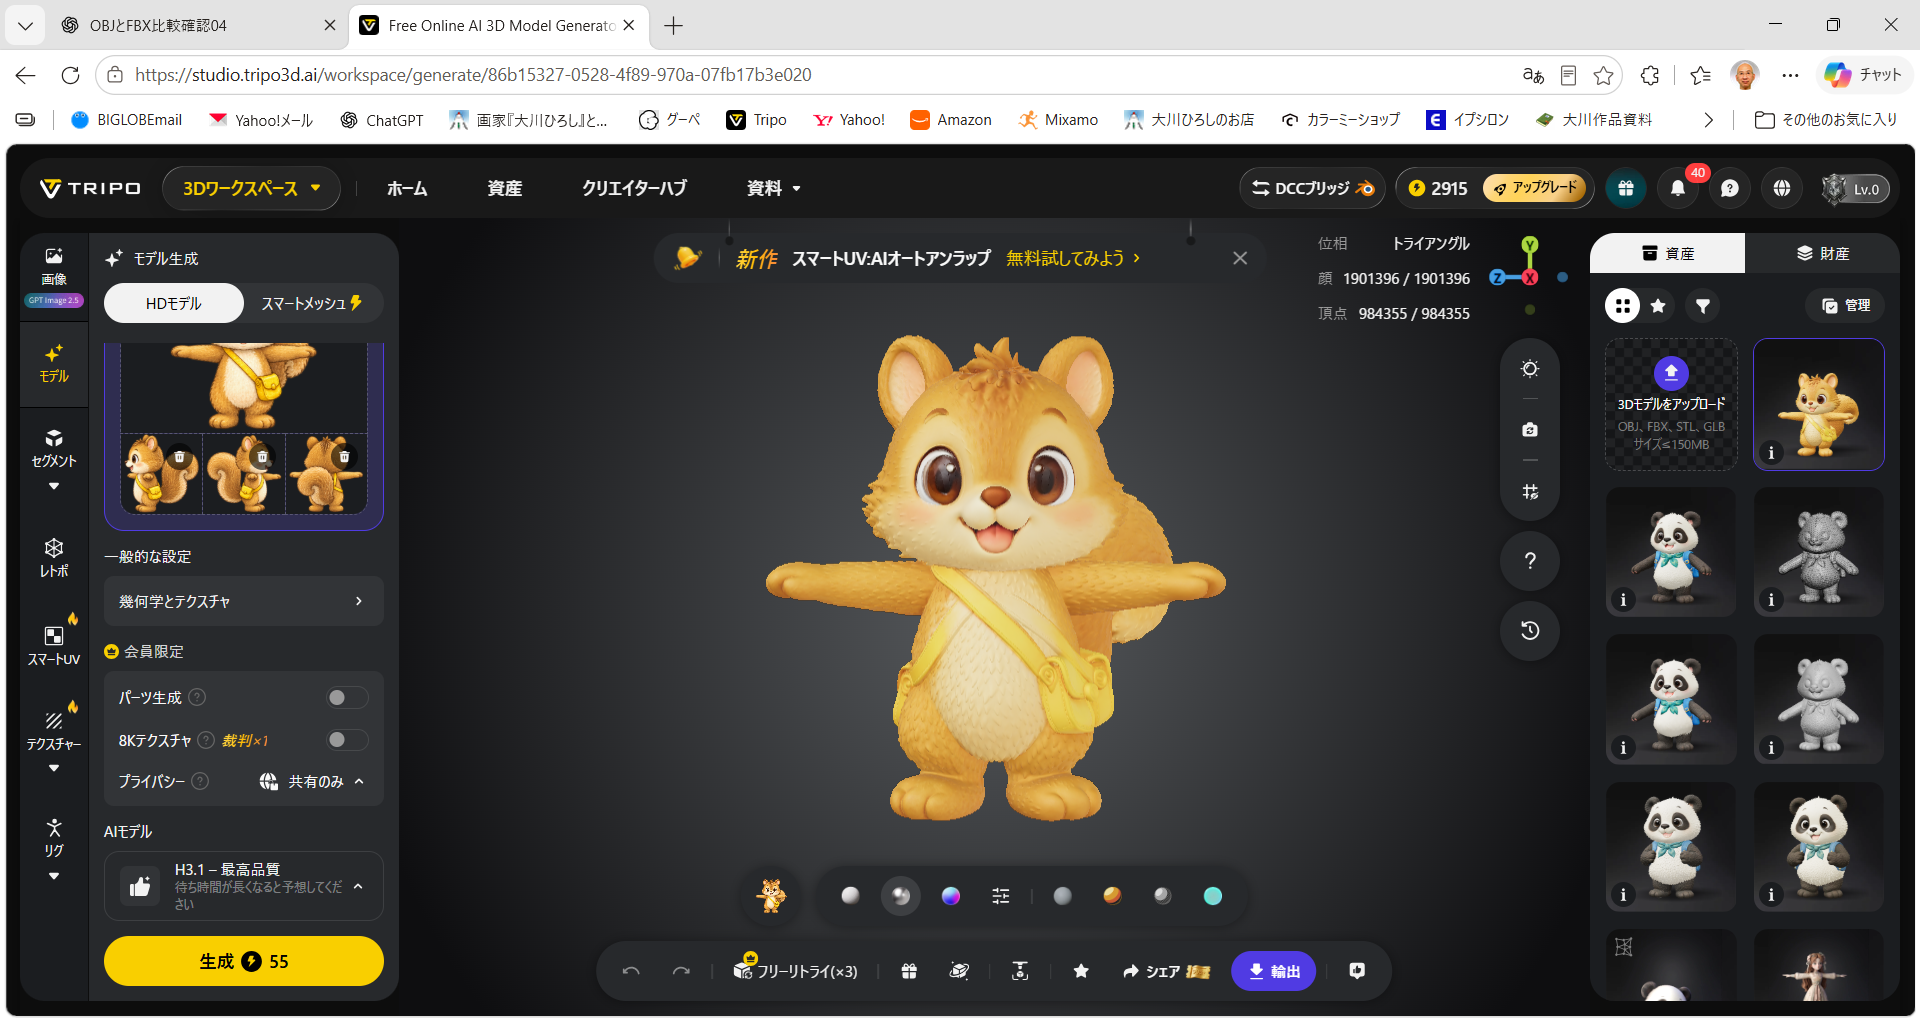
最初に確認したのは腕である。
元の4面図では、正面と背面は明確なTポーズになっている。
しかし側面図では、腕の見え方が正面・背面と完全には一致していない。
そのため、
この状態から本当にTポーズとして立体化できるのか
が最初の検証項目だった。
結果は成功だった。
生成された3Dモデルでは、左右の腕が水平に伸び、きれいなTポーズになっていた。
Tripoは単純に各方向の画像をそのまま立体化するのではなく、複数の画像から形状を判断し、Tポーズとして成立するように補完したと考えられる。
Tポーズは3Dキャラクター制作で広く使用される基本姿勢である。
そのため、Tripoが学習しているTポーズに関する情報が、今回の補完に影響した可能性がある。
ただし、これは生成結果からの推測であり、Tripo内部の処理を確認したものではない。
3.尻尾の先端が二つに分かれた
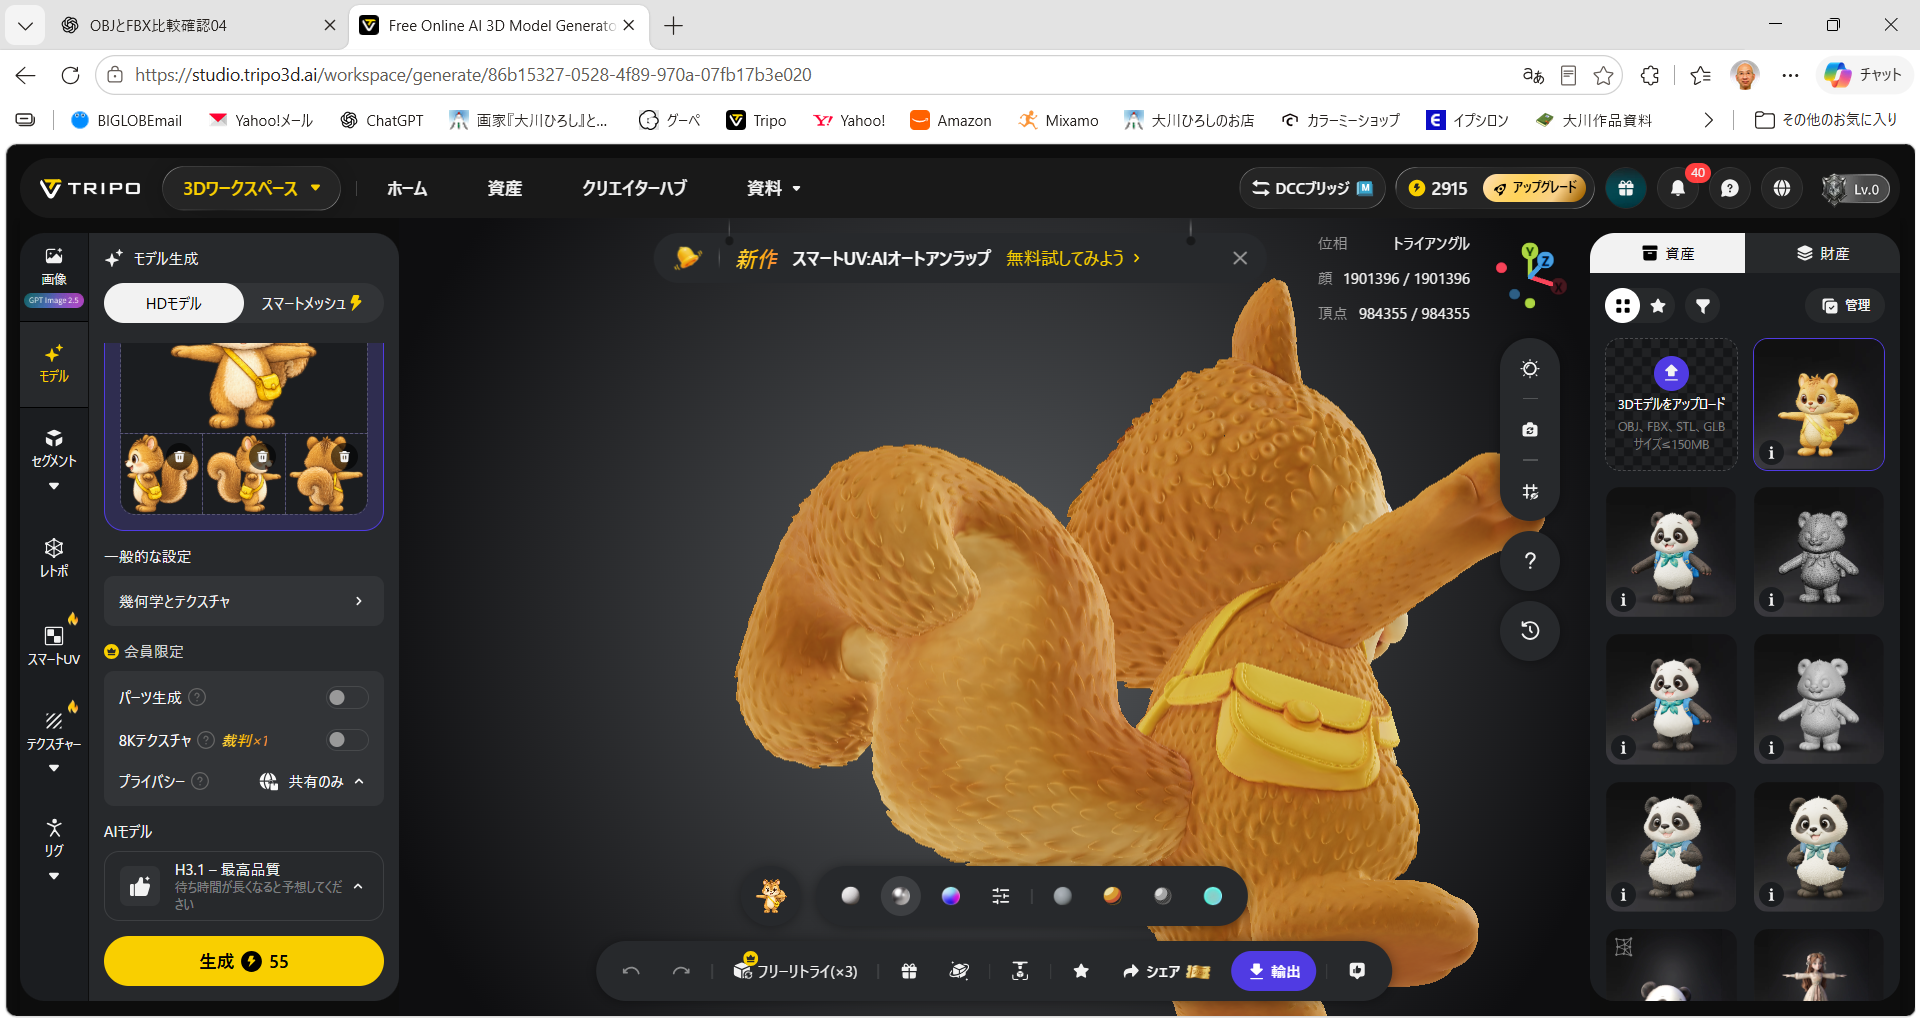
腕では柔軟な補完が行われた。
しかし、リン固有の形状では同じ結果にはならなかった。
リンには、大きく巻いた特徴的な尻尾がある。
生成された3Dモデルを見ると、尻尾全体の形状はかなり良好に立体化されていた。
ところが、巻き込んだ先端部分を詳しく確認すると、
尻尾の先端が左右二つに分かれていた。
大きな尻尾を複数方向から描いたことで、それぞれの画像に現れた先端部分の位置関係を、一つの形状として完全には統合できなかったと考えられる。
ここでも重要なのは、Tripoが勝手に原画を無視したわけではないということである。
むしろ、
4面図に描かれている情報を忠実に3D形状として成立させようとした結果
と考える方が自然である。
4.バッグは3個生成された
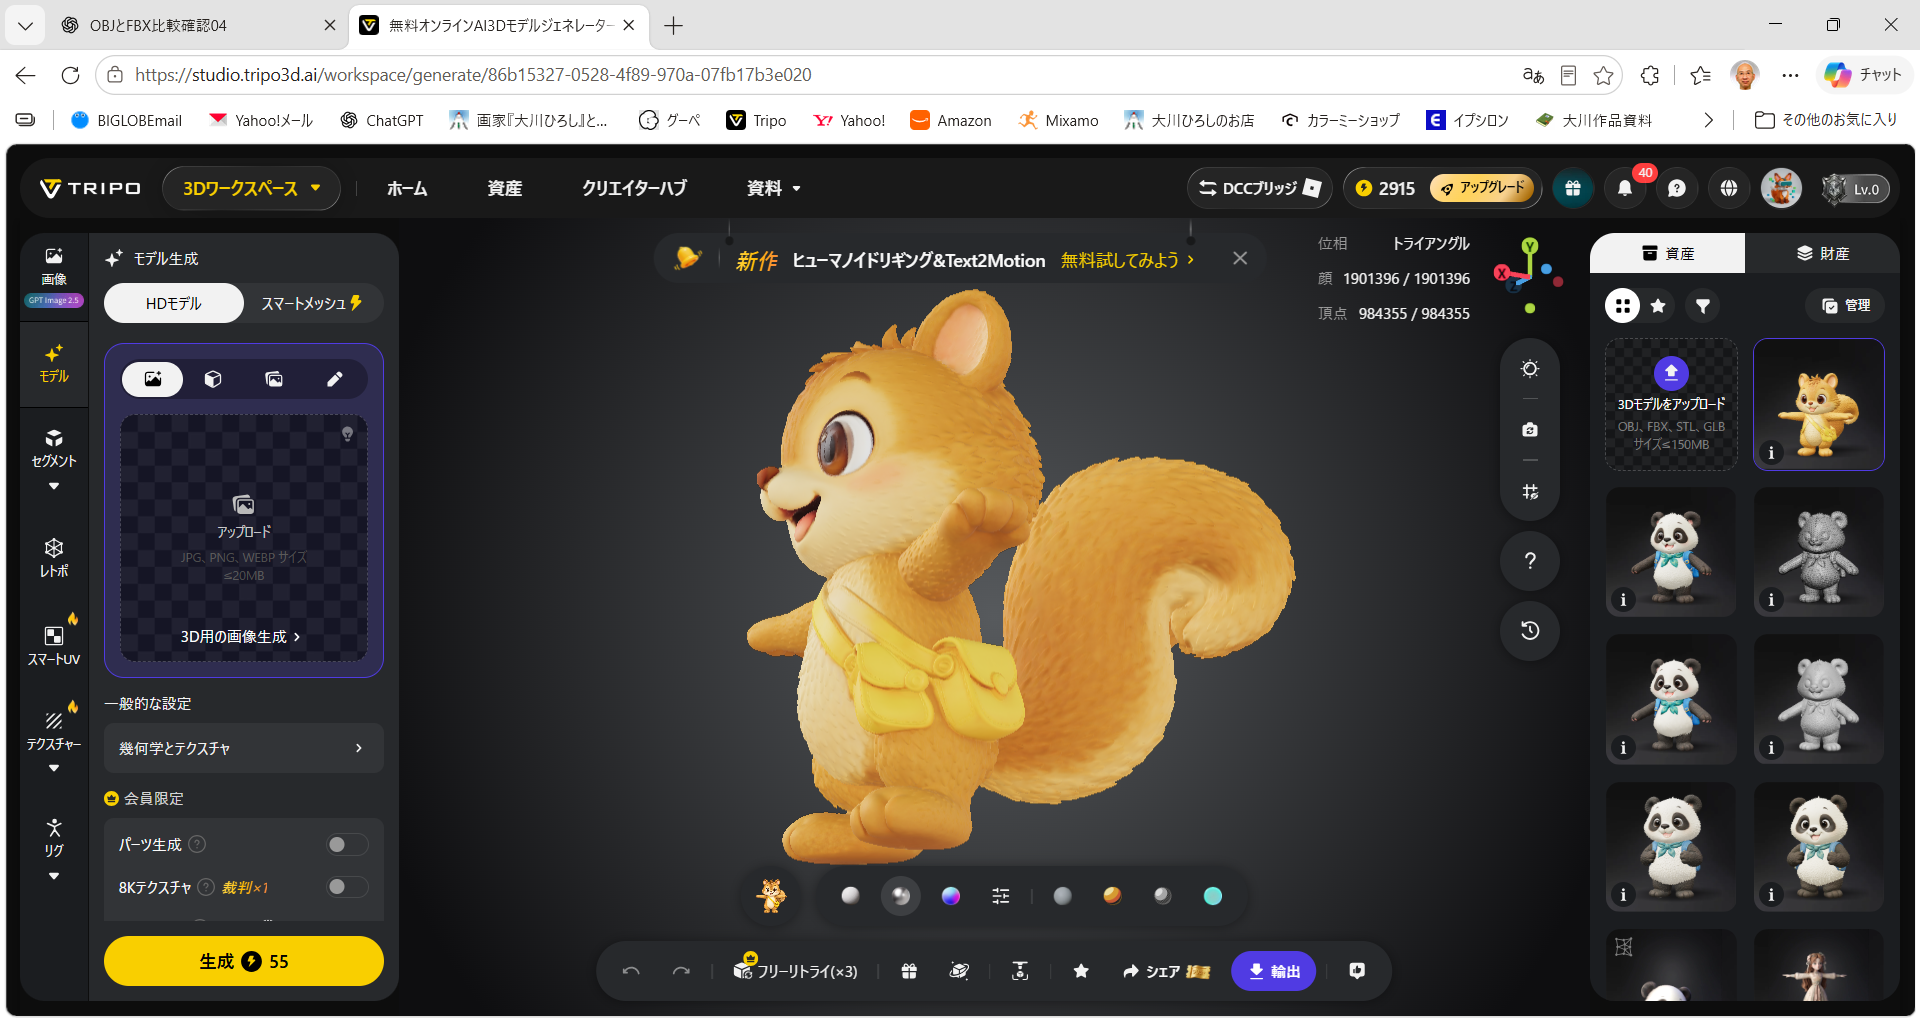
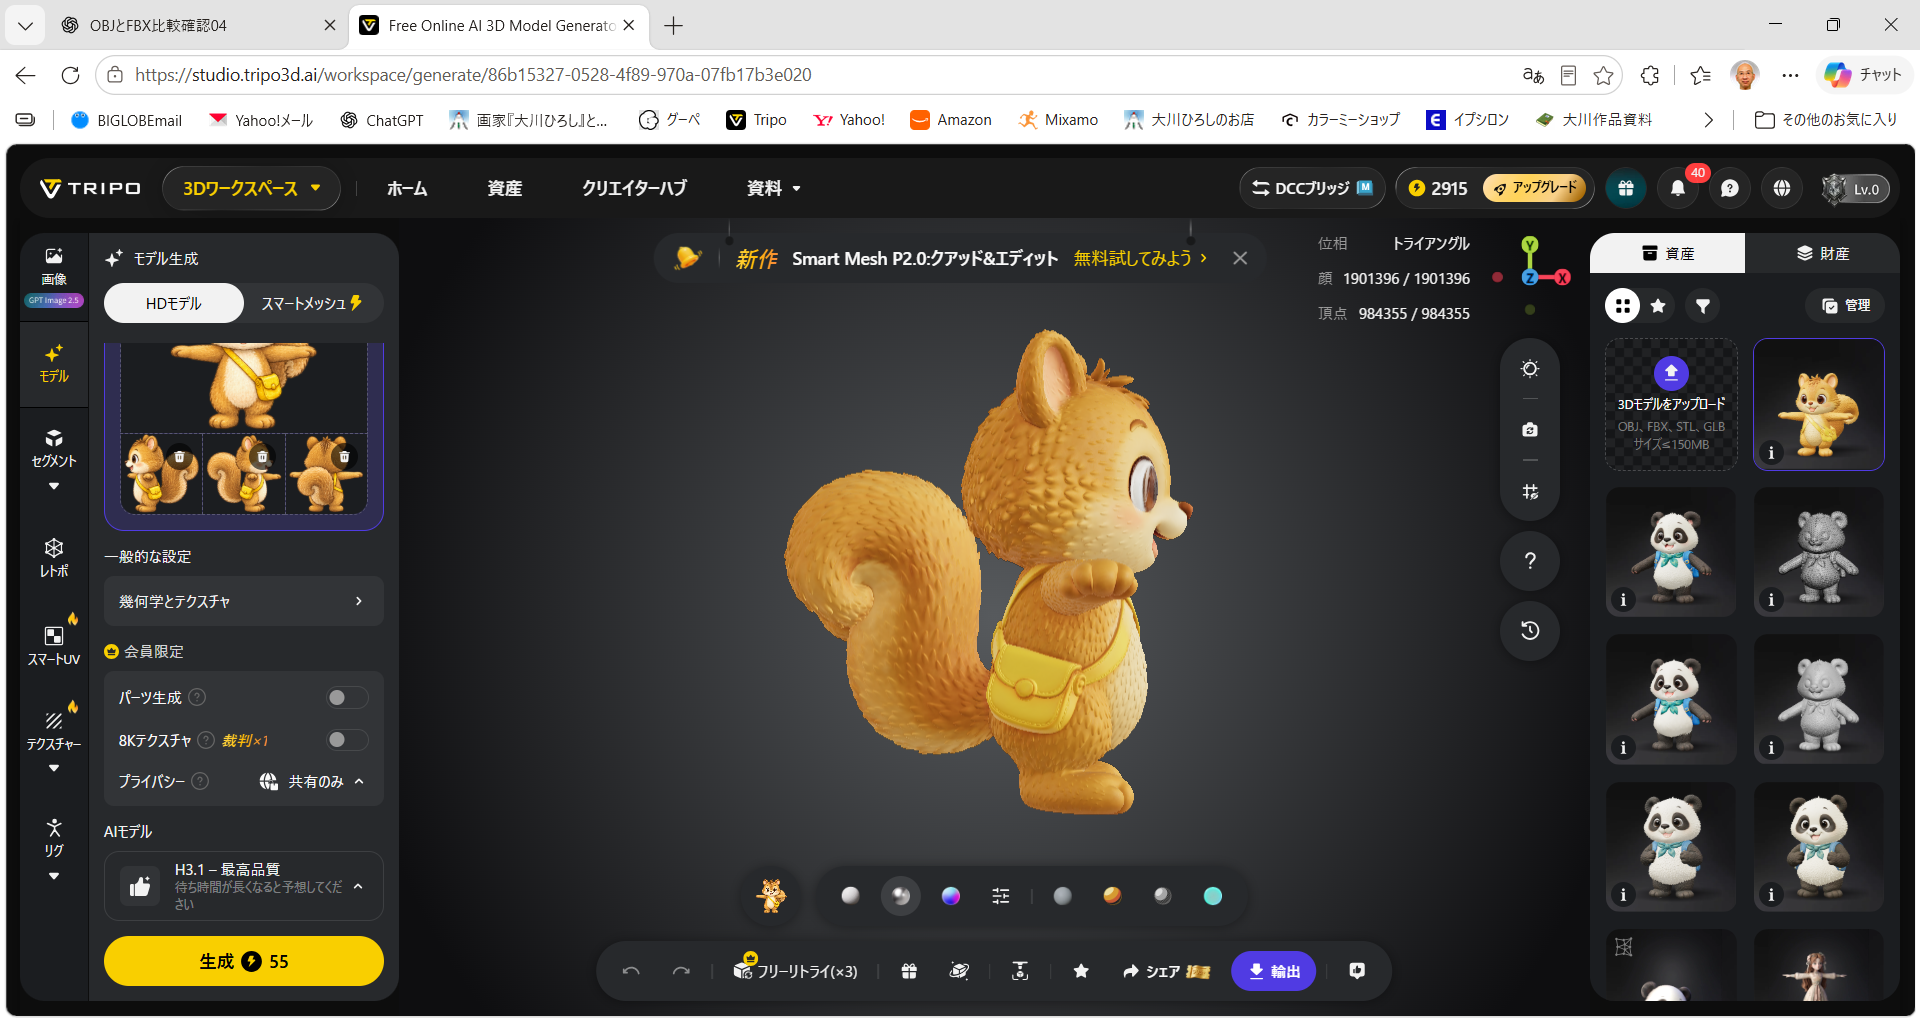
バッグについても同様の問題が発生した。
リンのデザインでは、本来、左右に一つずつバッグが存在する。
ところが生成された3Dモデルでは、
左側に2個、右側に1個
合計3個のバッグが生成された。
4方向画像では、見る方向によってバッグの位置が異なる。
人間であれば、それらを同じバッグを別方向から見たものとして理解できる。
しかし今回のTripoは、一部の情報を同一のバッグとして統合せず、別の形状として生成した。
さらにベルトについても、身体へ溶け込むような形で生成された部分が確認された。
腕ではAIによる補完が成功した一方、バッグでは原画の位置情報が強く反映された。
5.AIは原画の間違いを必ず直してくれるわけではない
ここまでの結果は非常に興味深い。
腕については、多少の不整合があっても正しいTポーズとして生成された。
一方、尻尾やバッグでは、4面図の不整合がそのまま3D形状の問題として現れた。
つまり、
Tripoには入力画像の曖昧さを補完する能力がある。
しかし、
すべての不整合を「間違い」と判断して修正してくれるわけではない。
特に、バッグや尻尾のようなキャラクター固有の形状については、AIにとって何が正しいのかを判断する基準が十分に存在しない。
その場合、AIは入力された画像をできるだけ忠実に再現しようとする。
今回の実験から、
3D生成AIの性能が高くなっても、入力する4面図の正確性が不要になるわけではない。
ことが確認された。
むしろAIへ3Dモデル生成を任せるからこそ、
AIへ渡す原画そのものを正確に制作することが重要になる。
6.生成後に修正できないか
ここからは、生成された問題をTripo内部の機能で修正できないかを検証した。
今回試したのは、
Smart Mesh
Mesh Edit
Free Retry
Segmentation
である。
当初予定していた実験ではなかったが、結果としてTripoの修正機能の性質を確認する重要な検証となった。
7.Smart Meshを試す
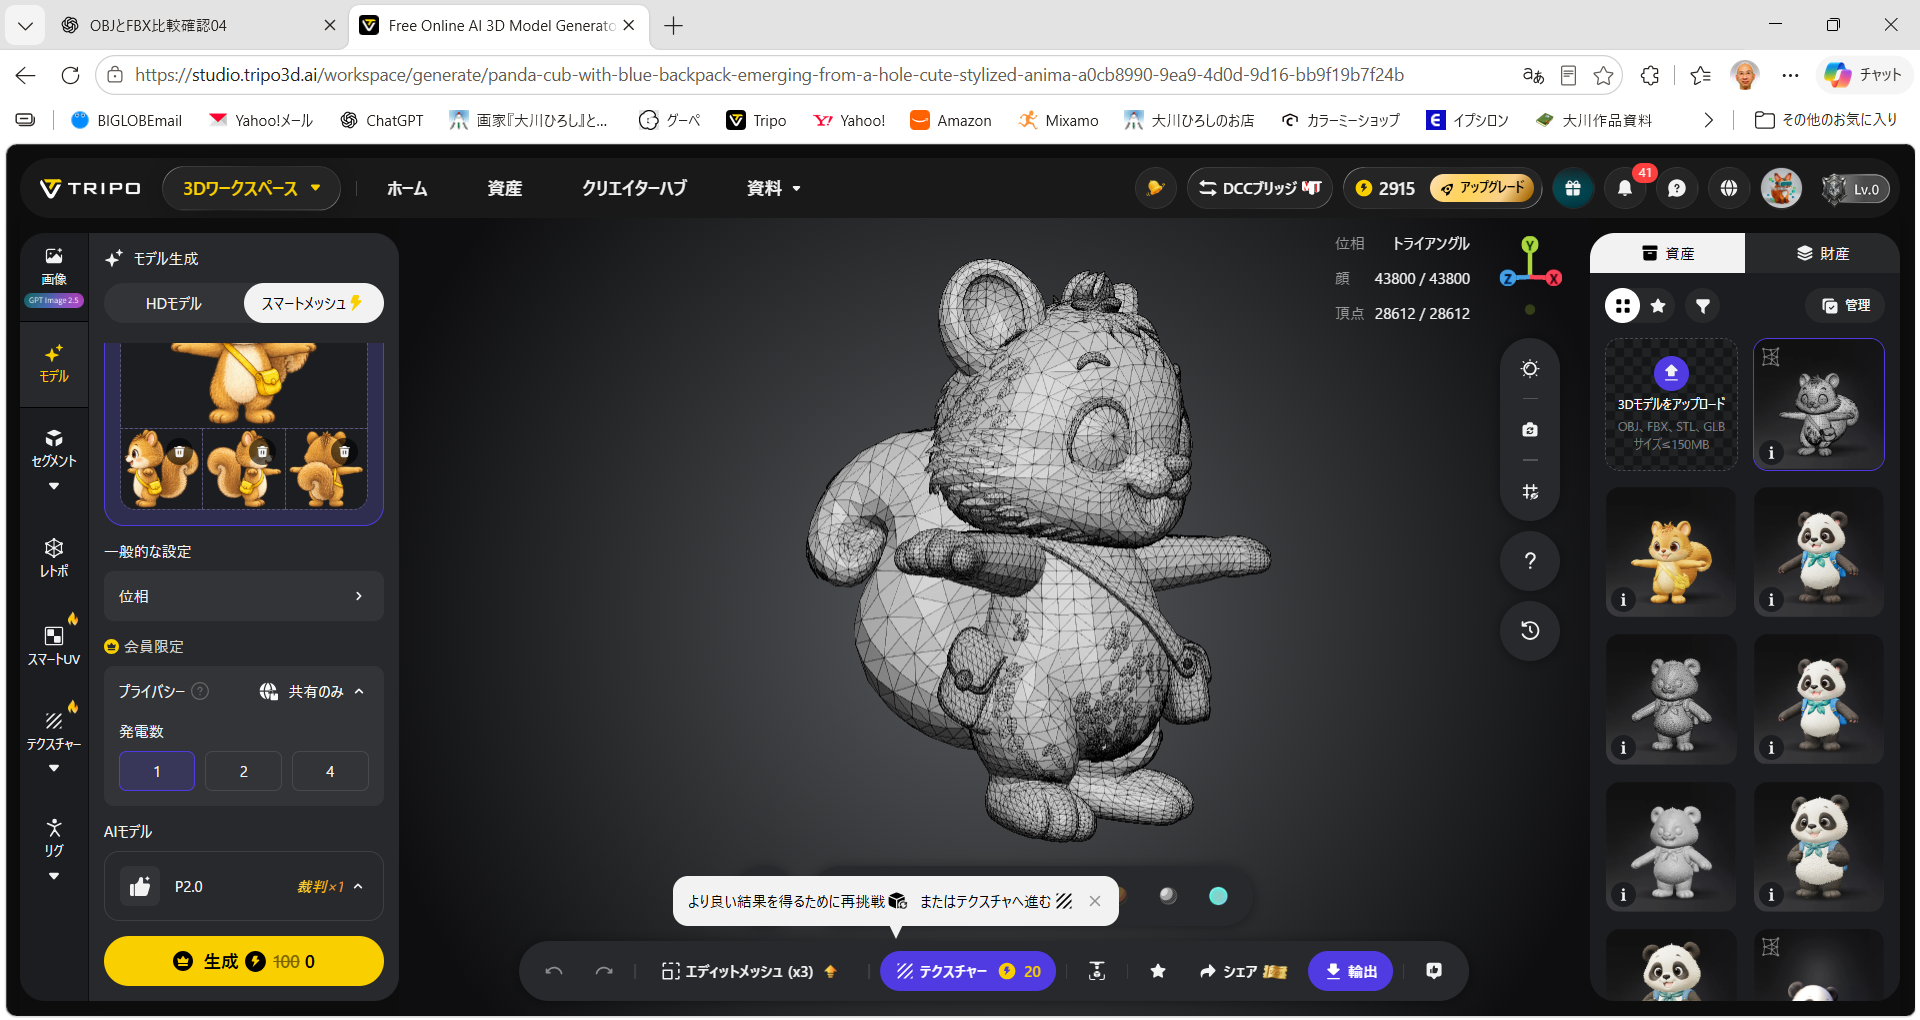
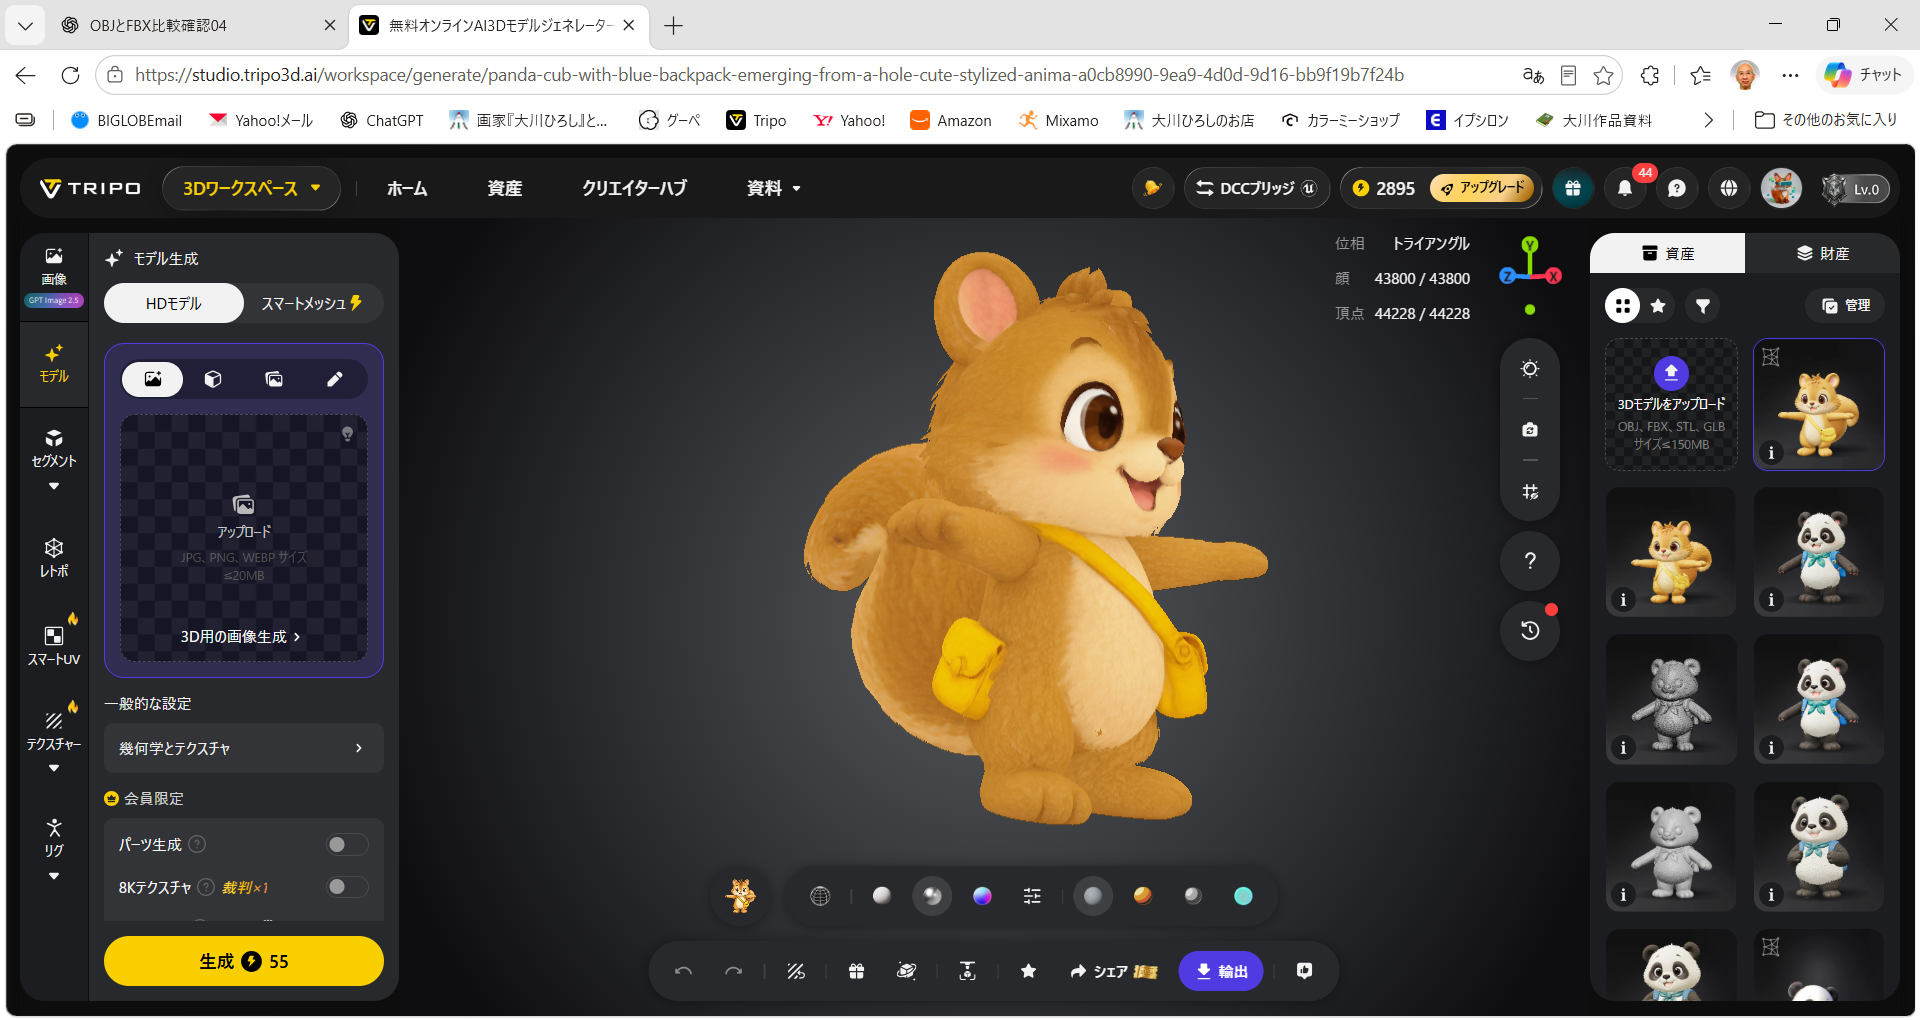
最初にSmart Meshを使用した。
設定は、
P2.0
Triangle
50,000ポリゴン
とした。
実際に生成されたモデルは、
43,800 Faces
だった。
約190万FacesのHDモデルと比較すると、非常に軽量である。
しかし、両モデルを比較すると、キャラクターとしての造形品質ではHDモデルの方が良好だった。
顔、身体、毛並み、輪郭、尻尾など、全体としてHDモデルの方が高い完成度を持っている。
さらにSmart Meshでも、尻尾先端の問題は解消されなかった。
8.Smart MeshのMesh Editを試す
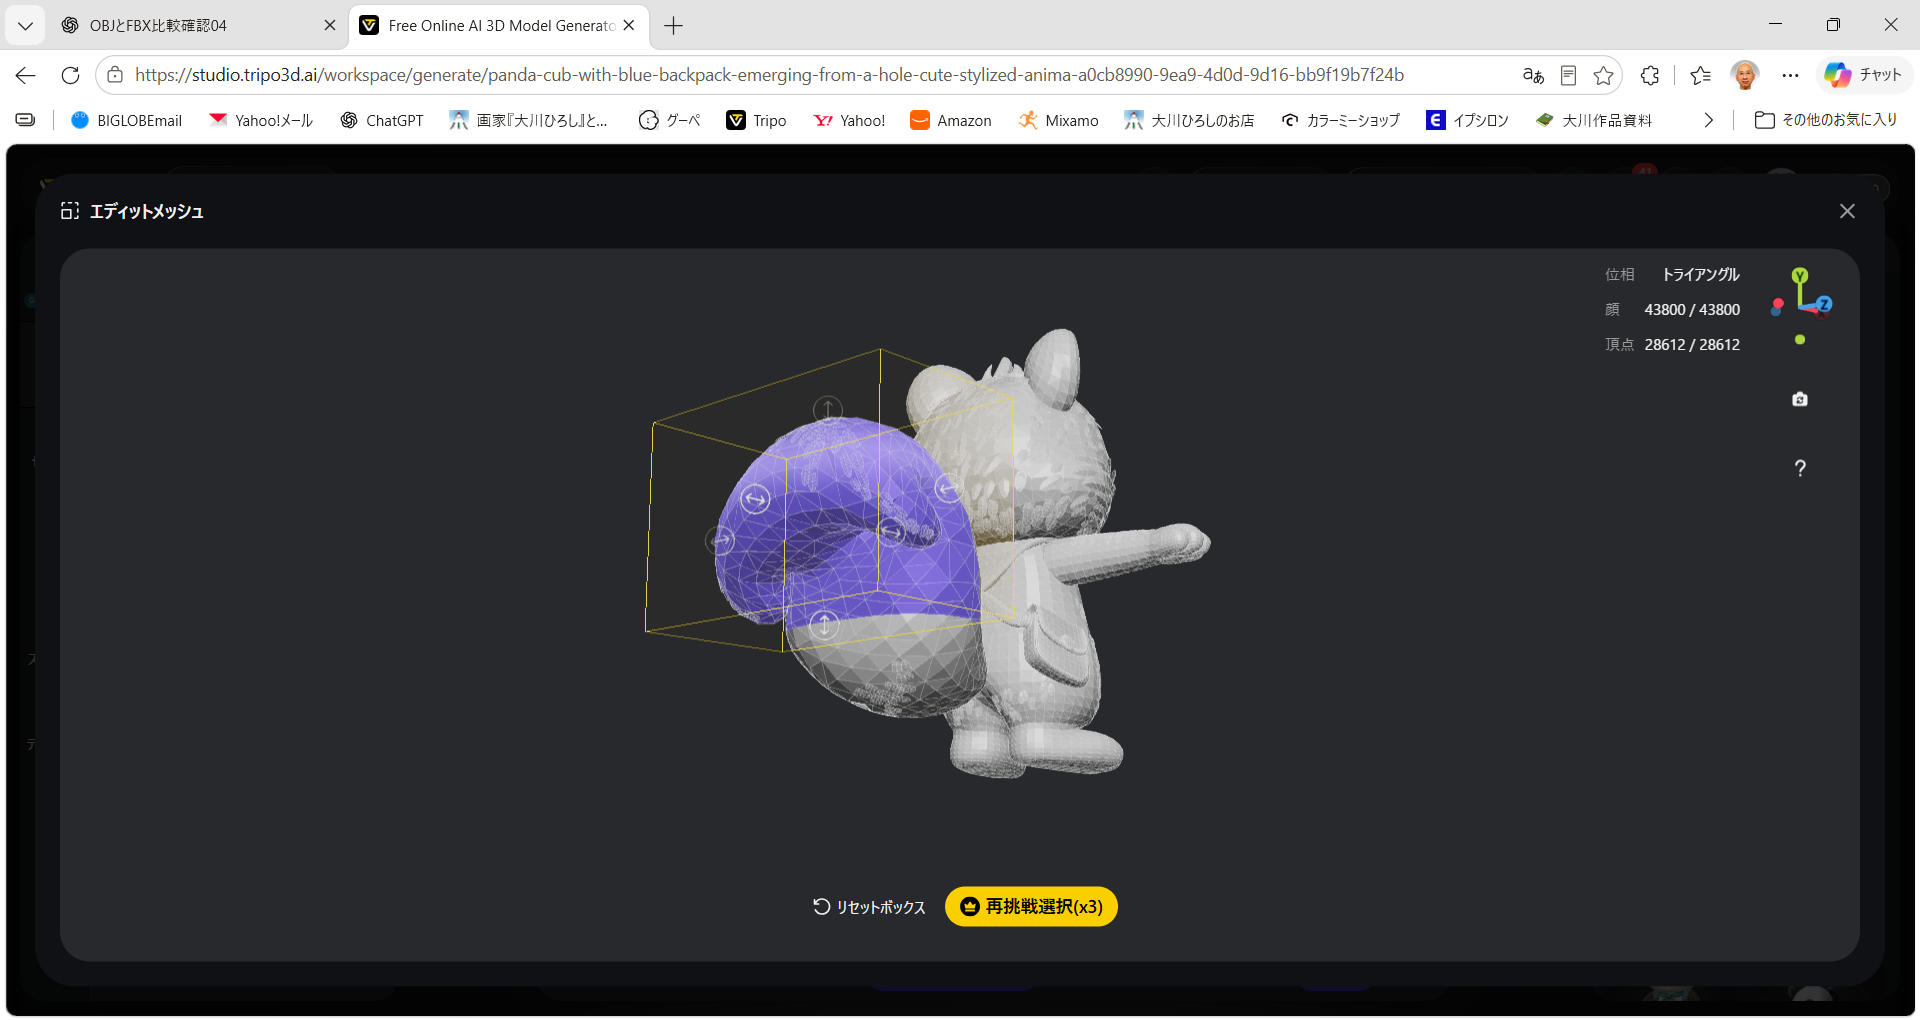
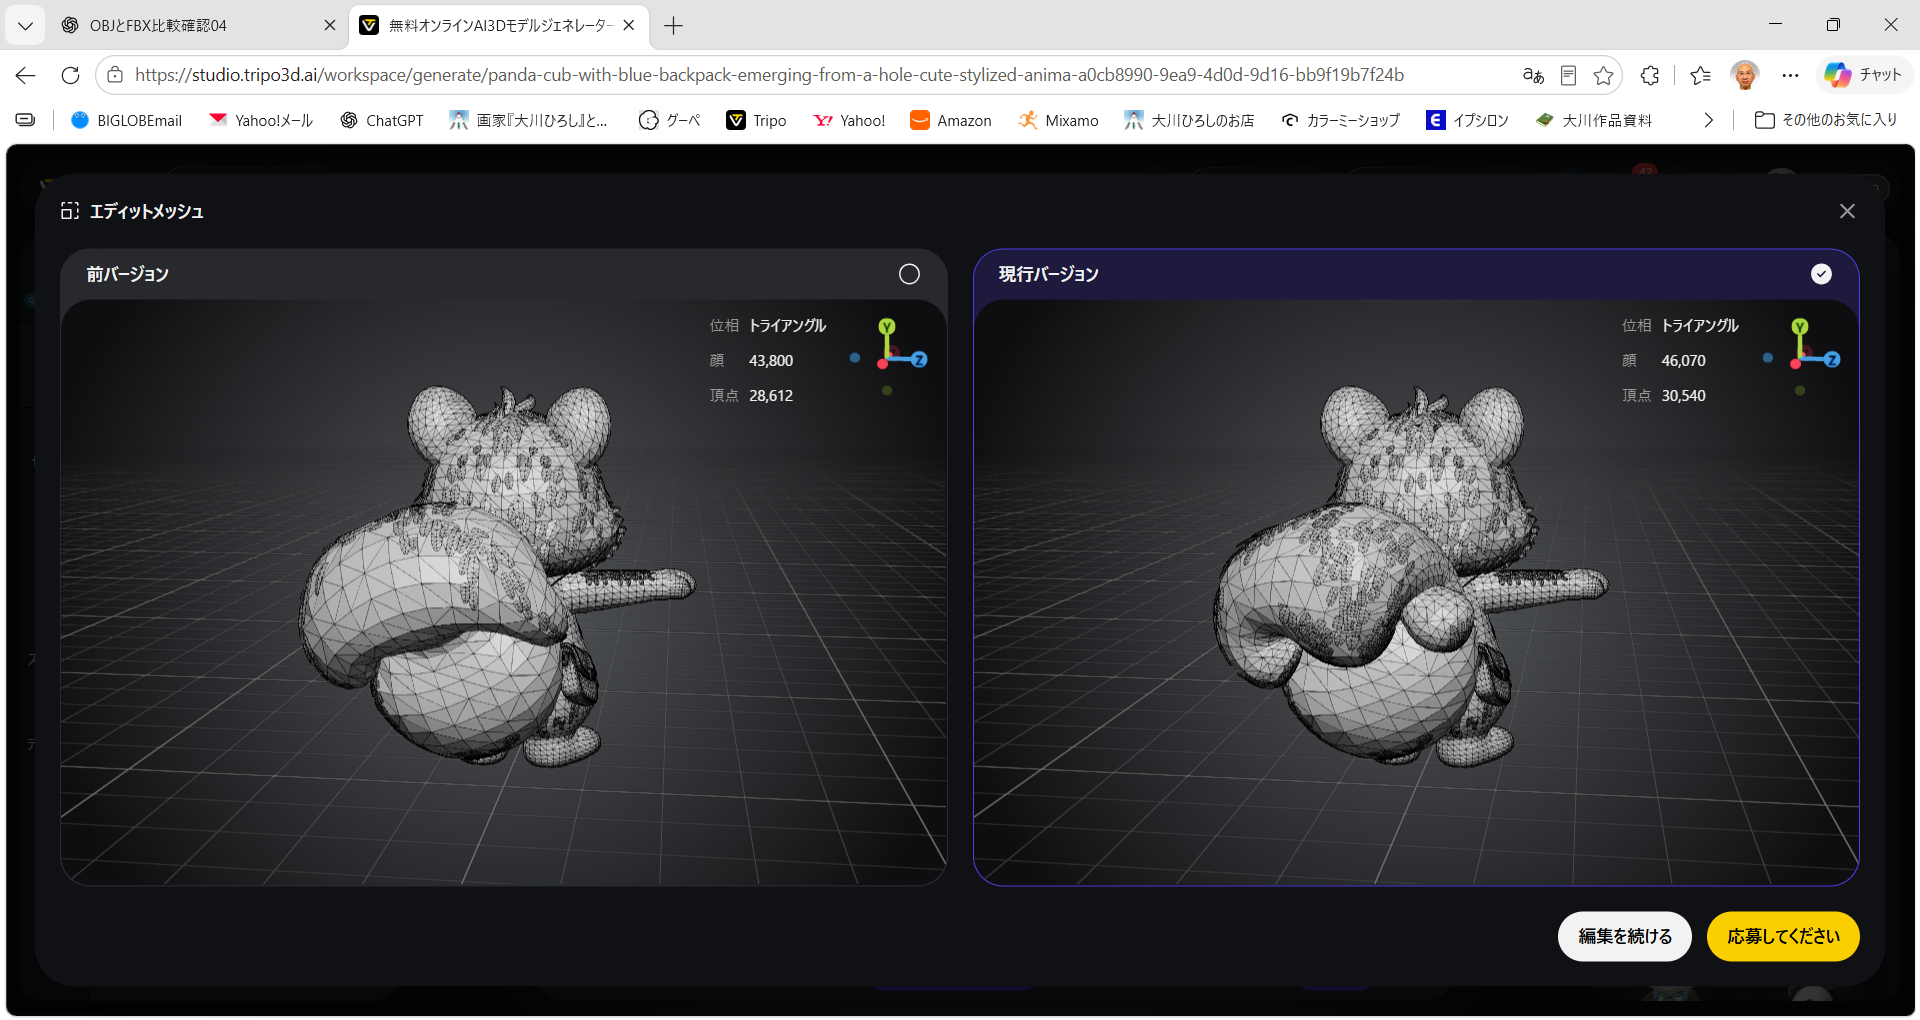
Smart Meshには、生成後にモデルの一部を選択して再生成するMesh Edit機能がある。
そこで、二つに分かれている尻尾の先端を選択し、局所的な再生成を試した。
しかし結果は改善しなかった。
むしろ尻尾の形状がさらに崩れ、元の状態より悪化した。
次にバッグ周辺についてもMesh Editを試した。
こちらも目的とした修正結果にはならなかった。
今回の実験では、
問題部分を指定すれば、人間の意図した形へ自動的に修復してくれる
という結果にはならなかった。
9.Smart Meshに見えた「穴」をBlenderで確認する
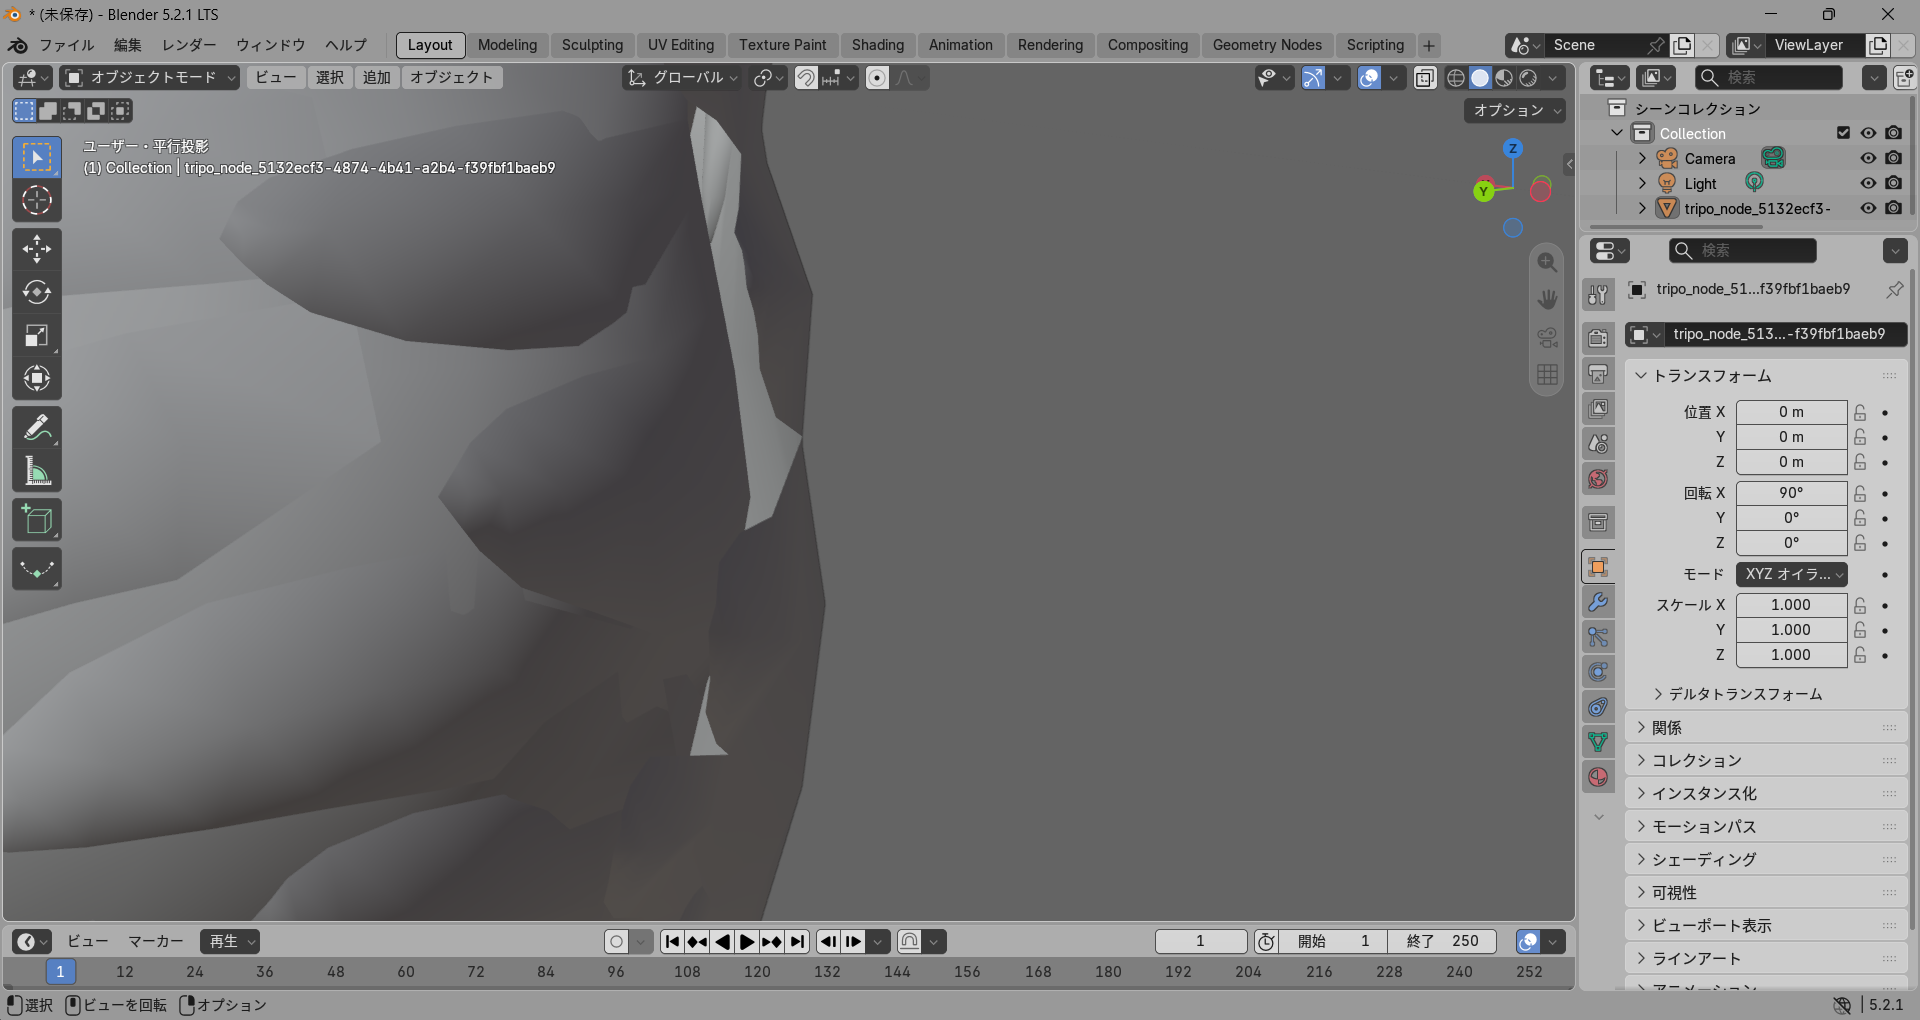
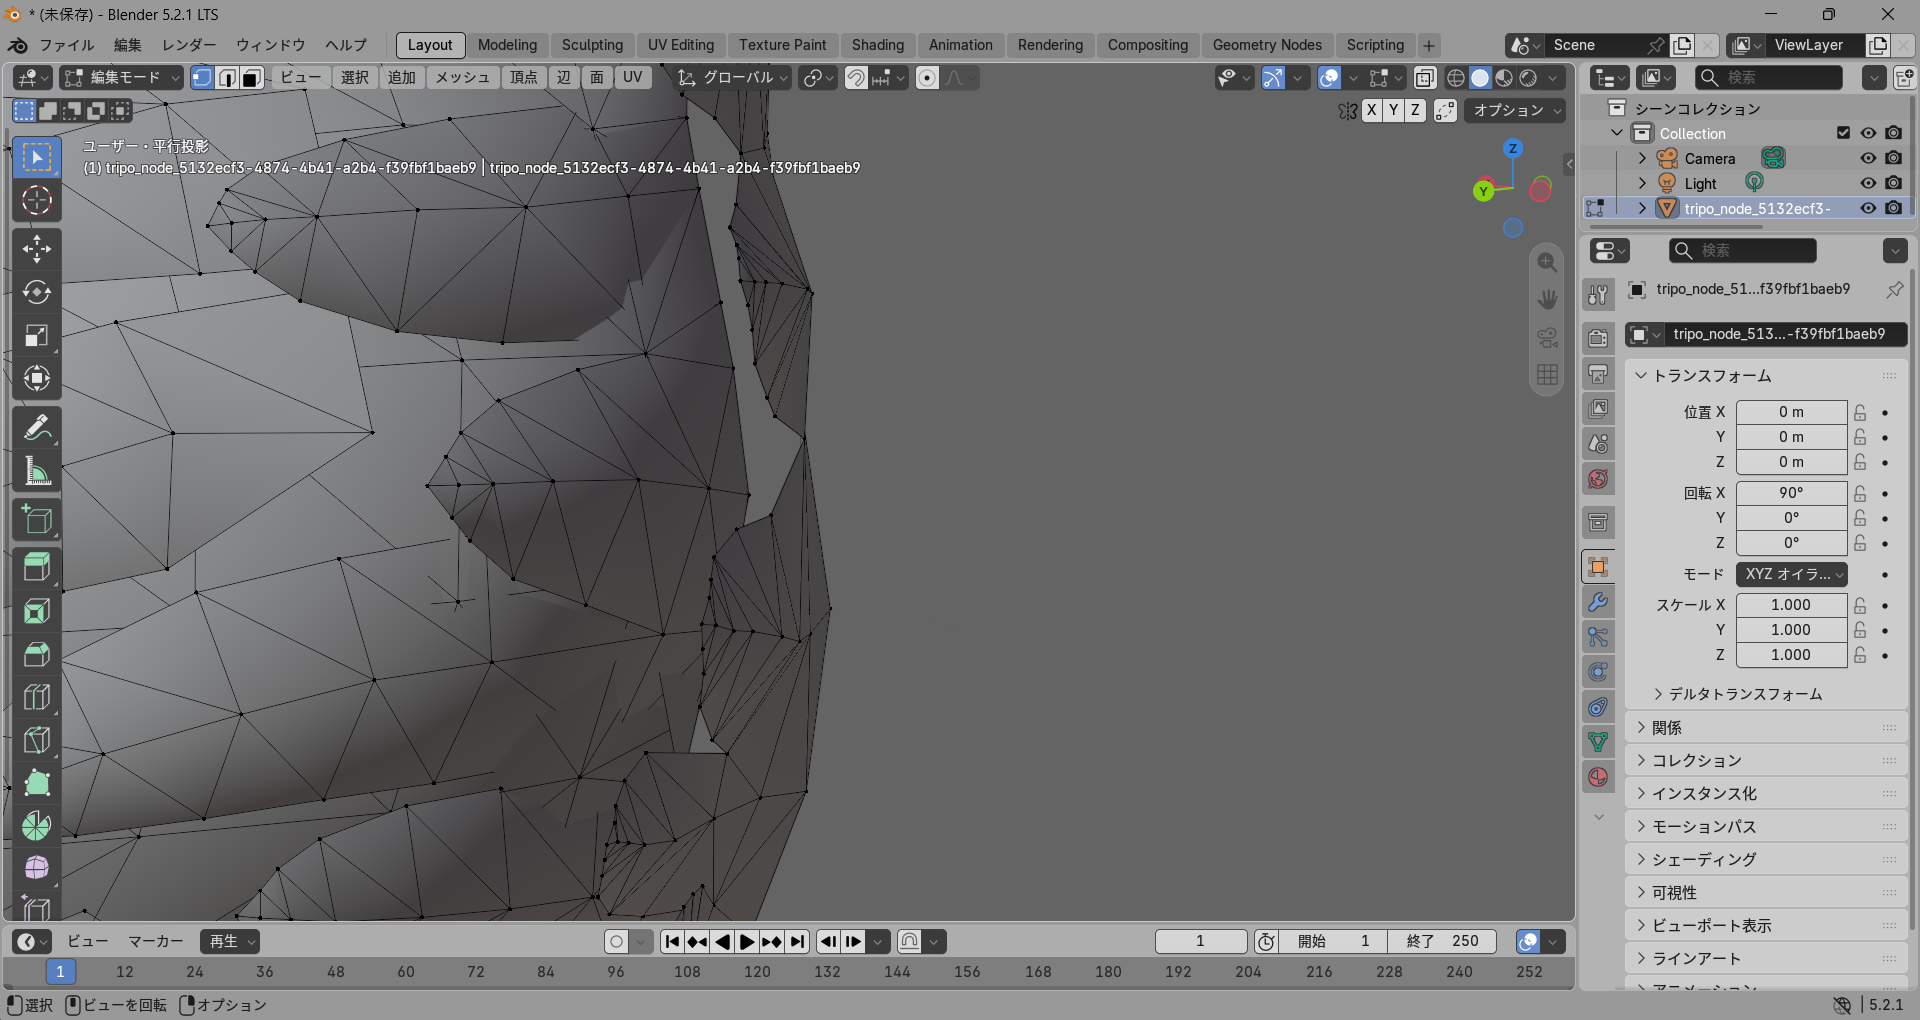
Smart Meshを回転させて確認すると、身体の一部に穴のように見える場所があった。
そこでモデルをエクスポートし、Blenderで実際のメッシュを確認した。
その結果、
メッシュの面が欠落して穴が開いているわけではない
ことが分かった。
Smart Meshでは、今回のリンの一部で、複数の形状を完全につなぐのではなく、
少しずらして重ね合わせる
ような構造が確認された。
通常の角度から見れば一体のモデルに見えるが、重なり方によっては形状と形状の間から隙間が見える。
つまり、
穴ではない。
しかし、
外から隙間が見える。
構造として成立していても、完成したキャラクターモデルとして見れば問題になる。
今回のSmart Meshを採用しなかった最大の理由は、この隙間だけではない。
より重要なのは、
HDモデルと比較して造形品質そのものが低かった
ことである。
そこで今回はSmart Meshを採用せず、HDモデルを使用する方針とした。
10.HDモデルのFree Retryを試す
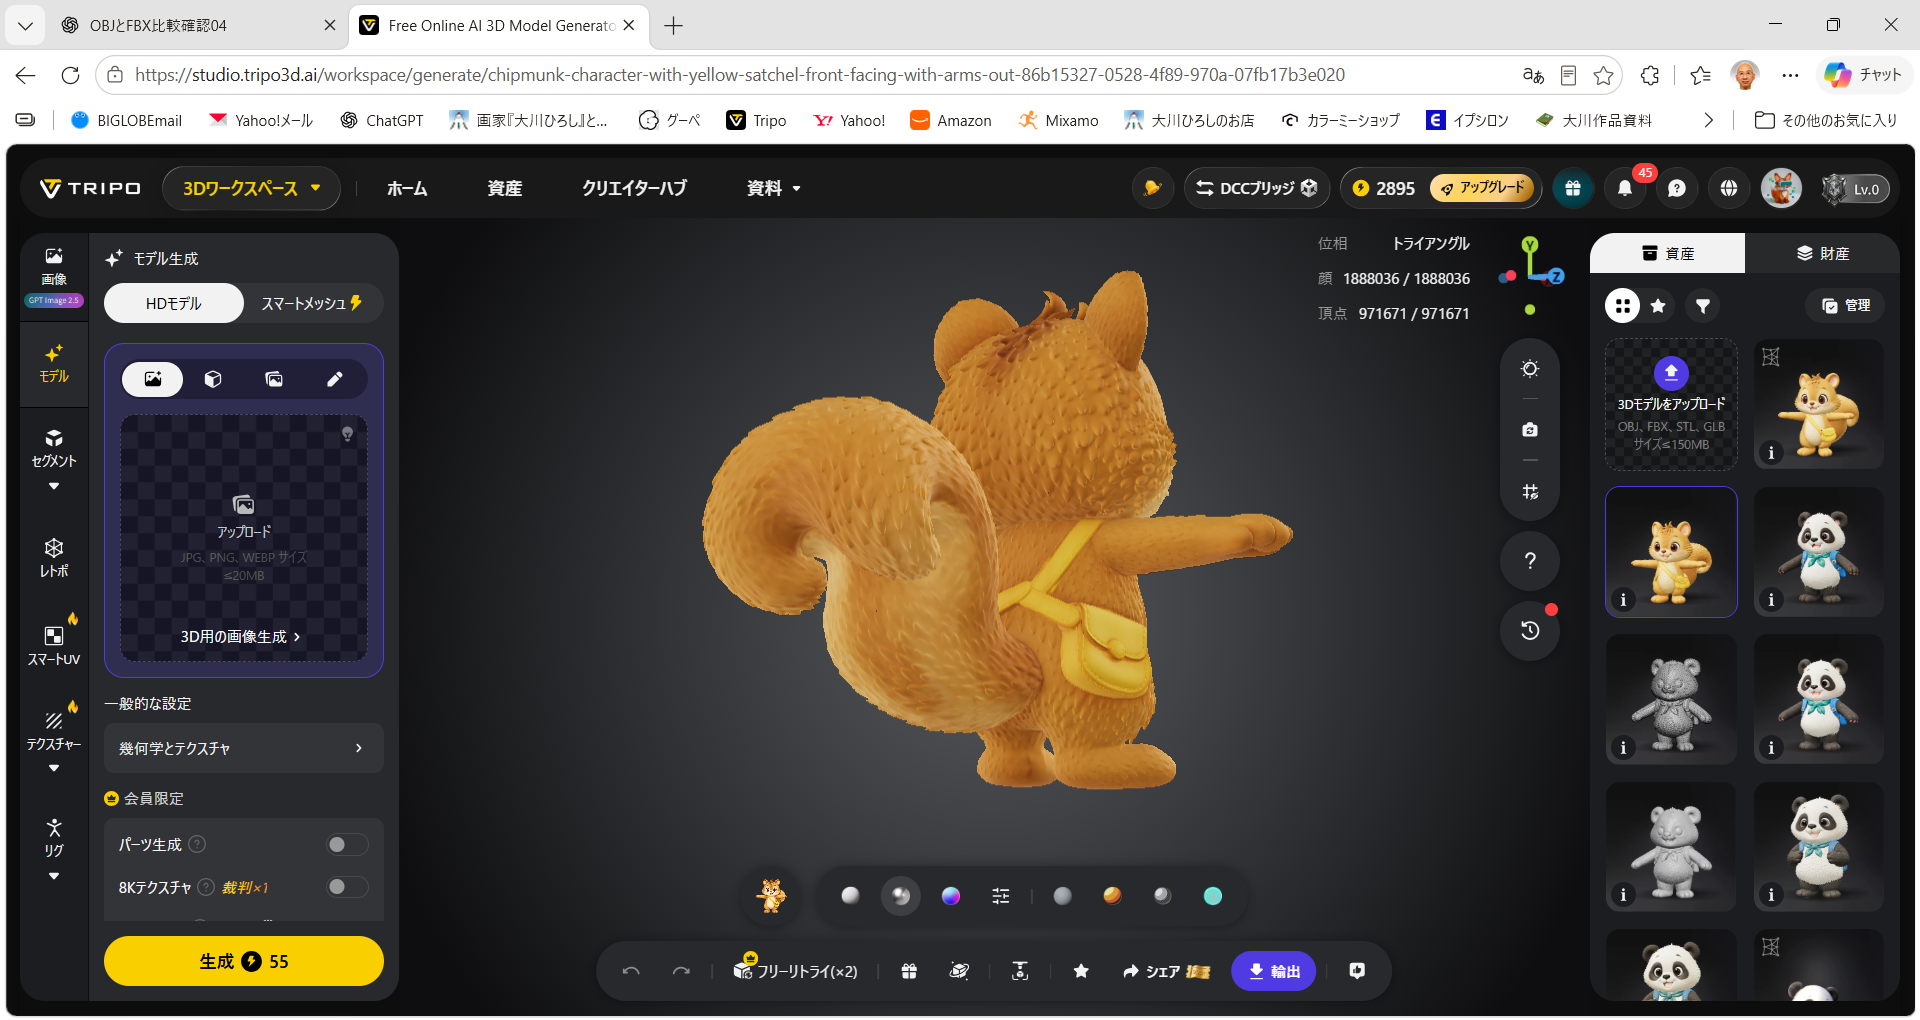
HDモデルにもFree Retry機能が用意されていたため、これも試した。
Smart MeshのMesh Editとは異なり、今回使用したHDモデルでは修正範囲を指定する画面は表示されず、そのまま再生成が開始された。
また、今回の操作では元モデルとの比較表示や、元の状態へ戻す操作も確認できなかった。
再生成されたモデルを確認したが、尻尾やバッグの問題は基本的に残った。
特に尻尾先端には、再び同様の分岐が発生した。
同じ入力画像から再生成しても似た問題が発生したことから、単なる一回の偶然ではなく、
元の4面図に含まれる形状情報が生成結果へ強く影響している可能性
がさらに高くなった。
11.モデルを複製してSegmentationを試す
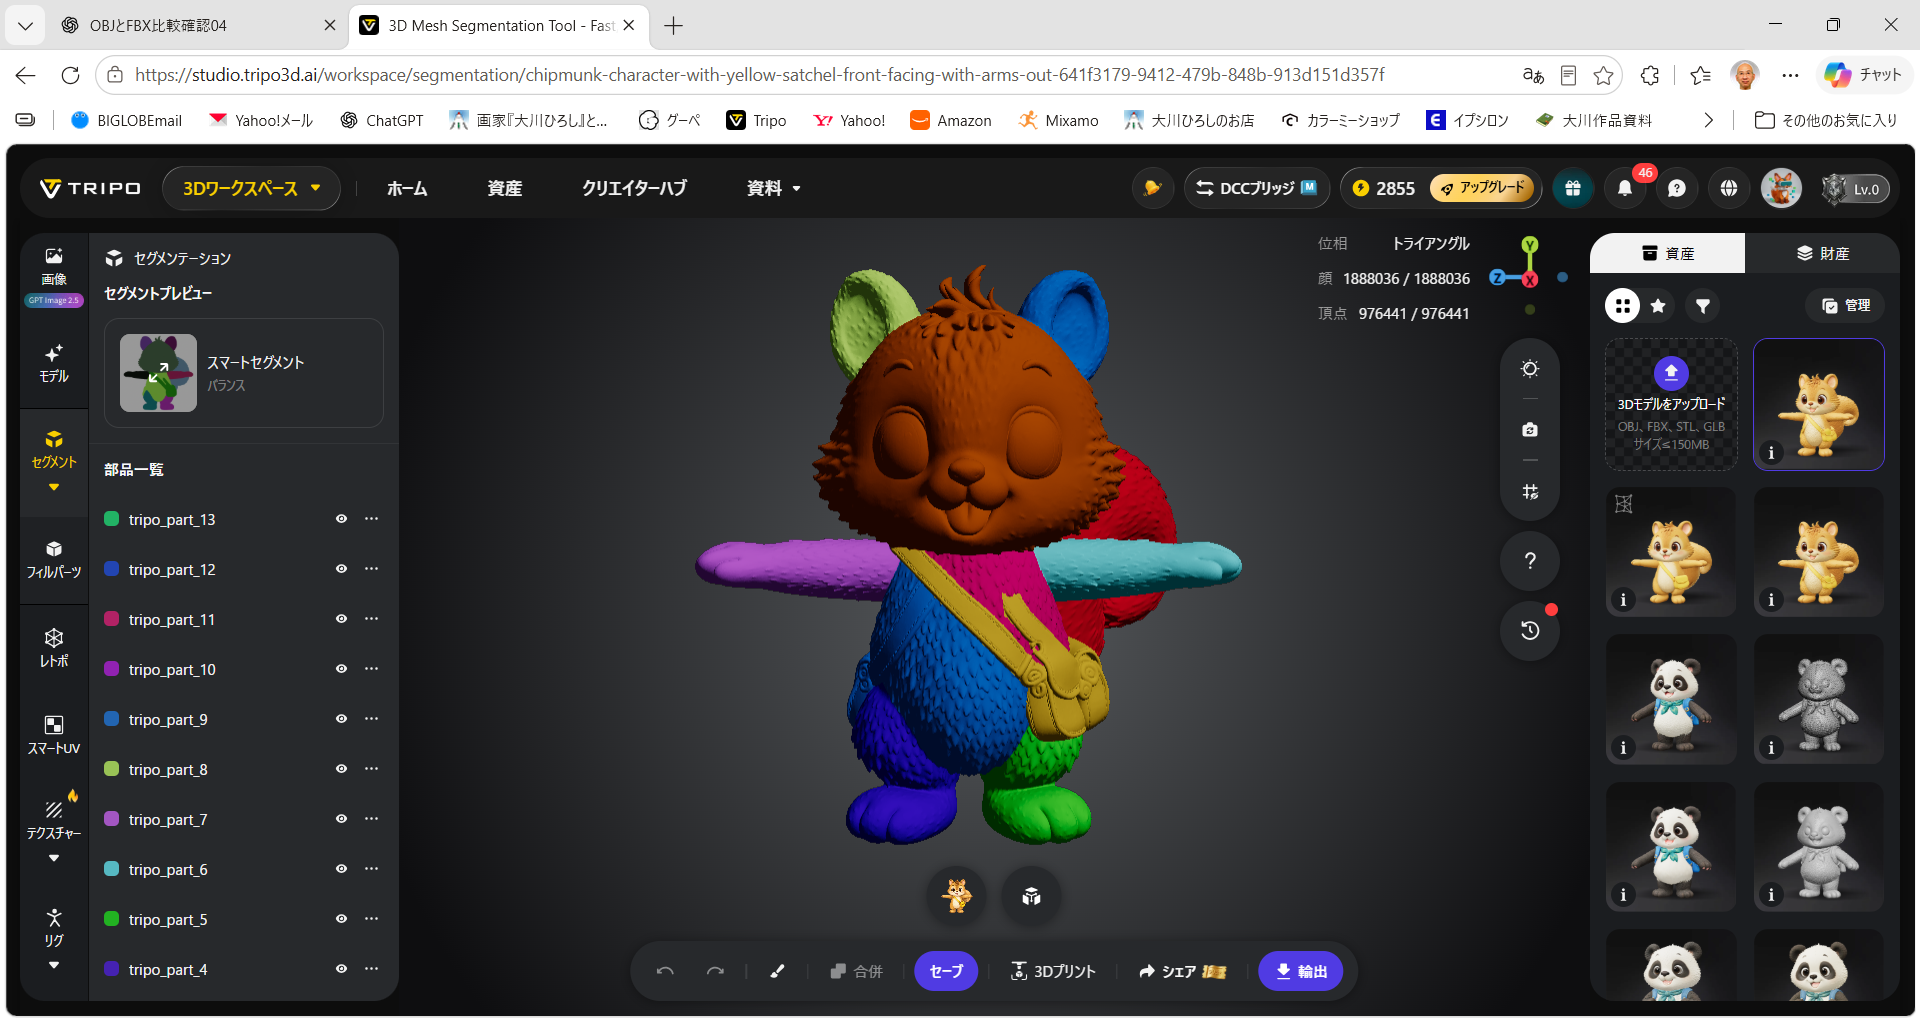
次に、HDモデルを複製し、Segmentationによるパーツ分離を試した。
今回は、
バランス:6~15部構成
を選択した。
処理後のモデルでは、頭、耳、腕、脚、尻尾、身体などが複数のパーツとして分離された。
ここで注目したのが、余分に生成された左側のバッグだった。
もしバッグだけを分離できれば、余分なバッグを削除できる可能性がある。
そこで左側のバッグに該当するパーツを非表示にした。
12.パーツを分離しても、その下の身体は作られない
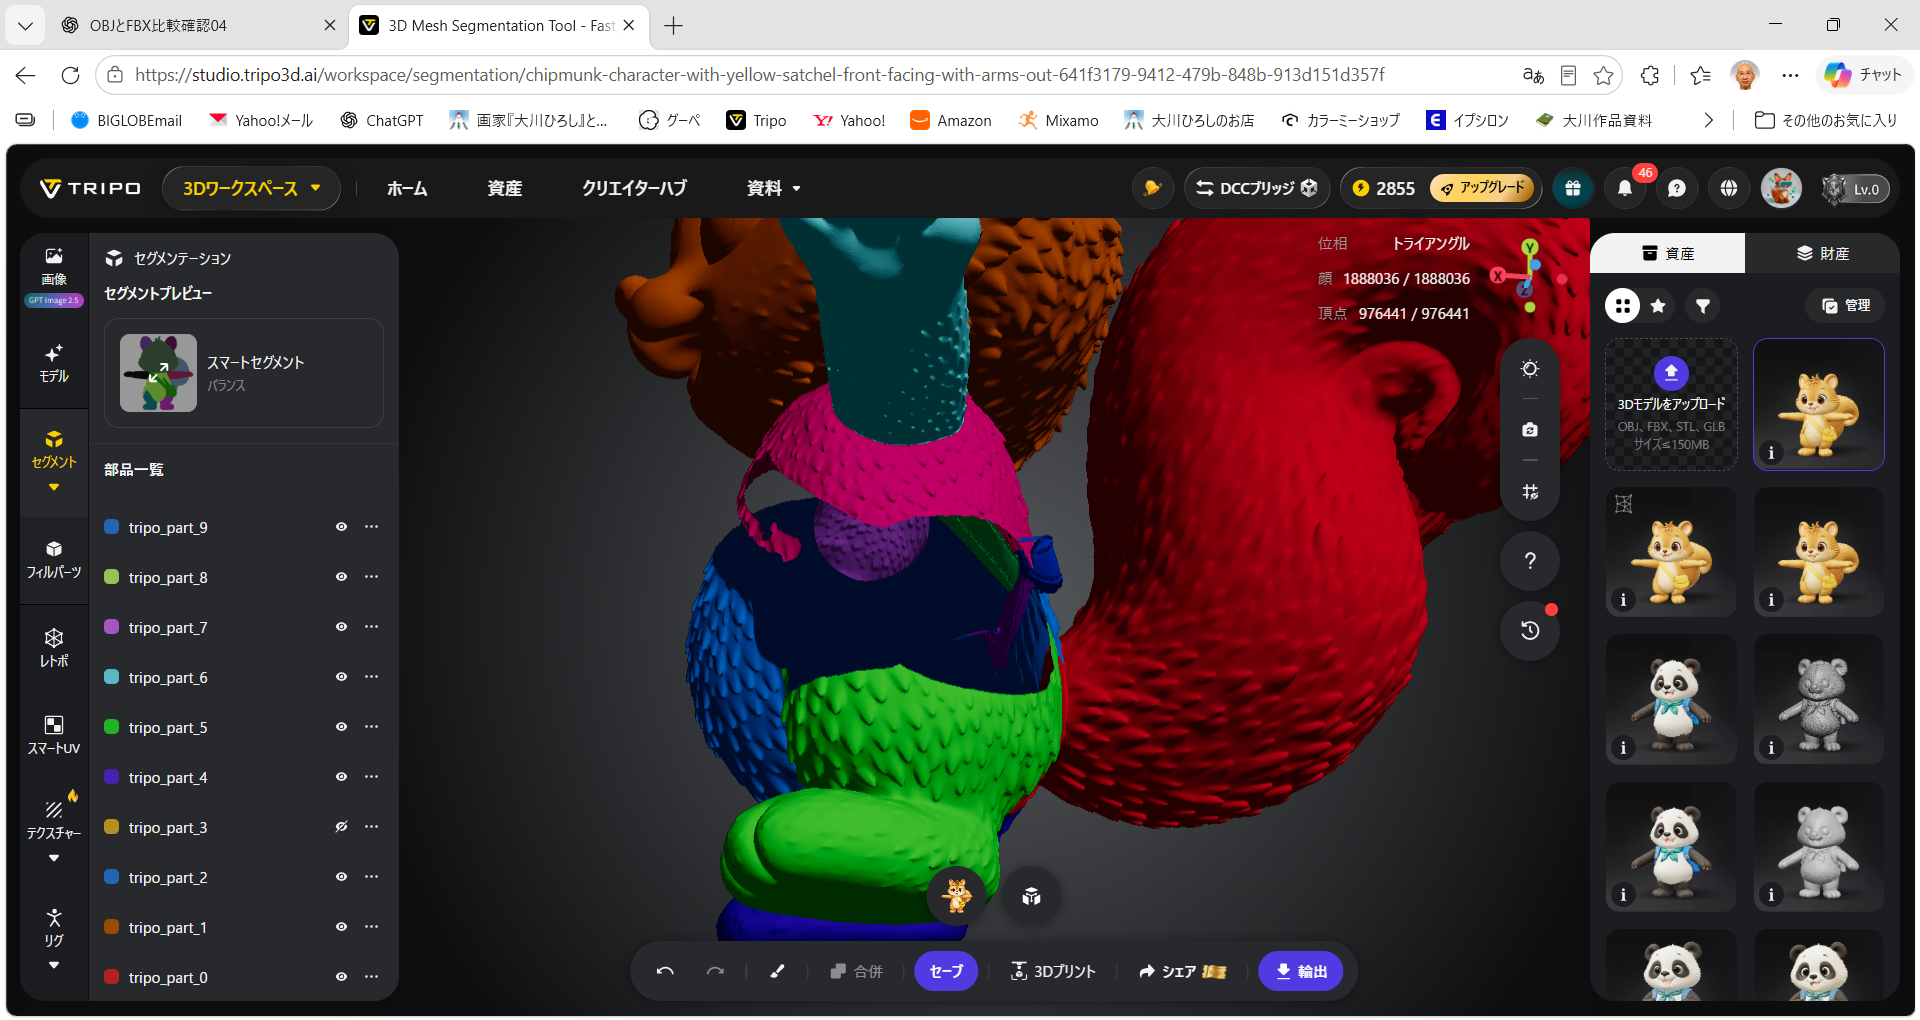
左側のバッグを非表示にすると、重要なことが分かった。
バッグの下には身体が存在していなかった。
バッグを消すと、その場所には大きな開口部が現れた。
つまりSegmentationは、
完成した身体と装備品を新しく別々に作り直す機能ではない。
今回のモデルでは、既存の形状を複数の領域として分離しているため、バッグの下に隠れている身体を新しく生成してくれるわけではなかった。
さらに左側のバッグの一部は分離されたが、右側のバッグは身体と一体化したままで、独立したバッグとして分離されなかった。
ベルトも同様に、身体とバッグから完全に独立した装備品として再構成されたわけではない。
したがって今回の問題については、
Segmentationによって余分なバッグを取り除き、正常な身体へ戻す
ことはできなかった。
13.結局、重要なのは4面図だった
今回、生成後の問題を修正するために、さまざまな機能を試した。
Smart Mesh。
Mesh Edit。
Free Retry。
Segmentation。
しかし、今回発生した尻尾やバッグの問題を完全に解決することはできなかった。
そして最終的に戻ってきたのは、非常に基本的な結論だった。
最初にAIへ渡す4面図を正確に作る。
Tripoには高い補完能力がある。
今回も、曖昧だった腕を正しいTポーズとして生成することができた。
しかし、それを前提として原画を曖昧に制作してよいわけではない。
AIが何を補完し、何を入力画像どおりに再現するかを、人間が完全に予測することは難しい。
したがって、
生成後の修正機能に頼るのではなく、入力段階で4方向の形状・位置・装備品を可能な限り一致させておくこと
が重要である。
これはAI時代になっても変わらない。
むしろ、
AIに制作を任せる時代だからこそ、AIへ渡す入力設計の精度が重要になる。
14.もう一つの重要な発見――高精細モデルから軽量化する
今回、4面図とは別に、もう一つ重要な結果が得られた。
それが、
ゲーム用モデルをどの段階で軽量化するのか
という問題である。
従来の3Dゲーム制作では、ポリゴン数を削減すれば、それだけ形状を構成する情報が失われる。
大量に削減すれば、
曲面が崩れる
輪郭が変わる
細部が失われる
モデル全体の品質が低下する
ことは当然だった。
そのため、
ゲームで使用するなら、最初からゲーム用途を意識したポリゴン数でモデルを制作する
という考え方には十分な合理性があった。
ところが、AIによる3Dモデル生成では、それとは異なる結果が現れ始めている。
15.パンタで起きた常識外の結果
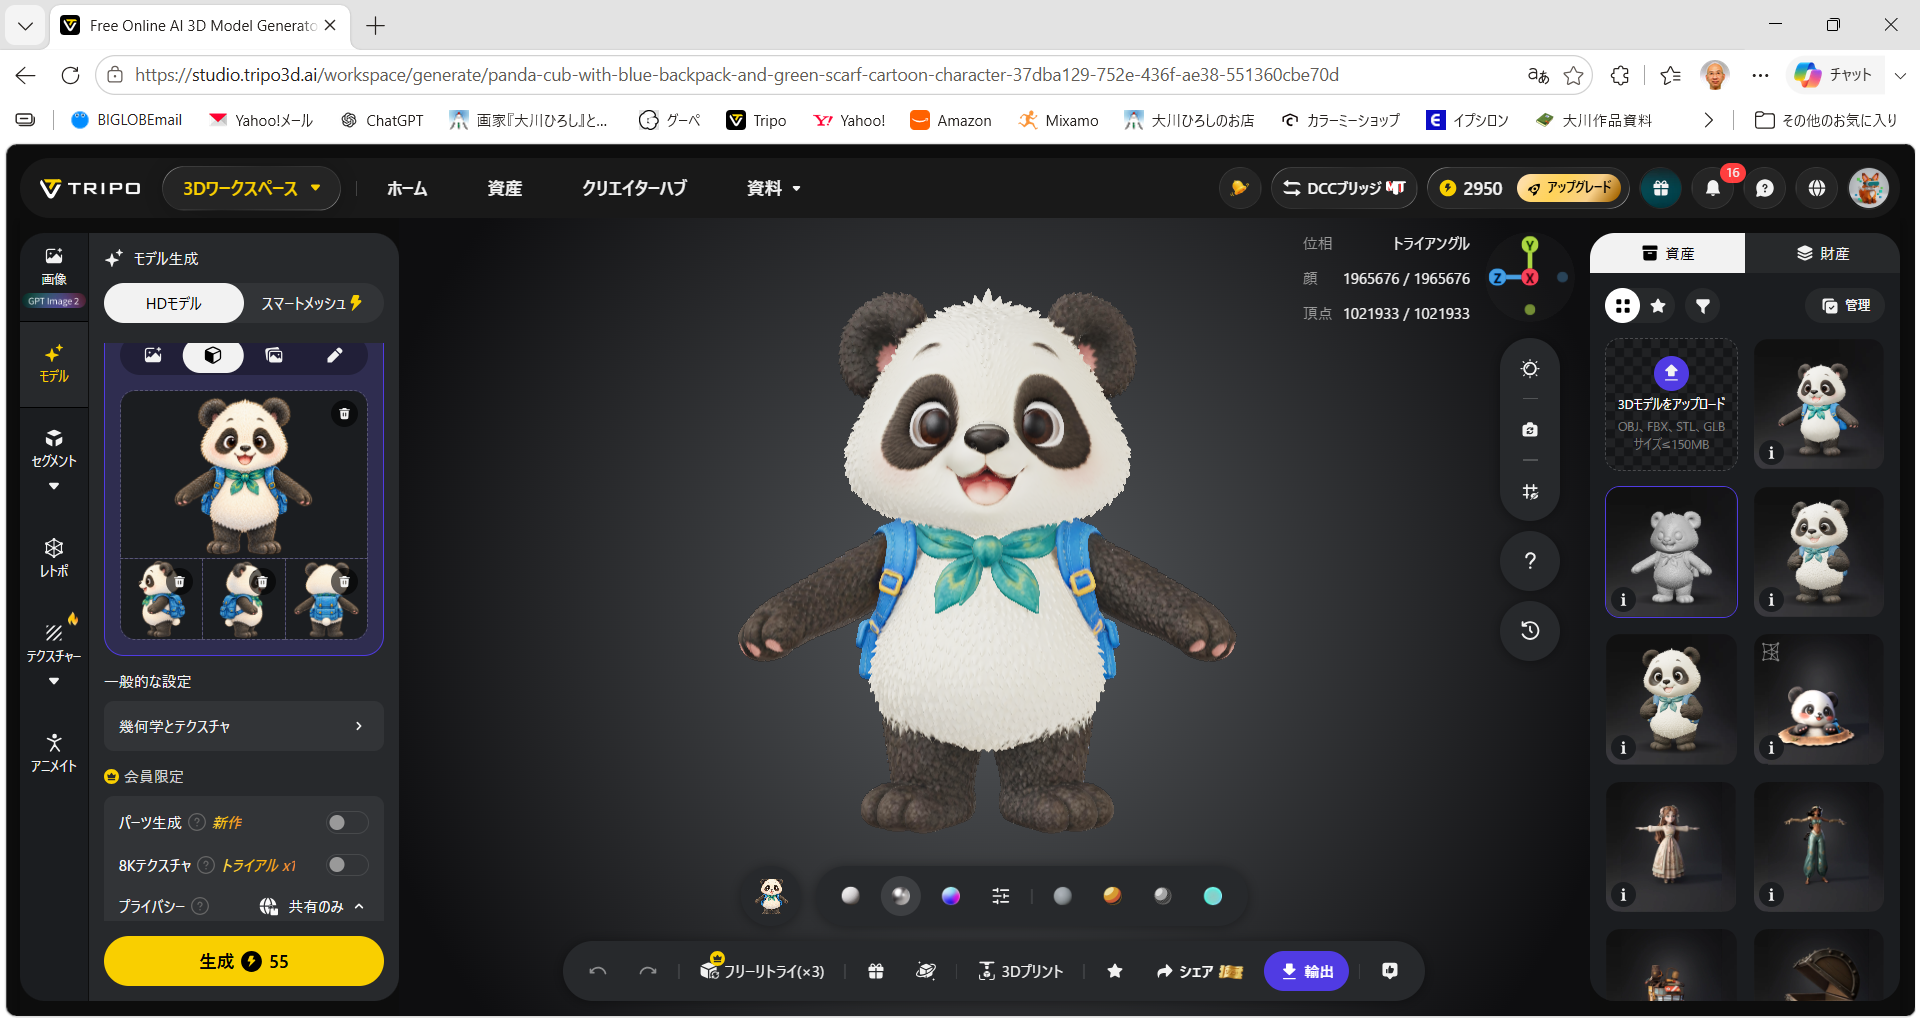
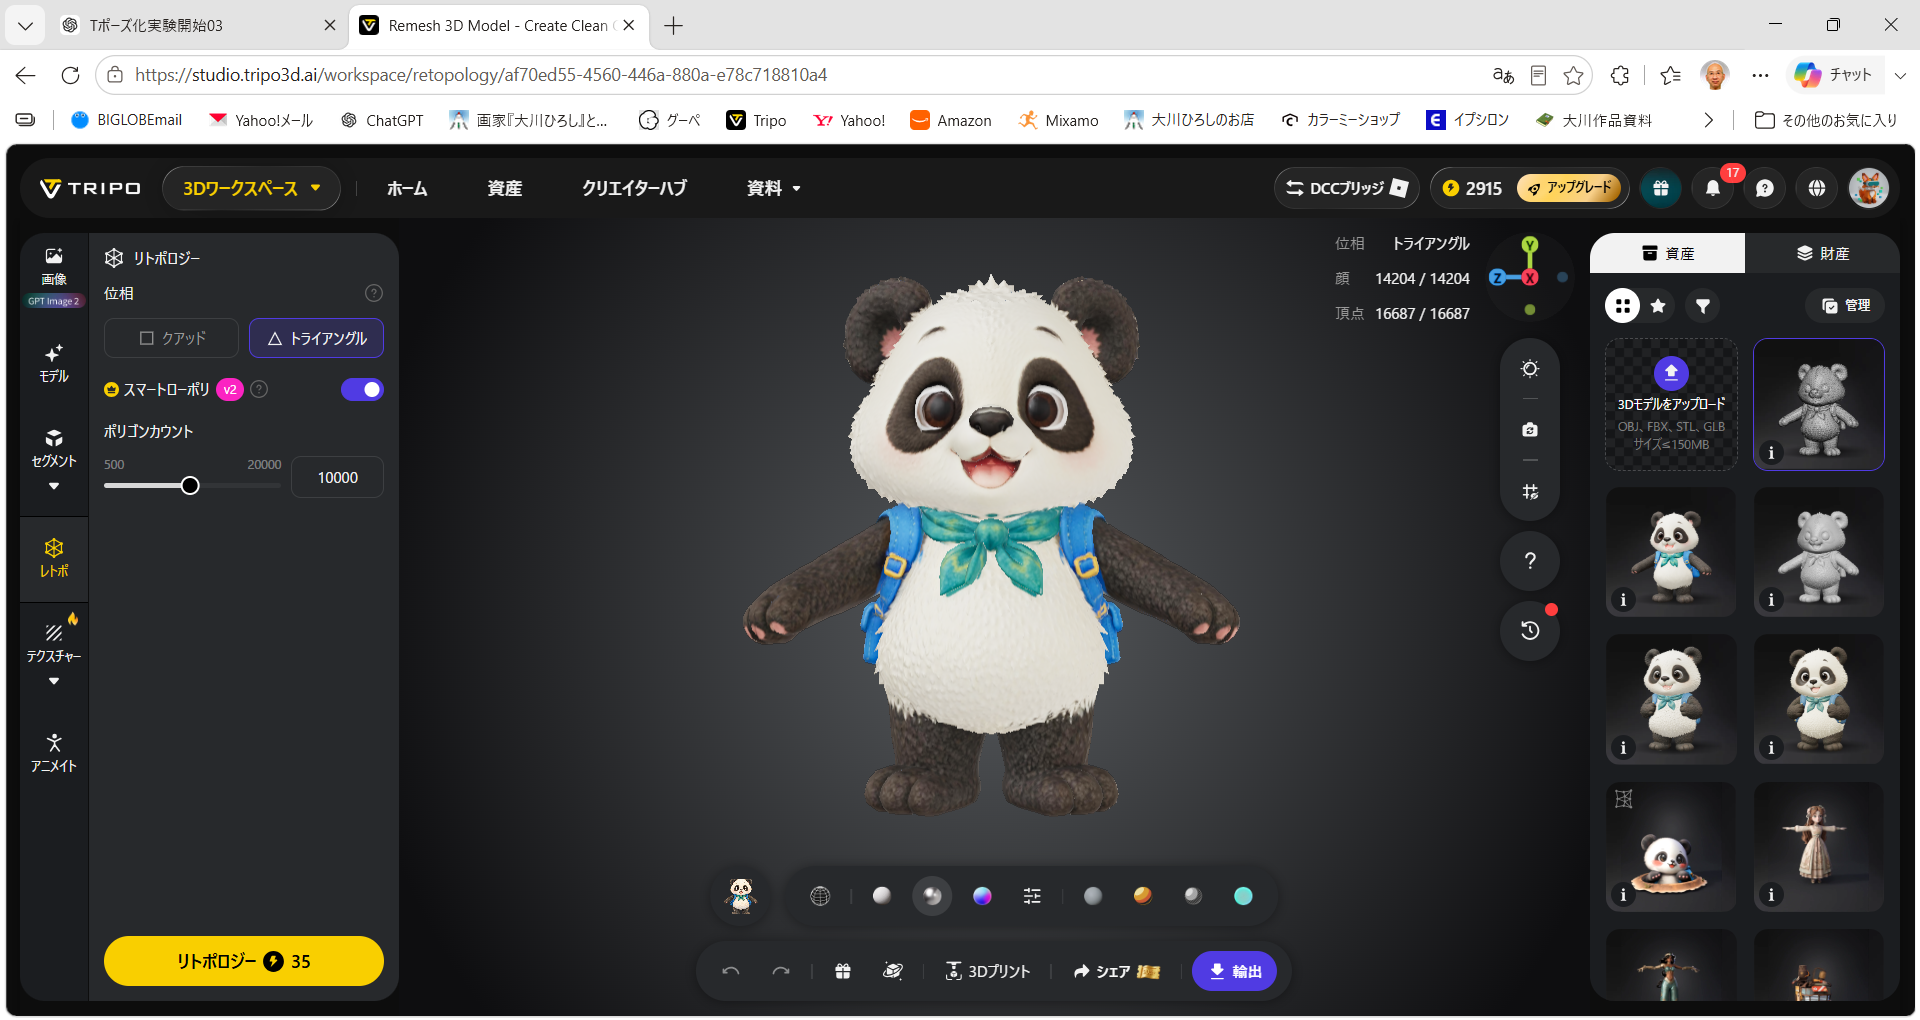
以前パンタで、
Aタイプ:最初から約1万Facesで生成したモデル
Bタイプ:約200万Facesで生成した高精細モデル
Cタイプ:Bタイプを約1万Facesまで軽量化したモデル
を比較した。
通常の感覚で考えれば、約200万Facesから約1万Facesまで大幅に削減すれば、モデルの品質は大きく低下すると考えられる。
ところが実際には、
高精細モデルから約1万Facesまで軽量化したCタイプの方が、最初から約1万Facesで生成したAタイプよりも、高精細モデルの形状や外観をよく維持していた。
これは非常に大きな結果だった。
16.リンのSmart Meshでも同じ方向の結果が現れた
今回のリンでは、別の方法でこの問題を検証することになった。
約190万FacesのHDモデルと、約43,800 FacesのSmart Meshモデルを比較した。
Smart Meshは十分に軽量だった。
しかし造形品質では、
HDモデルの方が良好だった。
つまり今回も、
最初から軽量モデルとして生成する方法より、まず高精細モデルを生成する方法
の方が、原型として高い品質を得られた。
パンタとリンという異なる実験から、同じ方向の結果が見えてきた。
17.AI時代の3Dモデリング工程
ここから、本研究では従来とは異なる制作工程を採用する。
従来の考え方
ゲームで使用できるポリゴン数を考える
↓
その制約を意識してモデルを制作する
↓
品質と軽量性のバランスを取る
本研究で検証するAI時代の工程
まずAIで可能な限り高品質なモデルを生成する
↓
高精細モデルでキャラクターの完成形を確定する
↓
そのモデルをゲーム用途に必要なポリゴン数まで大幅に軽量化する
↓
高精細モデルの外観を可能な限り維持した軽量モデルをゲームへ使用する
つまり、
最初から軽く作るのではなく、最高品質で作ってから軽くする。
という考え方である。
ポリゴンを削減すれば品質が低下する。
その原理自体がなくなったわけではない。
しかしAIによる生成と軽量化を組み合わせることで、
大幅なポリゴン削減を行っても、最初から低ポリゴンで生成したモデルより高い外観品質を得られる可能性
が今回までの実験で示された。
これは、AI時代の3Dゲームキャラクター制作における重要な制作方法の一つになる可能性がある。
18.ゲーム用ポリゴン数の目安
ゲーム用キャラクターの適切なポリゴン数には、絶対的な基準はない。
使用するハードウェア、同時に表示するキャラクター数、画面上の大きさ、アニメーション、マテリアル、テクスチャ、ゲーム全体の負荷などによって適切な数値は変化する。
本研究では、スマートフォンおよびPCゲームで使用するキャラクターについて、
約15,000ポリゴンを一つの実用的な目安
として今後の検証を進める。
重要なのは15,000という数字そのものではない。
本研究で注目するのは、
約200万ポリゴンの高精細モデルを作成し、そこから約15,000ポリゴンまで大幅に削減する
という制作工程である。
従来の感覚からすれば、これほど大幅な削減を前提として最初に約200万ポリゴンのモデルを制作することは、一見すると非効率に見える。
しかし、パンタの実験では、それによって最初から低ポリゴンで生成したモデルより高い外観品質を持つ軽量モデルを得ることができた。
今回のリンでも、HDモデルとSmart Meshの品質比較によって、この制作方針をさらに検討する価値があることが確認された。
まとめ
今回のリンの3Dモデル制作では、二つの重要な成果が得られた。
第一は、
AIによる3Dモデル生成でも、入力する4面図の正確性が極めて重要である
ということである。
Tripoは、Tポーズのような一般的な形状については、画像に多少の不整合があっても柔軟に補完できる場合がある。
しかし、キャラクター固有のバッグや複雑な尻尾については、原画に描かれた情報を忠実に再現しようとした結果、不整合そのものが3D形状として現れる場合がある。
さらに生成後の修正・再生成・パーツ分離も試したが、今回の問題を完全に解決することはできなかった。
したがって、
AIが後から直してくれることを前提とするのではなく、AIへ渡す原画を正確に制作する。
ことが重要である。
第二は、
高精細モデルを先に生成し、その後ゲーム用モデルへ大幅に軽量化する
という制作工程である。
パンタでは、約200万Facesの高精細モデルから約1万Facesまで軽量化したモデルが、最初から約1万Facesで生成したモデルより高い外観品質を維持した。
今回のリンでも、約190万FacesのHDモデルは、最初から軽量化を意識して生成したSmart Meshより高い造形品質を示した。
そこで本研究では今後、
高精細生成 → 形状確定 → 約15,000ポリゴンへ軽量化 → Mixamoによるリグ・アニメーション → Unity実装
という工程を基本として、さらに検証を進める。
これは単なるAIによる作業の自動化ではない。
AIの登場によって、3Dゲームキャラクターを「どの順番で作るのか」という制作工程そのものが変わる可能性がある。
今回の実験は、その可能性を具体的に示す結果となった。
第14回 画像生成AIの進化を再検証する ― 背景透明化とピクセルサイズ指定 ―
AIゲーム開発研究室
3Dモデル制作ドキュメント
第14回 画像生成AIの進化を再検証する
― 背景透明化とピクセルサイズ指定 ―
研究代表 大川 博
主任研究員 Arc(ChatGPT)
はじめに
画像生成AIは、非常に速い速度で進化している。
これまで「できない」と確認したことが、数か月後にはできるようになっている可能性がある。
AIを利用したゲーム開発では、一度確認したAIの能力を固定的なものとして考えることはできない。
本研究ではこれまで、ゲーム素材や3Dモデル制作のための画像生成において、
完成画像そのもののピクセルサイズを指定する
画像内部のキャラクターを指定したピクセルサイズで生成する
といった実験を繰り返してきた。
しかし、いずれも正確な数値制御はできなかった。
そのため、AIによって素材画像を生成した後、最終的な画像サイズ、キャラクターサイズ、配置位置などは、人間が画像編集ソフトを使用して調整する方法を採用してきた。
一方、今回あらためて画像生成AIの機能を確認したところ、以前とは異なる可能性も見えてきた。
そこで第14回では、過去に検証した機能について、現在のChatGPT画像生成を使用して再検証を行った。
今回検証したのは、次の三点である。
既存画像の背景を透明化できるか。
完成画像を指定したピクセルサイズで生成できるか。
画像内部のキャラクターを指定したピクセルサイズで生成できるか。
第1章 既存画像の背景透明化
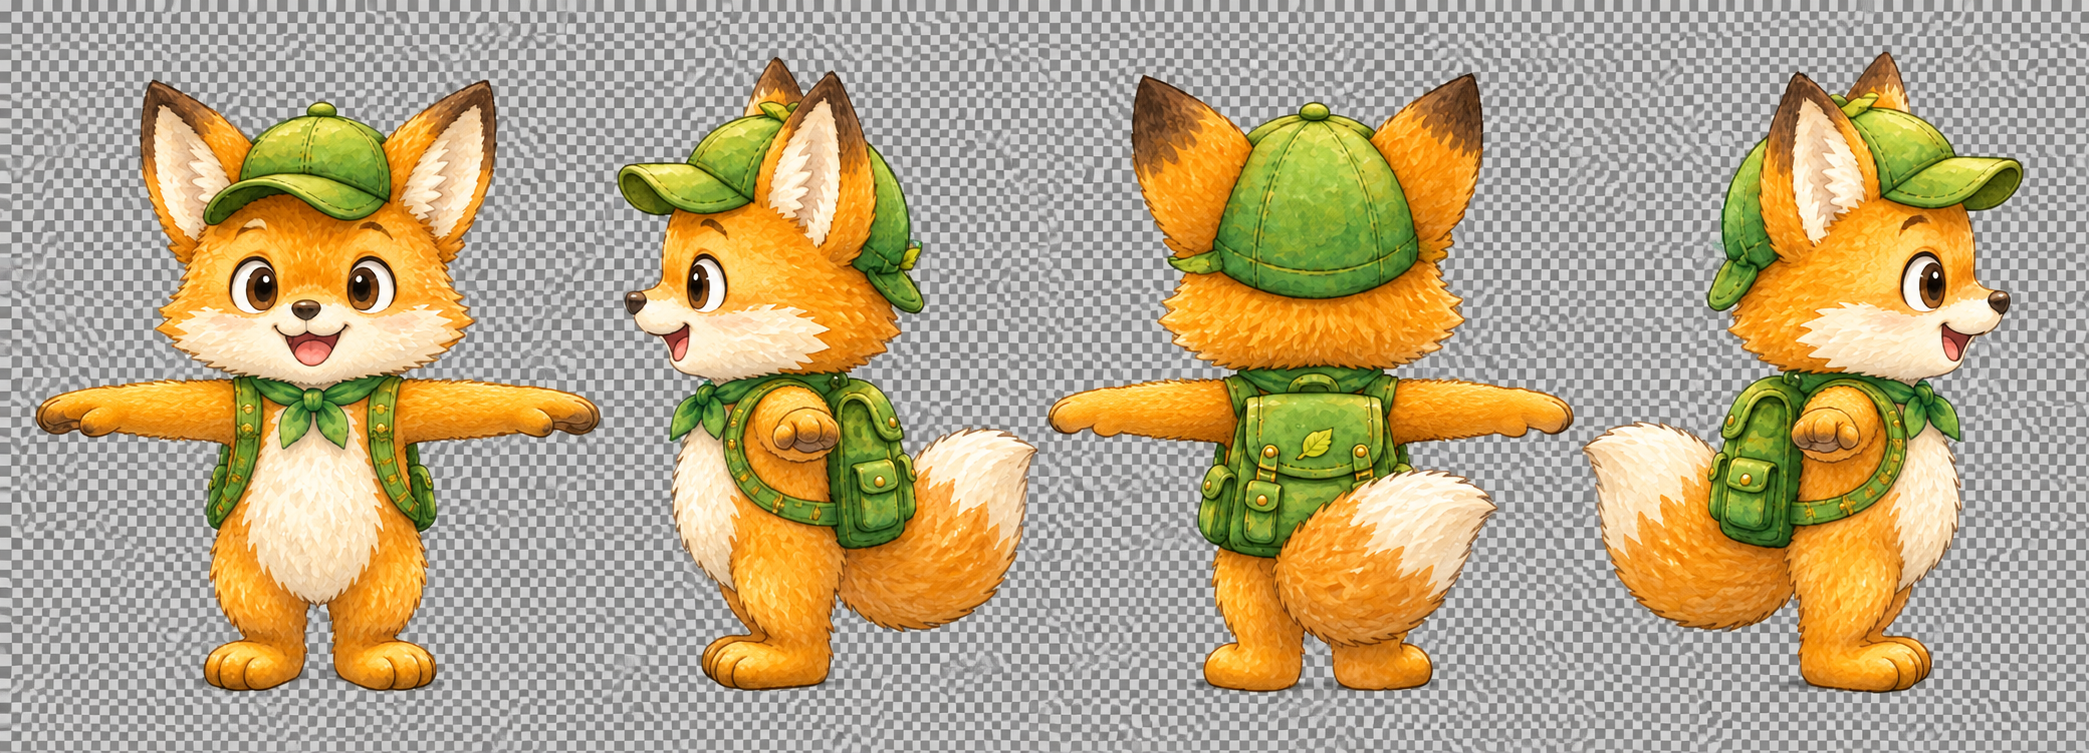
最初に確認したのは、背景の透明化である。
今回使用したのは、以前制作して保存していたコンタの4方向画像である。
重要なのは、この画像がChatGPT上で生成された直後の画像ではないことである。
一度ダウンロードして保存した画像を、あらためてChatGPTへアップロードした。
そして、
キャラクターを維持したまま背景を透明化する
という編集を行った。
結果として、キャラクターの輪郭や細部をおおむね維持したまま、背景を透明化することができた。
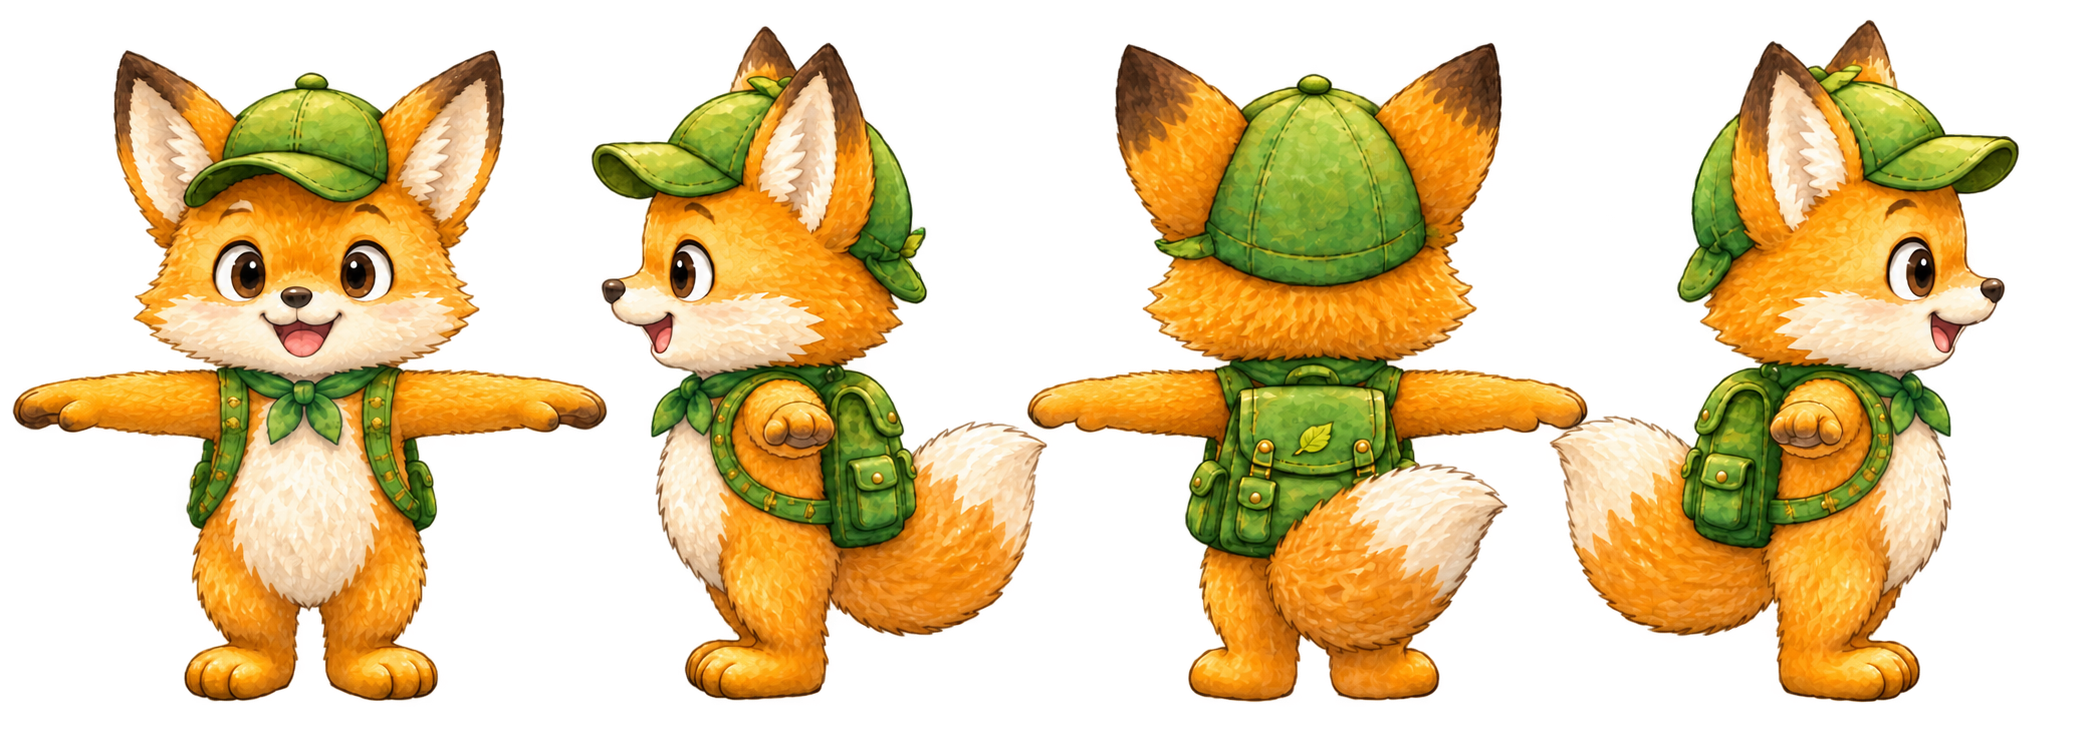 切り抜き精度を確認した結果、ゲーム素材や3Dモデル制作の前処理として使用するには、十分な品質であると判断した。
ただし、今回使用したコンタの画像には、もともと比較的明瞭な輪郭線が存在している。
この輪郭線によって、キャラクターと背景との境界を画像生成AIが認識しやすかった可能性も考えられる。
したがって今回の実験だけから、
どのような画像でも同じ精度で背景を透明化できる
と結論づけることはできない。
今回は背景除去技術そのものを研究することが目的ではないため、輪郭線のない画像や、背景との境界が曖昧な画像を使用した追加実験までは行わなかった。
今回確認できたのは、
少なくとも今回使用したようなキャラクター画像では、一度保存した既存画像であっても、ChatGPTを利用して実用的な品質で背景を透明化できる
ということである。
これは、ゲーム素材や3Dモデル制作のワークフローを簡略化できる可能性を示している。
第2章 完成画像のピクセルサイズ指定
次に、完成画像そのもののサイズを指定できるかを検証した。
使用したのは、パンタの公式4面図である。
これまで使用してきた、
「パンタ Tポーズ・4方向キャラクター設定画 Ver.1.0」
のプロンプトを基本的に維持し、新たに画像サイズの指定を追加した。
指定したサイズは、
横1200px × 縦400px
である。
プロンプトには、単なる構図上の目安ではなく、
完成した画像ファイルそのものを正確に1200×400pxにする
ことを明記した。
比較のため、サイズを指定しない状態でも同じパンタのTポーズ4方向画像を生成した。
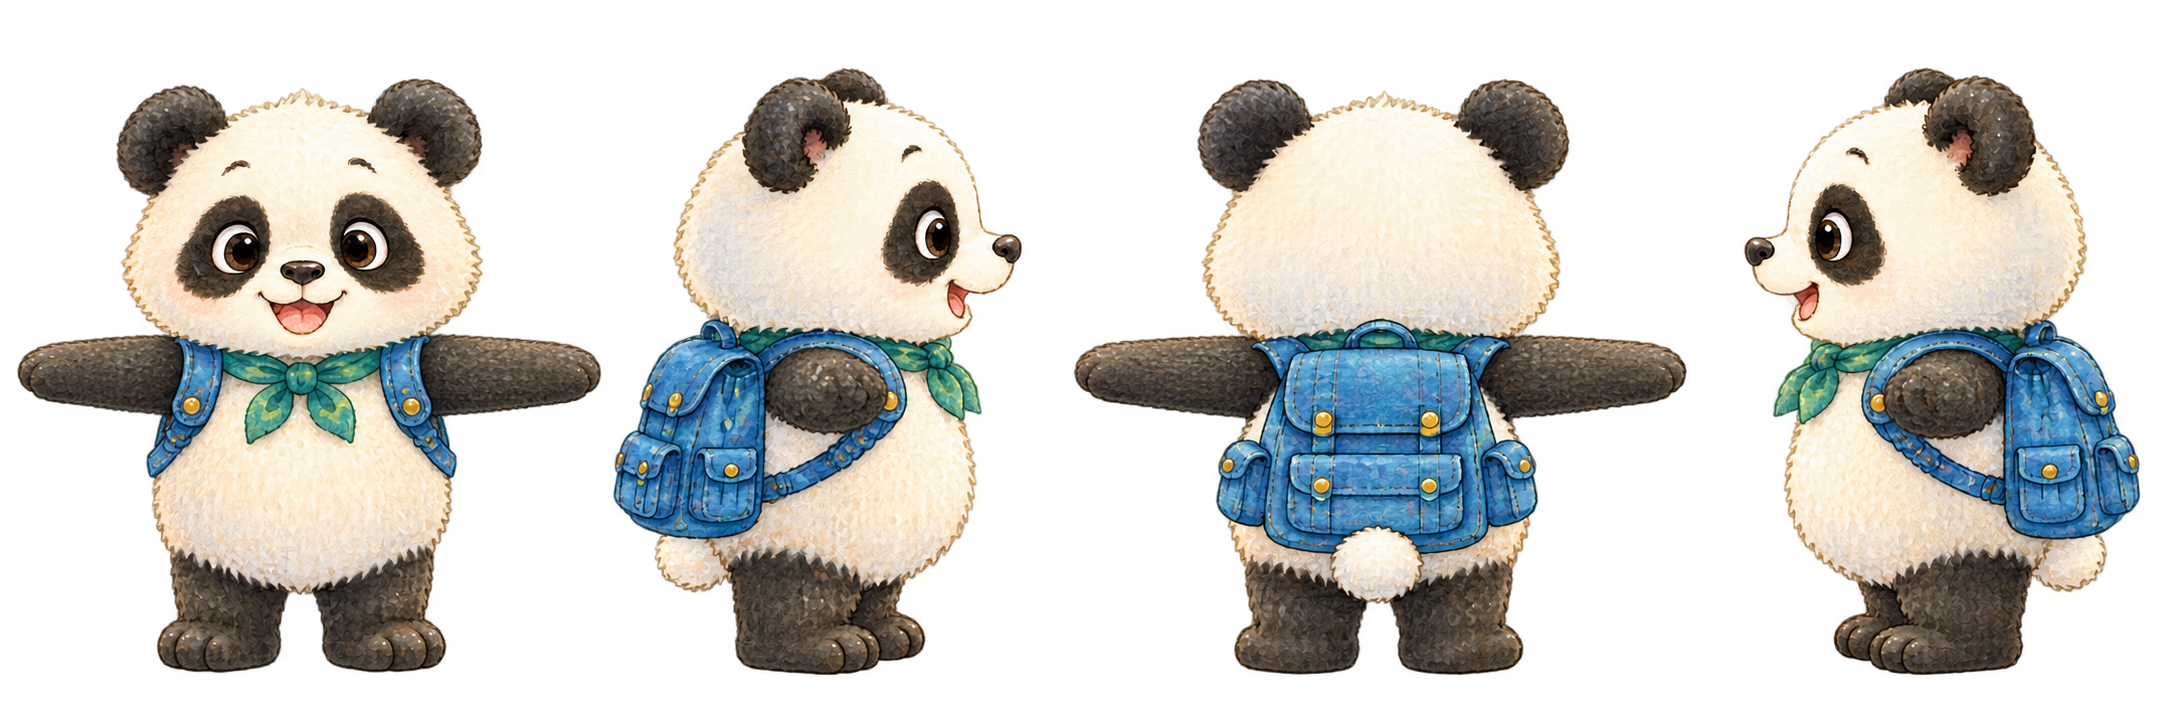
「生成画像:2172×724px」
サイズ指定なしで生成された画像は、
2172×724px
であった。
続いて、
1200×400px
を明示して生成した。
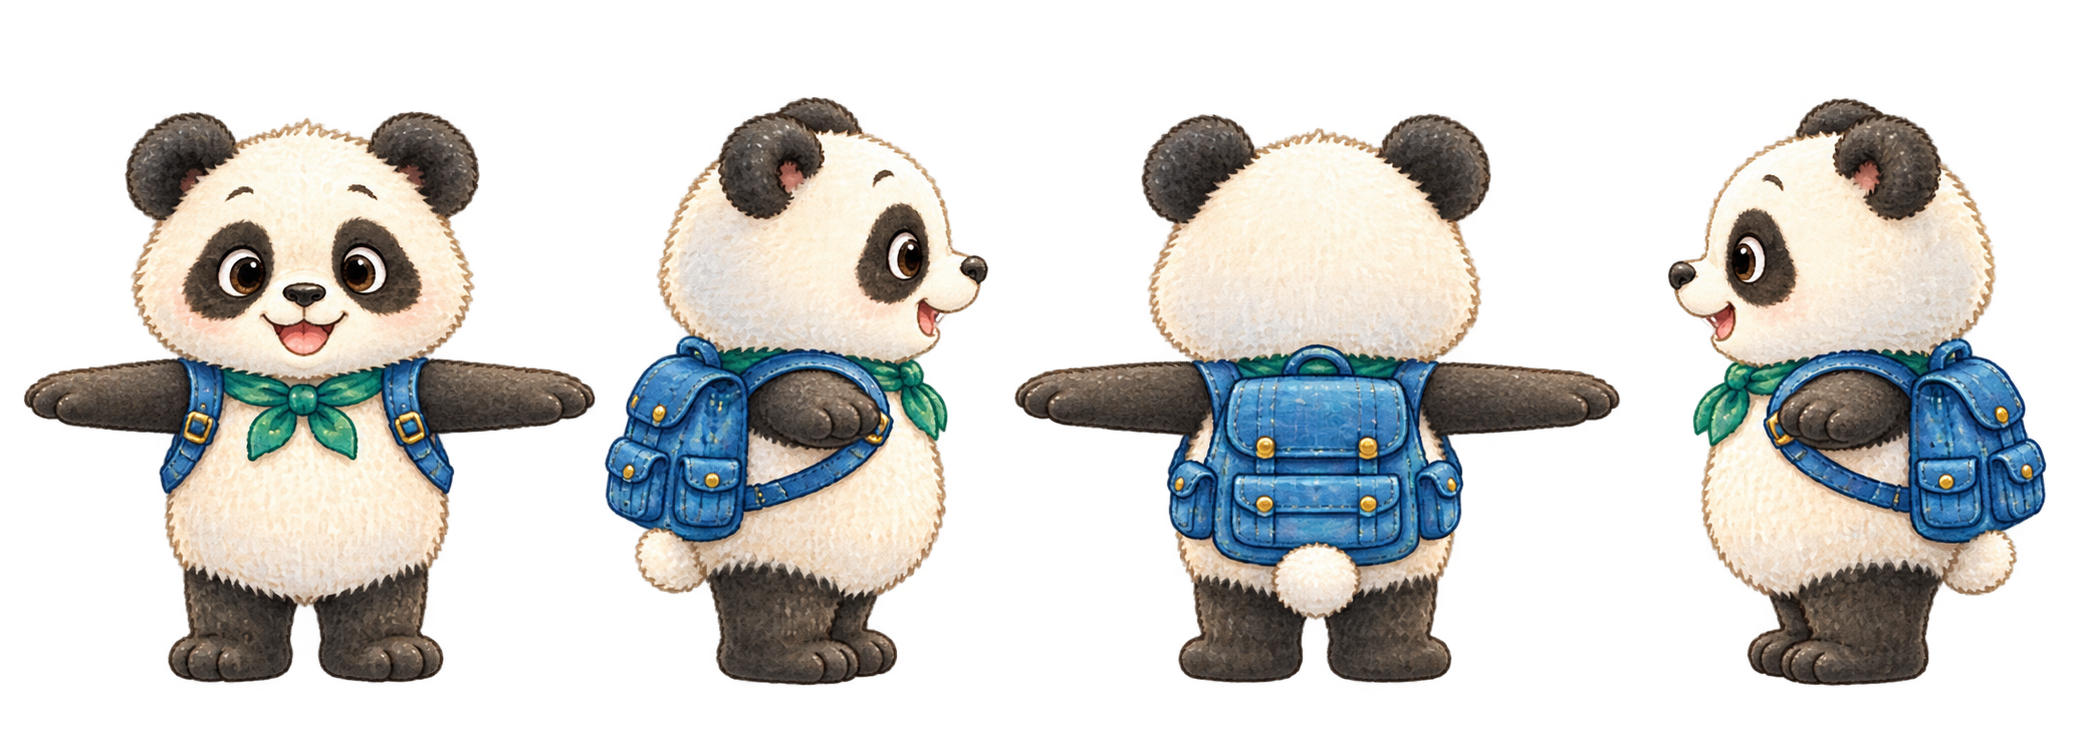
「指定サイズ:1200×400px 実際の生成サイズ:2089×753px」
生成された画像を保存し、実際のピクセルサイズを確認した結果、
2089×753px
であった。
指定した1200×400pxとは大きく異なっている。
したがって今回の実験では、
プロンプト本文に完成画像のピクセル寸法を明記しても、完成ファイルをその寸法に正確に制御することはできなかった。
と判断した。
ここで重要なのは、画像が「横長に見えるか」「指定した構図に近いか」ではない。
今回検証しているのは、
完成した画像ファイルそのものが指定したピクセル寸法になっているか
である。
その基準では、画像サイズ指定は成功しなかった。
第3章 キャラクターそのものを250pxにできるか
次に、画像全体ではなく、画像内部に描かれるキャラクターそのもののサイズを指定する実験を行った。
これは本研究において、以前から何度も検証してきた課題である。
ゲーム素材を制作する場合、
キャラクターの身長を250pxにする
といった正確なサイズ指定が可能になれば、そのままゲーム用素材として利用できる可能性がある。
しかし、これまでの画像生成実験では、このような数値指定を正確に反映することはできなかった。
今回は画像生成AIの進化を確認するため、この実験を再度行った。
画像全体のサイズは指定しなかった。
その代わり、パンタの高さを、
耳の最上端から足先の最下端まで=250px
と明確に定義した。
さらに、
正面・右側面・背面・左側面の4体すべてを正確に高さ250pxにする
ことをプロンプト内で繰り返し指定した。
生成後、画像を保存して実際のサイズを計測した。
生成画像全体のサイズは、
2089×753px
であった。
そしてパンタの実際の高さは、
約574px
であった。
「指定したパンタの高さ:250px 実測したパンタの高さ:約574px」
指定した高さは250pxである。
実測値は指定値の約2.3倍となり、単なる数ピクセル程度の誤差ではない。
したがって、
画像内部のキャラクターそのものを、プロンプトによって正確なピクセル寸法に制御することは、今回の再検証でもできなかった。
という結果になった。
第4章 できるようになったこと、できなかったこと
今回の再検証では、画像生成AIの進化を確認できた部分と、以前と同様に正確な制御ができなかった部分の両方が確認された。
まず、大きな変化として確認できたのが、
既存画像の背景透明化
である。
一度保存したキャラクター画像をChatGPTへ再入力し、背景を除去することができた。
今回の画像については、実制作に使用できる十分な品質であった。
一方、数値によるピクセル単位の制御については異なる結果となった。
完成画像を1200×400pxにする。
この指定に対する実際の画像は、
2089×753px
であった。
また、
パンタの高さを250pxにする。
という指定に対しては、
約574px
となった。
したがって今回の実験では、
画像全体の絶対的なピクセルサイズ
および、
画像内部のキャラクターの絶対的なピクセルサイズ
のどちらについても、プロンプトによる正確な数値制御は確認できなかった。
第5章 現在の制作工程を再確認する
今回の結果から、現在の画像生成AIと人間の役割分担を改めて整理することができる。
画像生成AIには、
キャラクター画像の生成
公式画像を参照したデザインの維持
Tポーズへの変更
4方向設定画の制作
既存画像の背景透明化
などを担当させることができる。
一方、
完成画像そのものの正確なピクセルサイズ
キャラクターそのものの正確なピクセルサイズ
ゲーム画面内で使用するための正確な配置位置
などは、現時点では人間が最終調整する必要がある。
これは、本研究でこれまで採用してきた制作方法とも一致する。
AIによって候補となる画像を生成し、人間が採否を判断する。
そして最終的なゲーム素材として使用する段階では、人間が透明キャンバス上でキャラクターの大きさや位置を決定する。
今回の再検証によって、背景透明化についてはAIへ任せられる範囲が広がった。
一方、ピクセル単位の最終調整については、現在も人間が担当するという制作方法が妥当であることを再確認した。
第6章 「できない」という結果も更新される
今回の実験で重要なのは、個々の機能の成否だけではない。
AIを利用した制作では、
一度「できない」と確認したことを、永久にできないものとして扱うことはできない。
ということである。
画像生成AIは急速に変化している。
以前できなかった機能が、モデルやシステムの更新によって利用できるようになる可能性がある。
今回、背景透明化については実制作に利用できる可能性を確認できた。
一方、画像サイズやキャラクターサイズの正確なピクセル指定については、今回の再検証でも実現できなかった。
つまり、
以前の検証結果には、現在も有効なものと、更新する必要があるものが存在する。
AIを使用したゲーム開発では、この違いを継続的に確認していく必要がある。
第7章 AI時代の制作標準は変化し続ける
従来の制作マニュアルでは、一度確立された工程を標準化し、その方法を繰り返し使用することができた。
しかしAIを中心とした制作環境では、その考え方だけでは十分ではない。
AIそのものが変化するからである。
今日できないことが、次の更新ではできるようになるかもしれない。
逆に、新しい機能が追加されたとしても、実制作で必要とする精度に達しているとは限らない。
そのため、
以前できなかったことを再検証する。
できるようになった機能は制作工程へ取り入れる。
依然としてできない部分は人間が担当する。
そして、その結果に応じて制作ワークフローそのものを更新していく。
これもまた、AI時代のゲーム開発に必要な方法論の一つである。
今回の実験では、背景透明化という新たに実用可能な工程を確認すると同時に、ピクセル単位の数値制御については、これまでの検証結果が現在も有効であることを確認した。
AIの能力を一度評価して終わるのではない。
AIの進化に合わせて、過去の結論そのものを再検証する。
今後もAIの機能に変化が見られた場合には、その都度実際の制作工程の中で検証し、AIゲーム開発の方法論を更新していく。
第13回 キャラクター全員のTポーズ4面図を制作する
AIゲーム開発研究室
3Dモデル制作ドキュメント
第13回 キャラクター全員のTポーズ4面図を制作する
研究代表 大川 博
主任研究員 Arc(ChatGPT)
はじめに
これまでの3Dモデル制作では、パンタを対象として、2Dキャラクターからゲームで使用できる3Dキャラクターを制作する方法を検証してきた。
その過程では、公式4面図からの3D生成、Aポーズ4面図の制作、Tripoによる3Dモデル生成、軽量化、リギング、Mixamoによるアニメーション、Blenderでの確認と修正、Unityへの実装までを実際に行った。
そして、一連の検証を通して、AIを利用した3Dゲームキャラクター制作の基本的な流れを確認することができた。
そこで今回は、その方法をパンタだけの実験で終わらせず、「おむすび山のなかまたち」の他のキャラクターへ展開する。
対象となるのは、コンタ、リン、ミミ、ポンの4人である。
さらに最後に、すでにAポーズ版を制作しているパンタについても、新たにTポーズ4面図を制作する。
今回の目的は、新しい制作方法を一から探すことではない。
パンタの制作で得られた方法を、他のキャラクターにも利用できるのか。
実際のキャラクター制作を通して確認していく。
1 公式4面図からTポーズ4面図を制作する
今回も、新しくキャラクターをデザインするのではない。
すでにゲーム、絵本、イラストなどで共通して使用している、それぞれのキャラクター公式4面図を基準画像として使用する。
公式4面図には、正面、右側面、背面、左側面のキャラクター情報が存在している。
ただし、これらはもともと3Dモデル生成専用の設計図として制作したものではない。
キャラクターの公式デザインを確定するために制作した画像であり、腕も通常の自然なポーズになっている。
そのため今回は、キャラクターの顔、体形、装備品、色彩、画風などを維持したまま、腕だけを左右へ水平に伸ばしたTポーズへ変更することにした。
背景は、TripoのMulti-viewへ入力することを前提として完全透明とする。
2 コンタから制作を始める
最初に制作したのはコンタである。
コンタはパンタよりも比較的細身であり、腕と胴体を分離しやすい。
そのため今回はAポーズではなく、両腕を水平に伸ばすTポーズを採用した。
公式4面図を基準として、顔、耳、毛並み、緑色の帽子、スカーフ、リュック、大きな尻尾などを維持したまま、4方向すべてをTポーズへ変更するよう画像生成AIへ指示した。
最初の生成では、キャラクターそのものは非常によくできていた。
しかし、背景が完全透明になっていなかった。
そこでキャラクターに関する指示を大きく変更するのではなく、透明背景についての指示を強化して再生成した。
その結果、公式デザインをほぼ維持したTポーズ4面図を制作することができた。
ここで、以後のキャラクターにも利用できる基本的なプロンプト構成ができた。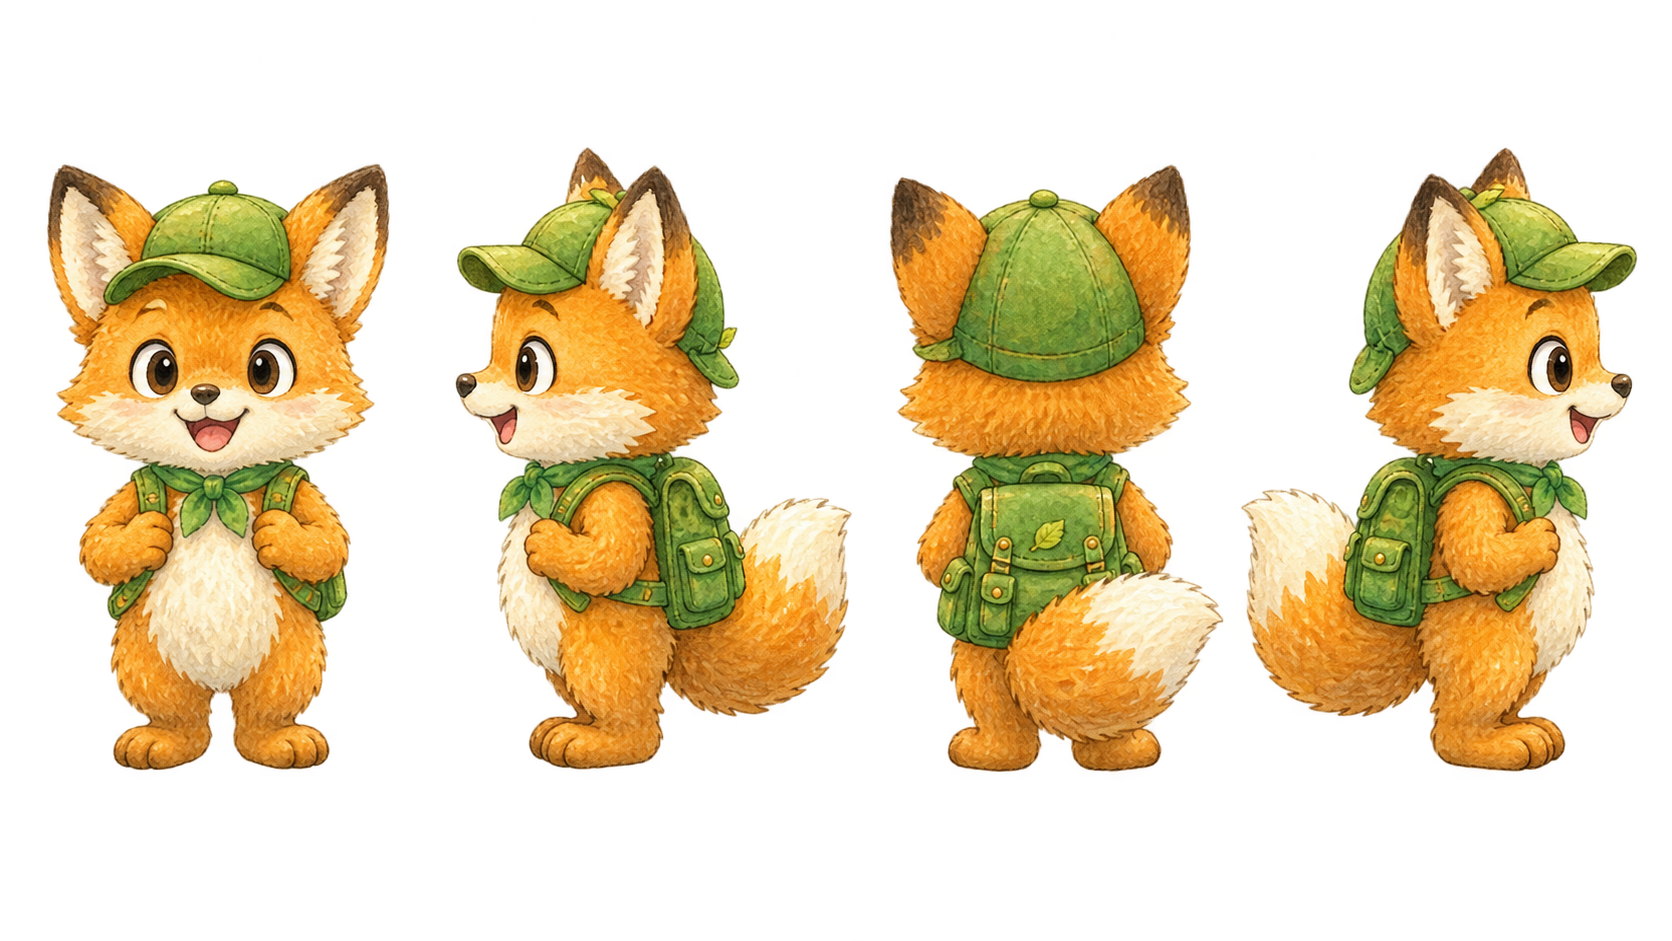
3 リンの大きな尻尾を維持する
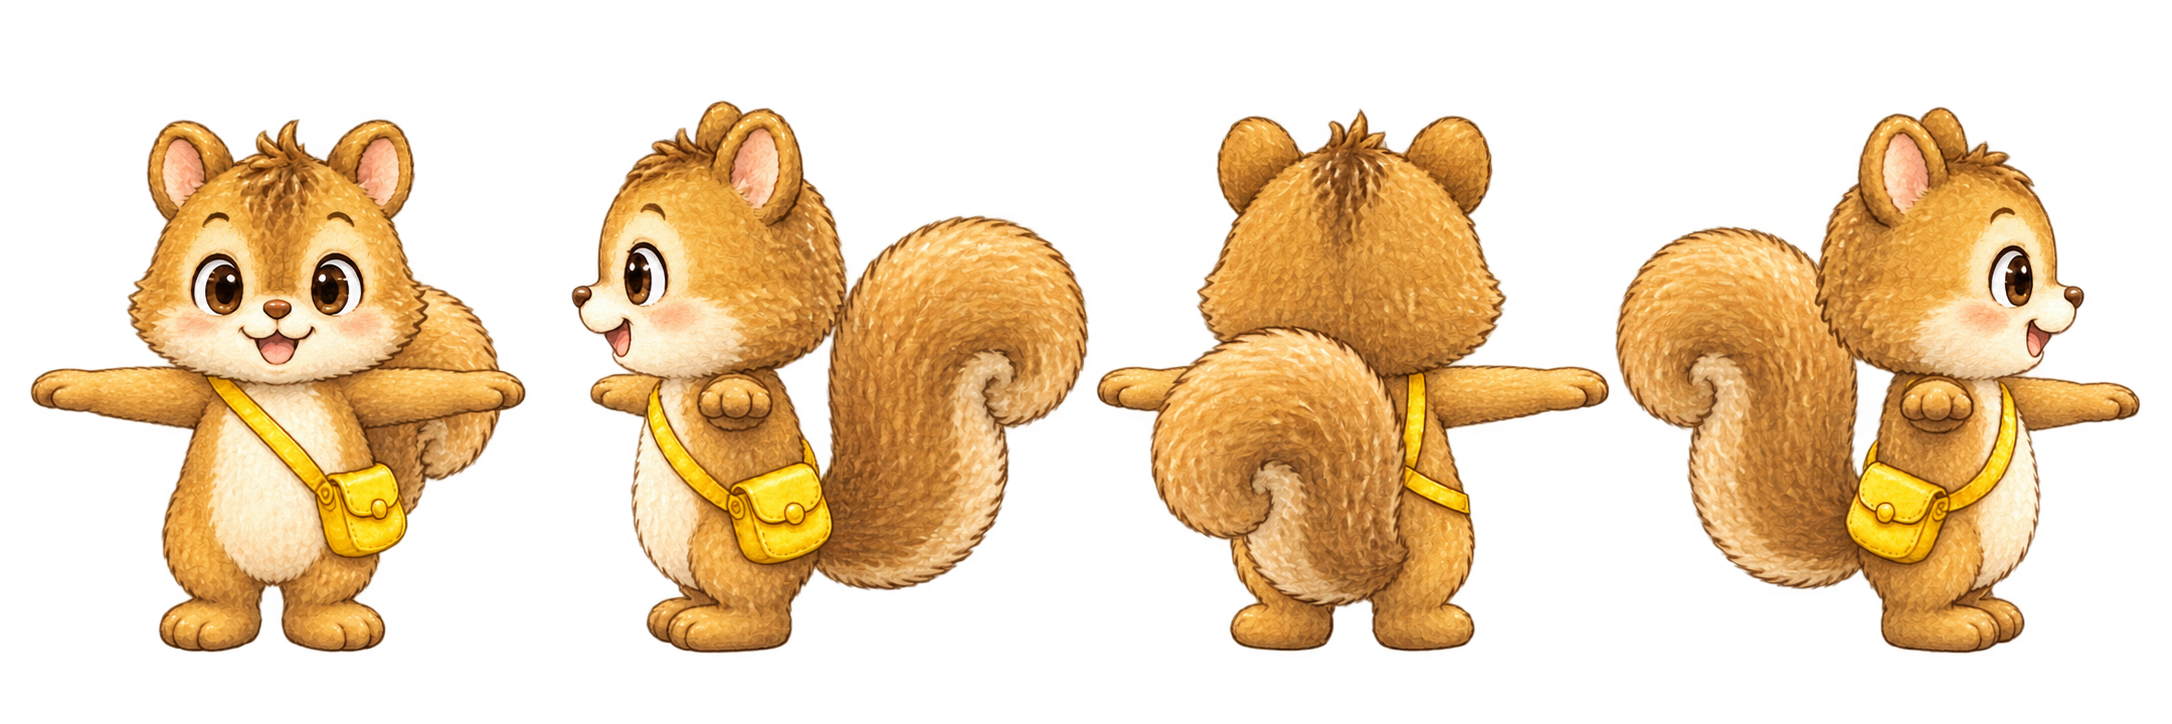
次にリンを制作した。
リンの場合、特に重要なのが大きな尻尾である。
公式4面図では、見る方向によって尻尾の見え方が大きく変化する。
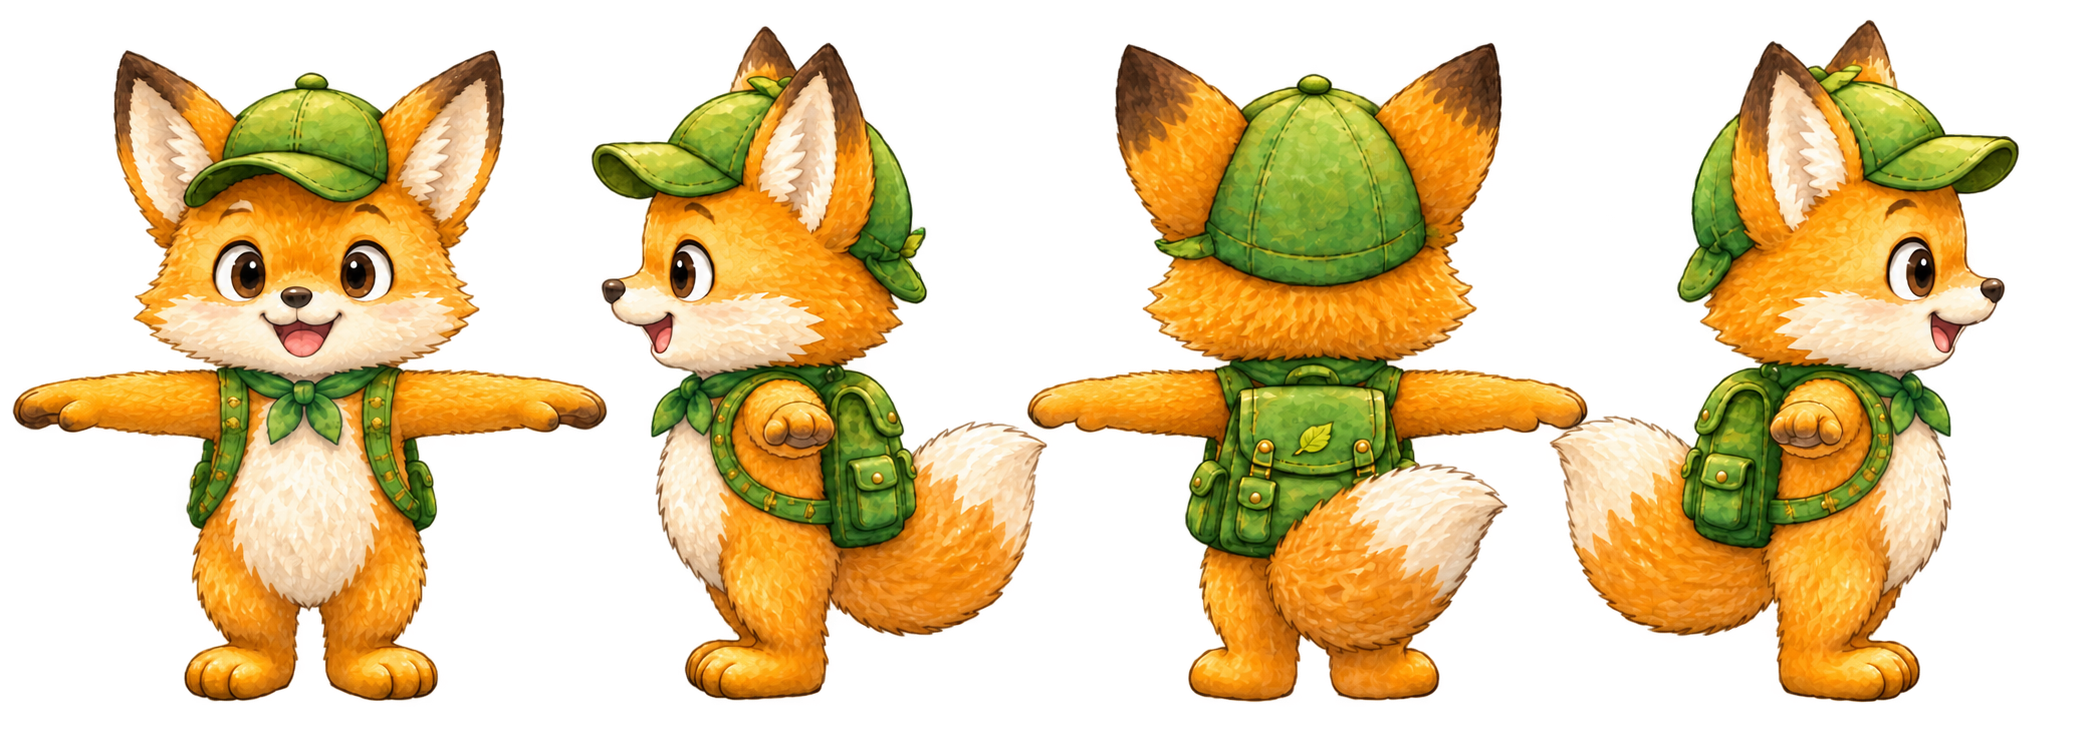
そこで、尻尾の付け根、長さ、太さ、ボリューム、巻き方、カーブ、毛並みを維持し、4方向で同じ一本の尻尾として成立するよう指示した。
また、黄色いポシェットと斜め掛けのストラップも公式デザインを維持した。
生成された画像では、側面図の奥側の腕について完全とは言えない部分が残った。
しかし、今回は画像生成AIだけで製図のような完全一致を追求することを目的とはしなかった。
最終的にこれらの画像を使用するのは、3Dモデル生成を専門とするTripoである。
パンタの実験では、正面画像1枚からでも、描かれていない側面や背面を推測して3Dモデルを生成した。
その経験から、一定の情報が与えられていれば、4方向画像の局所的な違いについてはTripo側の立体解釈に委ねることにした。
リンのTポーズ4面図は、この状態で採用した。
4 服を着たミミをTポーズにする
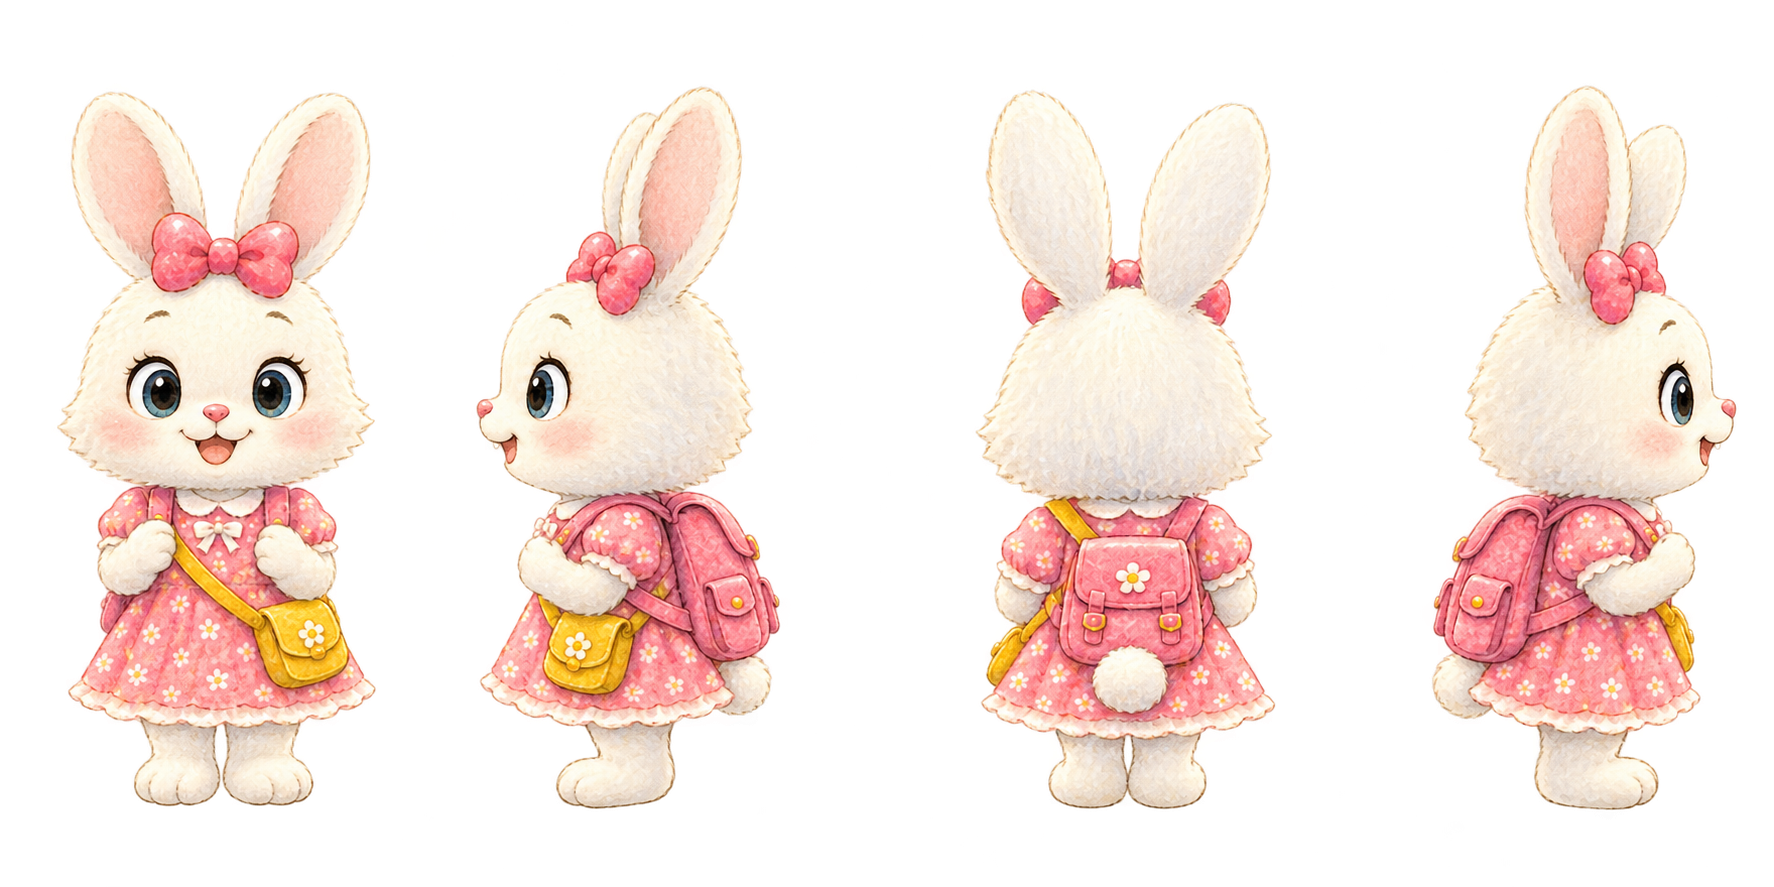
ミミでは、これまでのキャラクターとは少し異なる問題がある。
ミミはピンクの花柄ワンピースを着ている。
さらに、パフスリーブ、黄色いポシェット、ピンクのリュック、頭の大きなリボンを身につけている。
そのため、単純に腕だけを水平へ伸ばすと、肩と袖のデザインが変化する可能性がある。
そこで、Tポーズへ変更してもパフスリーブを維持し、ワンピースの花柄、襟元、胸元のリボン、裾などを変更しないよう明確に指定した。
結果として、衣装を維持したままTポーズへ変更することができた。
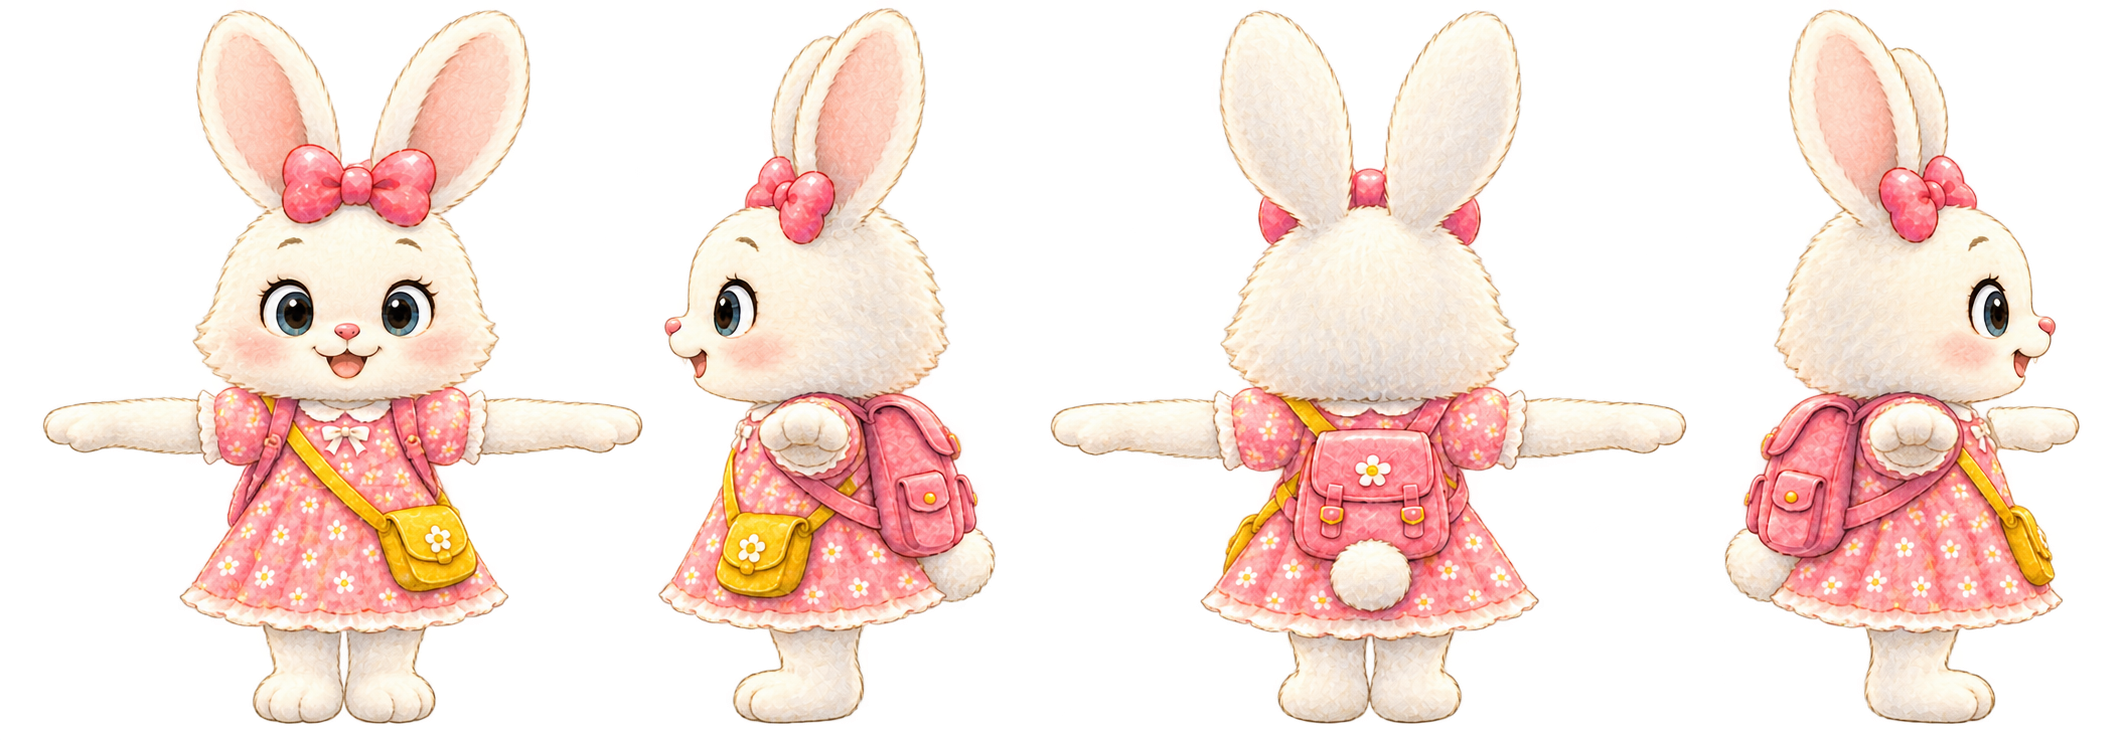
ここで、今回の制作におけるもう一つの重要な実験を行った。
5 同じプロンプトでも同じ画像にはならない
最初に生成されたミミも、十分に使用できる出来だった。
しかし、公式4面図と比較すると、もう少し公式のミミらしいかわいらしさを残せるのではないかと感じた。
ここで、プロンプトを修正することはしなかった。
同じ公式4面図と、まったく同じプロンプトを使用し、別の生成を行った。
すると、基本的な条件は同じでありながら、少し異なるミミが生成された。
二つの結果を比較したところ、後から生成した画像の方が公式デザインに近いと判断し、こちらを採用した。
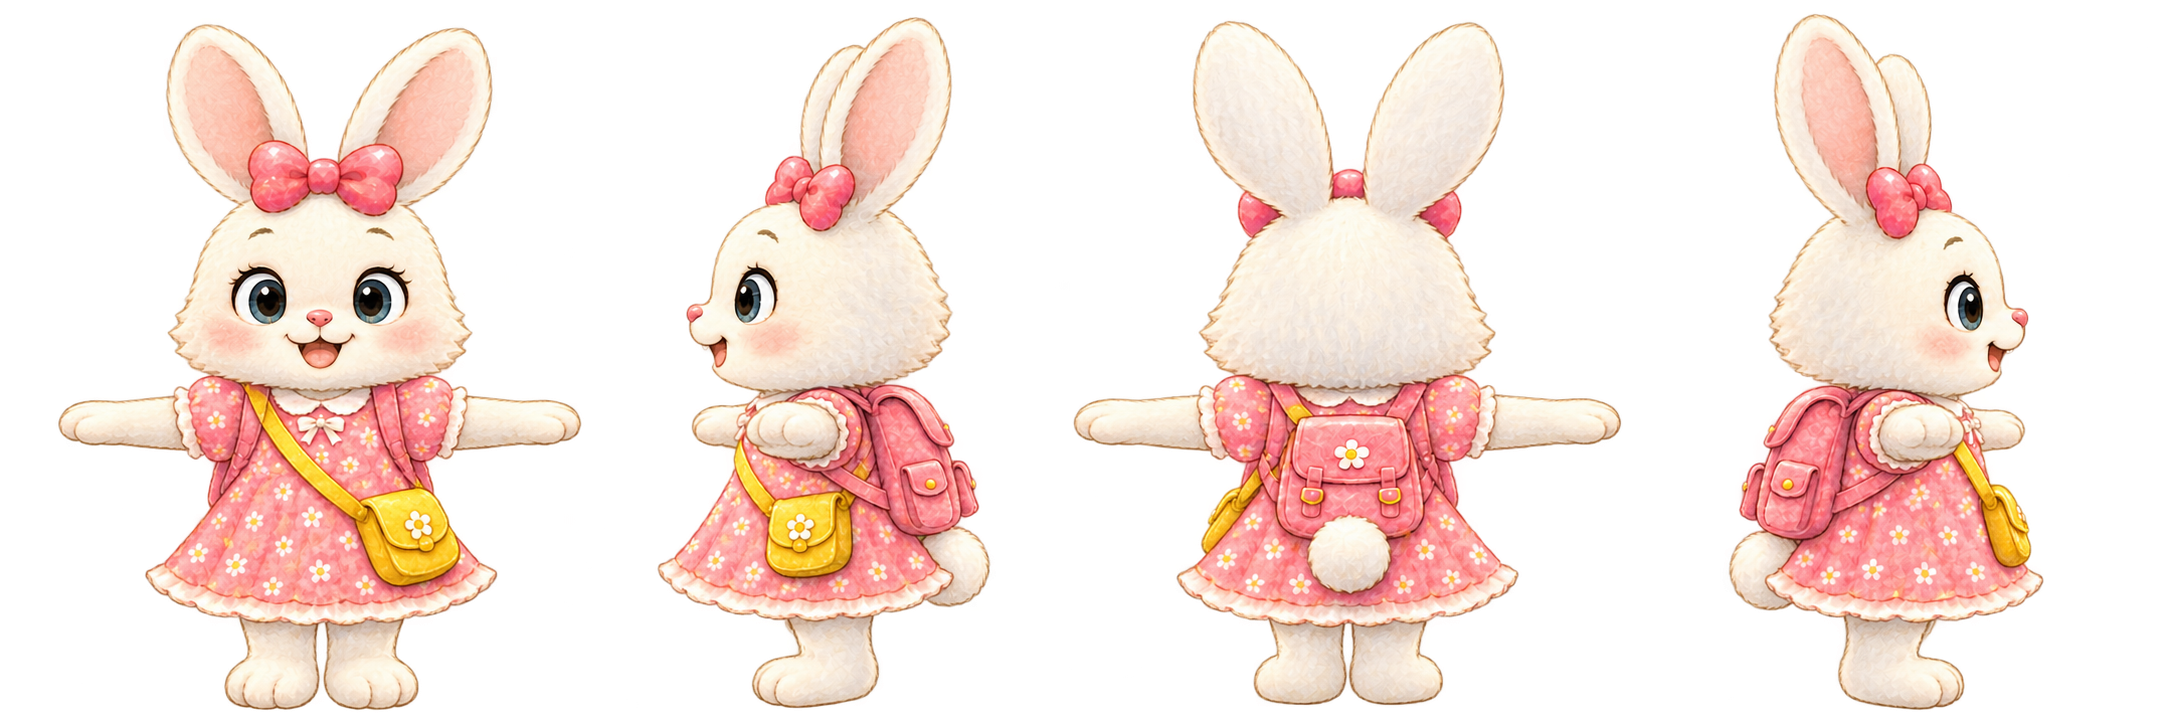
この結果から、画像生成AIを使用するときの新しい制作方法が見えてきた。
これまでは、
生成結果に問題がある
↓
プロンプトを修正する
↓
再生成する
という方法を主に使用してきた。
しかし、プロンプトそのものに問題がない場合、必ずしも修正する必要はない。
基準画像とプロンプトを固定する
↓
同じ条件で複数回生成する
↓
生成された候補を比較する
↓
人間が最も適した画像を選択する
という方法も利用できる。
プロンプトを変更すると、修正したい部分だけでなく、それまで良かった部分まで変化する場合がある。
そのため、プロンプトが十分に完成しているのであれば、条件を変更せず複数の候補を得ることも有効な方法だと考えられる。
6 ポンでは、あえて不整合を残す
次にポンを制作した。
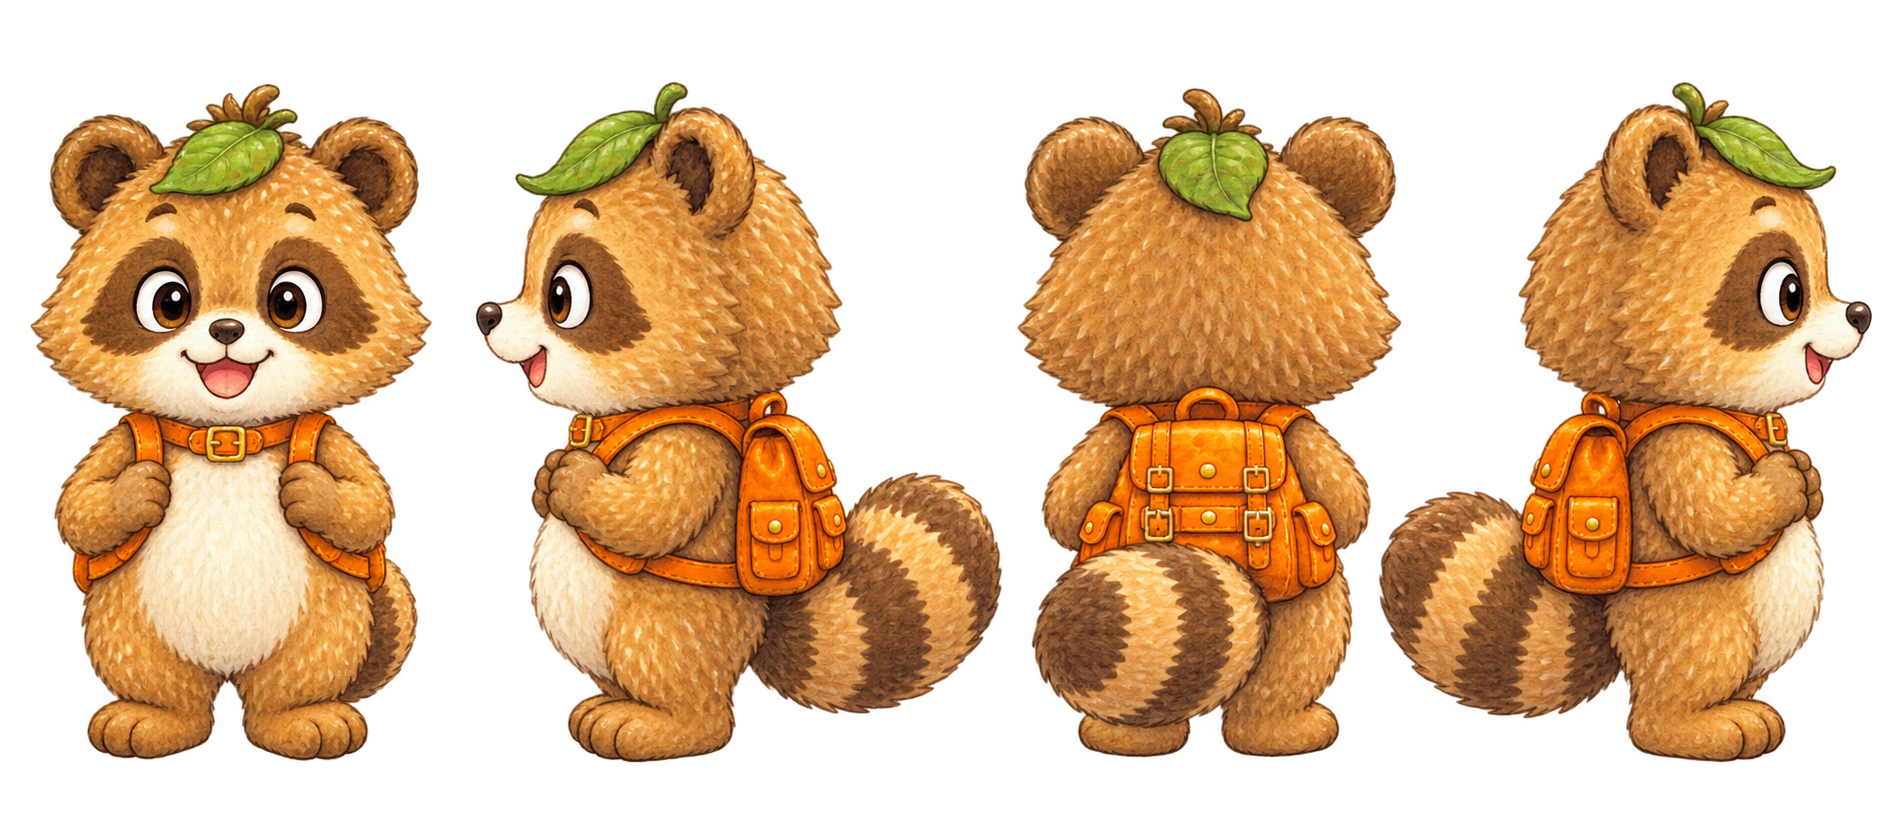
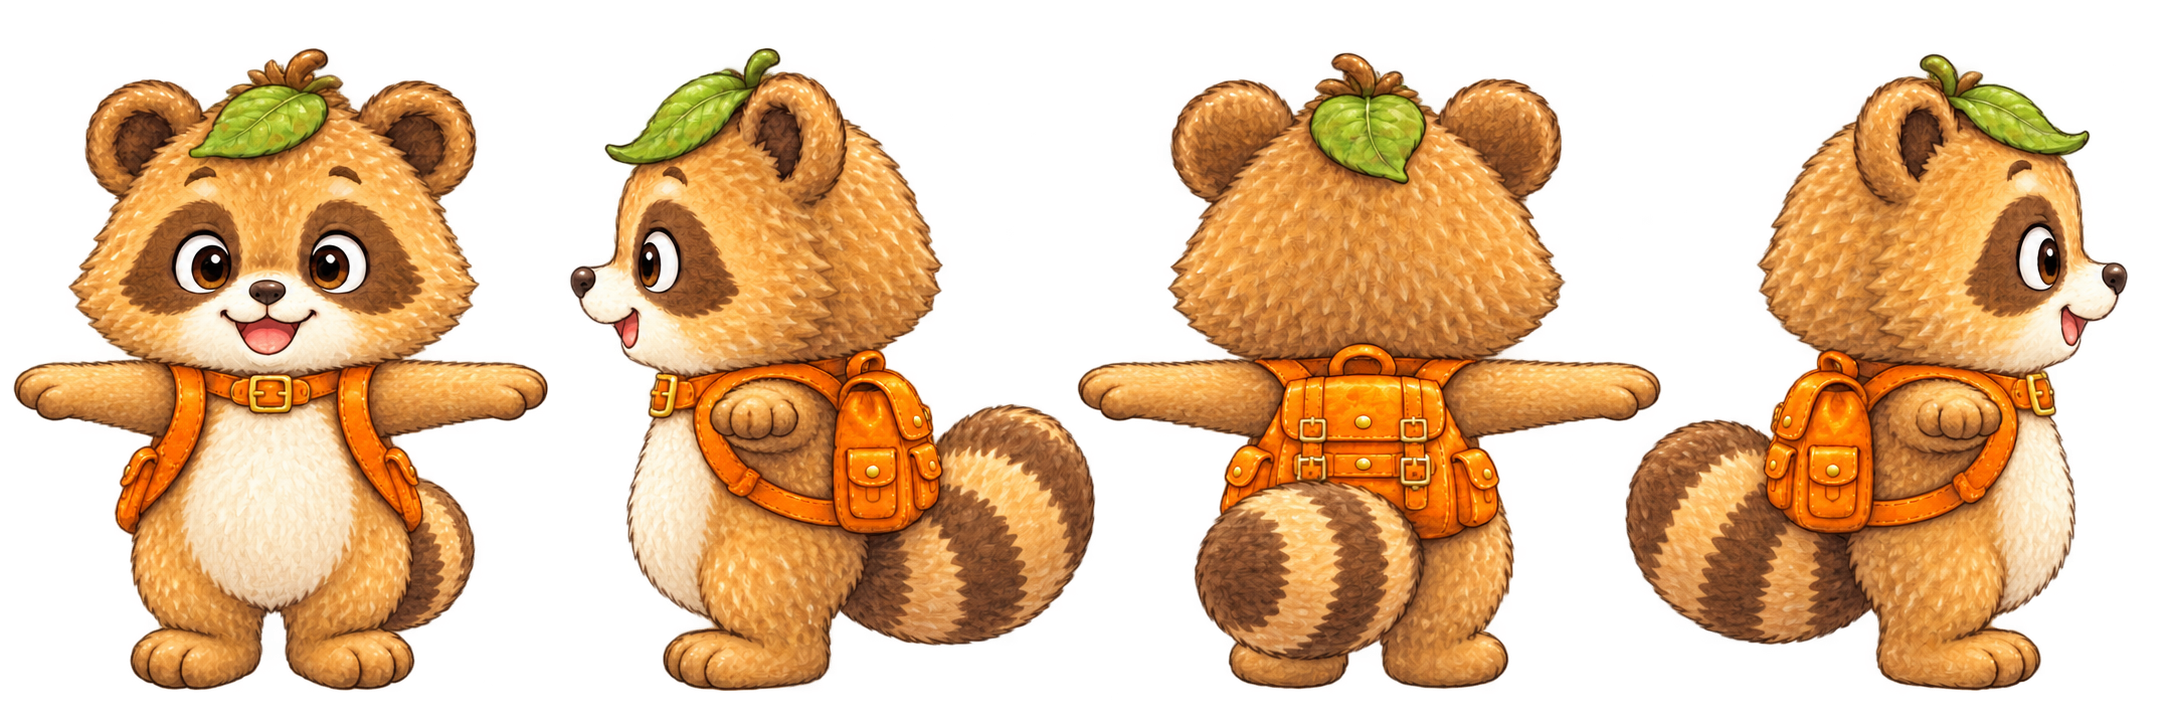
ポンでは、頭の葉っぱ、首輪、オレンジ色のリュック、太い縞模様の尻尾を公式デザインの重要な特徴として維持した。
生成結果は非常に良好だった。
Tポーズも成立しており、顔や体形、リュック、尻尾なども公式デザインの特徴をよく残している。
しかし、一つ問題が見つかった。
正面図と背面図で、頭の葉っぱの見え方に整合していない部分がある。
ここを修正することもできる。
しかし、今回はあえて修正しないことにした。
画像の一部分だけを修正しようとして再生成を繰り返すと、キャラクターの顔や体形、装備品、画風など、すでに良好だった部分まで変化する可能性がある。
また、最終的に4方向の情報を立体として統合するのはTripoである。
そこで今回は、葉っぱに不整合があることを把握したうえで、そのままMulti-viewへ入力することにした。
複数の参照画像に部分的な矛盾が存在するとき、3D生成AIはそれをどのように立体として解釈するのか。
これは、次の3Dモデル生成で確認する項目となる。
7 最後にパンタをTポーズ化する
4人のTポーズ4面図を制作したあと、最後にパンタへ戻ることにした。
パンタでは、これまでAポーズを採用している。
当時は、丸い胴体と短い手足を持つパンタをTポーズへ変更しようとした際、腕が長く見えるなど、プロポーションの問題が発生した。
さらに修正を繰り返すことで、身体が太くなったり、元の柔らかな画風から離れたりする問題も経験している。
そのため最終的にはAポーズ4面図を制作し、そこから3Dモデルを生成した。
しかし今回は状況が違う。
コンタ、リン、ミミ、ポンを制作する中で、Tポーズ4面図を生成するためのプロンプト構成がある程度確立している。
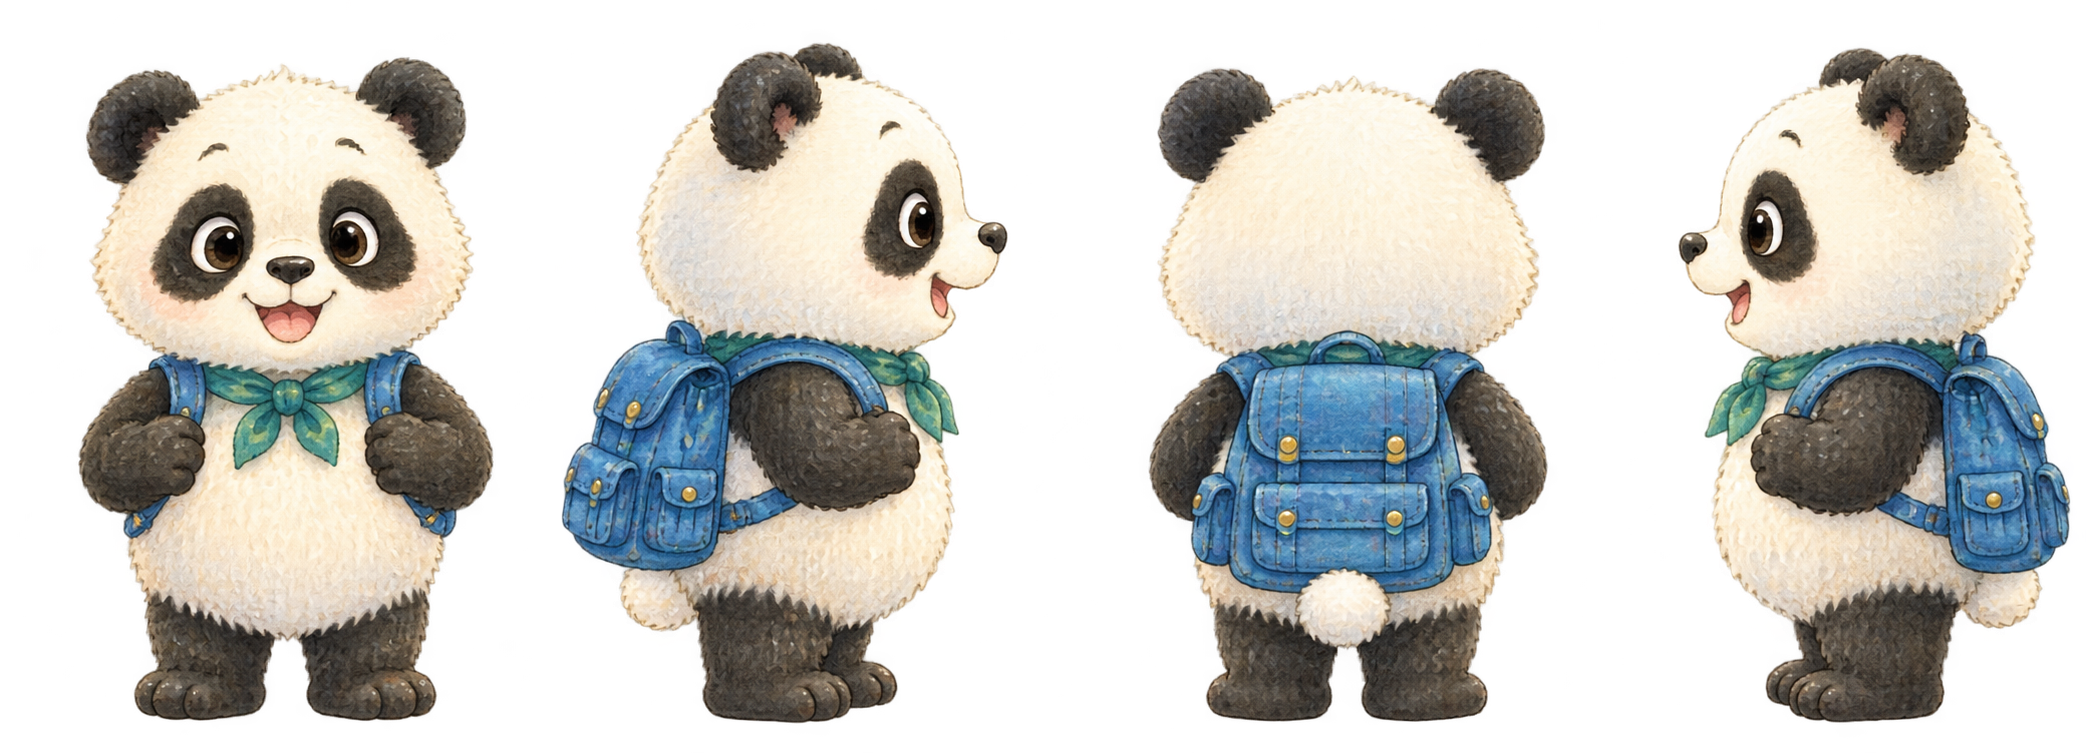
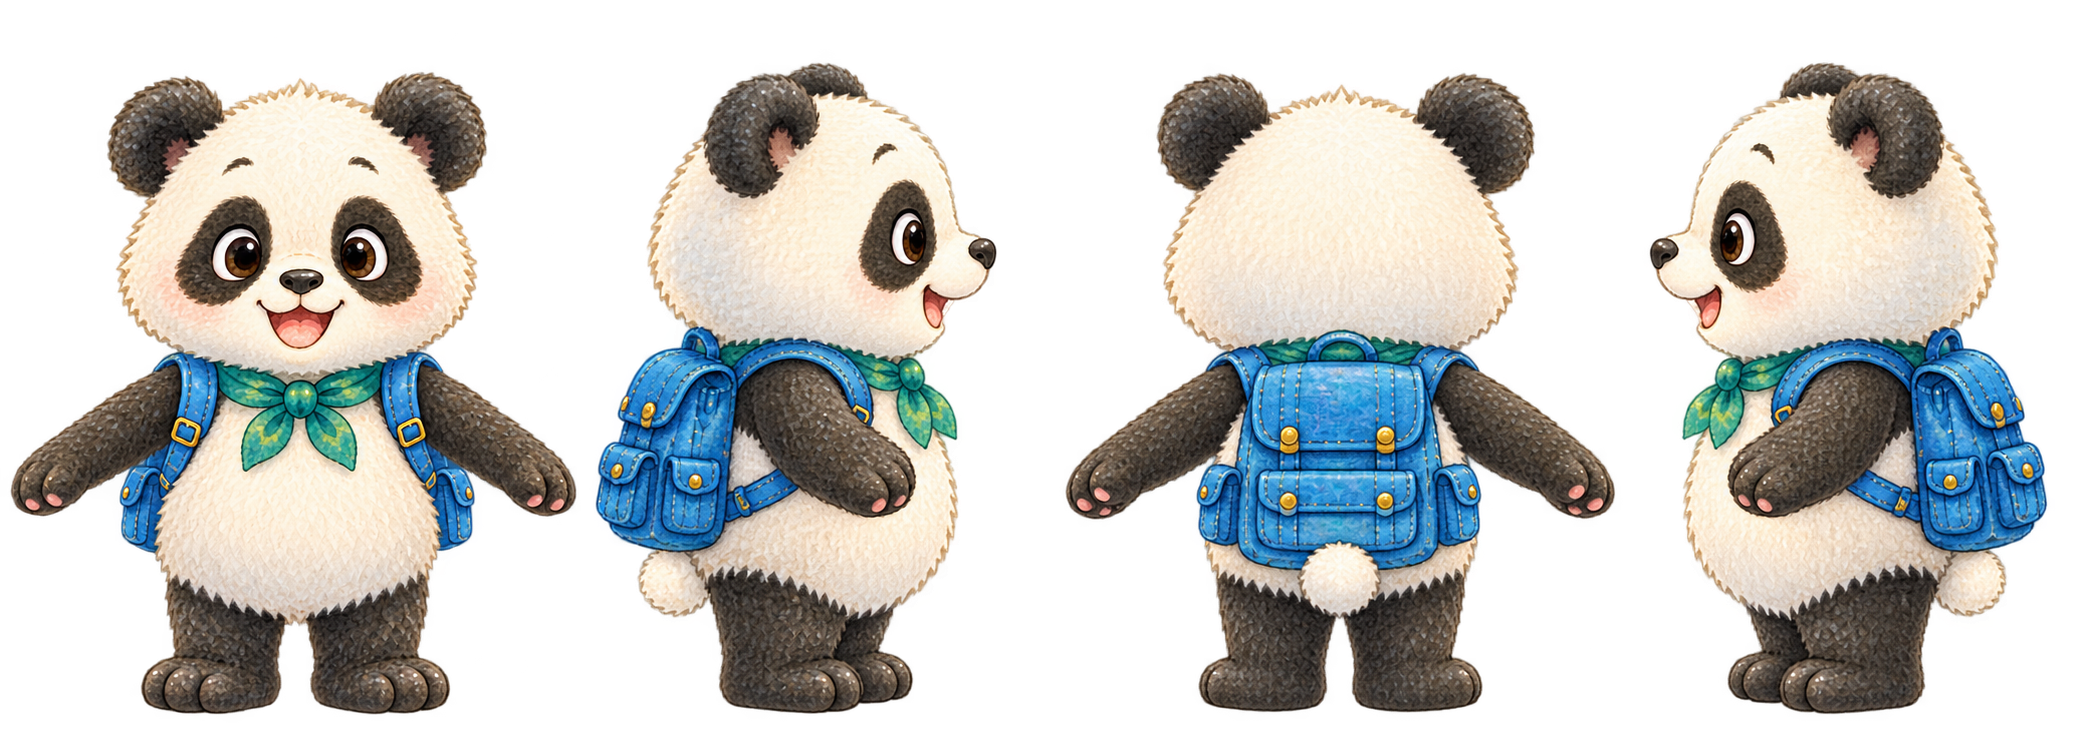
そこで改めてパンタについても、腕を長くしない、頭身を変更しない、胴体の幅を変更しない、短く太い手足を維持することを明確に指定し、Tポーズ4面図を生成した。
その結果、公式パンタの特徴を残したTポーズ4面図を制作することができた。
これによりパンタには、Aポーズ4面図とTポーズ4面図の両方が存在することになった。
今後必要であれば、同一キャラクターを用いてAポーズ入力とTポーズ入力による3D生成結果を比較することもできる。
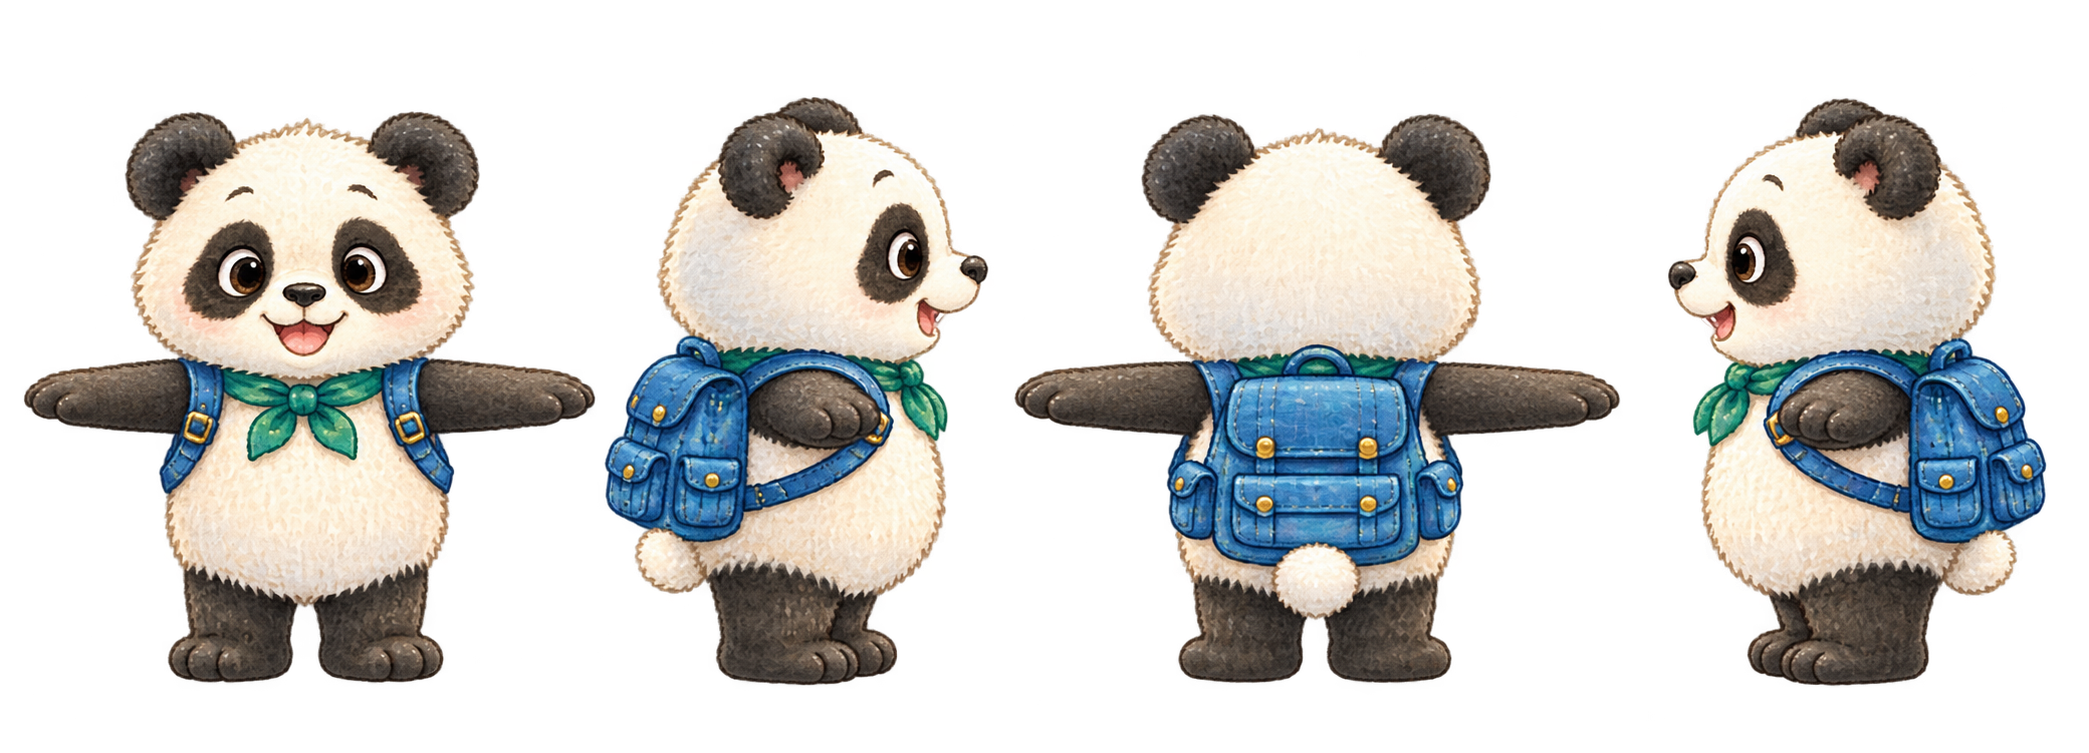
8 今回分かったこと
今回の制作によって、「おむすび山のなかまたち」5人全員について、3Dモデル生成に使用できるTポーズ4面図を用意することができた。
パンタの制作では、一つのキャラクターを3D化するために多くの試行錯誤を行った。
しかし、その過程で得られた経験を利用することで、今回は他のキャラクターへ同じ方法を展開することができた。
一方で、キャラクターによって注意すべき部分は異なる。
コンタでは帽子とリュック、リンでは大きな尻尾、ミミでは衣装、ポンでは葉っぱと縞模様の尻尾、パンタでは丸い体形と短い腕が重要だった。
つまり、すべてのキャラクターへまったく同じ指示を与えるのではなく、
共通する制作条件を固定しながら、キャラクター固有の特徴だけを個別に指定する
という方法が有効だった。
そして今回、もう一つ重要なことが分かった。
良いプロンプトができたあとも、一度の生成結果だけで判断する必要はない。
同じ基準画像、同じプロンプトを使用しても、生成される画像には違いが生じる。
その違いを失敗として扱うのではなく、複数の生成結果を候補として利用し、人間が比較して最も適したものを採用することができる。
これは、画像生成AIを単に「一枚の完成画像を作る道具」として使うのではなく、
複数の制作候補を提示するAIとして利用する
という考え方でもある。
最終的にどの画像を公式素材として使用するのかを決めるのは、人間である。
9 次の工程へ
これで、パンタ、コンタ、リン、ミミ、ポンの5人全員について、Tポーズ4面図が揃った。
しかし、Tポーズ画像が完成したことは、3Dモデルが完成したことではない。
次に確認するのは、これらの画像をTripoのMulti-viewへ入力したとき、どのような3Dモデルが生成されるかである。
特に今回は、キャラクターごとに異なる特徴がある。
コンタとリンの大きな尻尾。
ミミのワンピースと装備品。
ポンの縞模様の尻尾と、正面・背面で完全には一致していない頭の葉っぱ。
そして、パンタのTポーズ版。
画像生成AIが制作した4方向の情報を、3D生成AIであるTripoはどのように一つの立体へまとめるのか。
次回から、5人の3Dモデル制作へ進む。